Workflow ou agente? Cinco padrões para compor LLMs

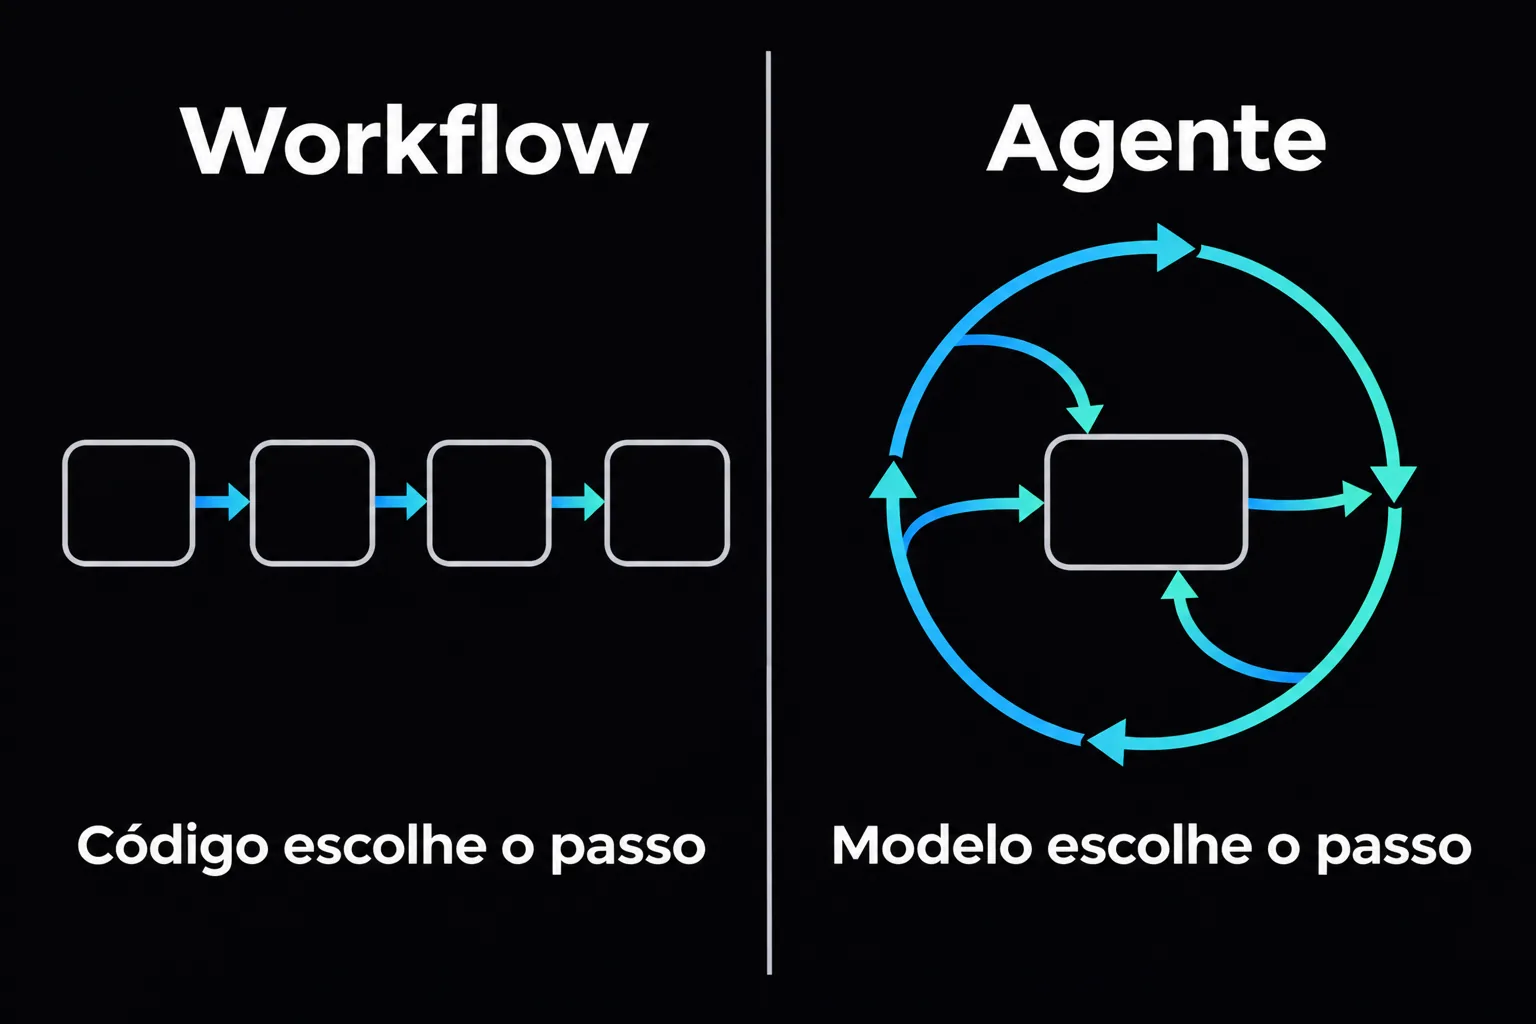
Workflow ou agente: a pergunta aparece cedo em qualquer feature com LLM, e a resposta depende de um detalhe, que é saber quem escolhe o próximo passo. Se quem escolhe é o seu código, você tem um workflow. Se é o modelo, você tem um agente.
É essa a distinção que a Anthropic usa no artigo "Building effective agents", de dezembro de 2024. Para ela, os dois são sistemas agênticos. Em um workflow, LLMs e ferramentas são orquestrados por caminhos de código predefinidos. Em um agente, o LLM dirige o próprio processo e o uso das ferramentas. O artigo relata que, nas dezenas de equipes com que a empresa trabalhou, as implementações mais bem-sucedidas usavam padrões simples e componíveis em vez de frameworks complexos, e descreve cinco desses padrões.
A seguir, os cinco em poucas linhas, três deles combinados em TypeScript e um critério para decidir quando o agente compensa.
Quais são os cinco padrões?
Os cinco são workflows: o caminho fica no código e o LLM é uma das peças. O que muda de um para outro é quanto do caminho você precisa conhecer antes de a entrada chegar.
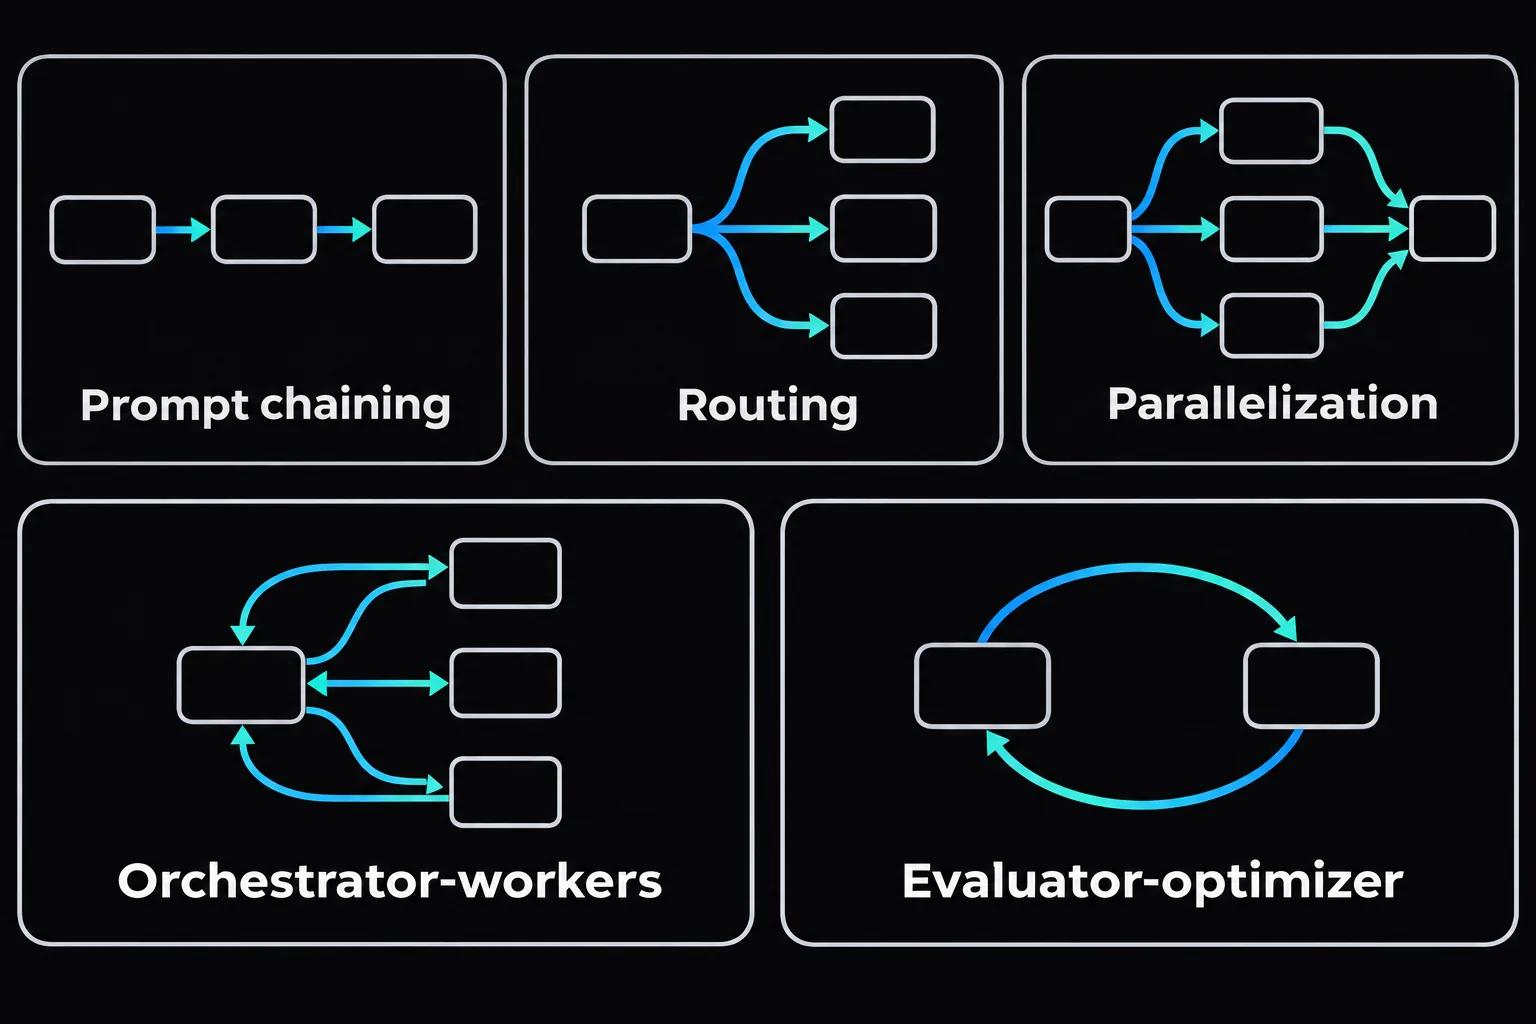
- Prompt chaining: a tarefa vira uma sequência fixa de chamadas, cada uma processando a saída da anterior, com checagens programáticas entre os passos (o artigo chama de gate). Você conhece todos os passos.
- Routing: uma classificação manda a entrada para um tratamento especializado. Você conhece as categorias.
- Parallelization: chamadas rodam ao mesmo tempo e o código agrega o resultado, dividindo a tarefa em partes independentes (sectioning) ou repetindo a mesma tarefa para comparar as respostas (voting). Você conhece as partes, ou aceita pagar pelas repetições.
- Orchestrator-workers: um LLM central quebra a tarefa, delega para workers e sintetiza os resultados. Segundo a Anthropic, a diferença para a parallelization é que as subtarefas não são predefinidas, e sim decididas pelo orquestrador a partir da entrada.
- Evaluator-optimizer: uma chamada gera a resposta e outra avalia e devolve feedback, em loop. O artigo aponta dois sinais de bom encaixe: a resposta melhora de forma demonstrável quando um humano articula o feedback, e o próprio LLM consegue produzir esse feedback.
Antes de qualquer um deles vem a recomendação que abre o artigo: procurar a solução mais simples e só aumentar a complexidade quando for necessário. Sistemas agênticos costumam trocar latência e custo por desempenho na tarefa, e, para muitas aplicações, uma única chamada otimizada, com retrieval e exemplos no contexto, já basta.
Como fica um workflow em código?
Três desses padrões cabem juntos num problema comum: receber os pull requests mergeados de uma versão e gerar as notas de release para o usuário final, sem esquecer nenhum PR relevante.
O tipo Llm esconde o SDK de propósito. A Anthropic sugere começar pelas APIs de LLM diretamente, porque muitos padrões cabem em poucas linhas, e alerta que frameworks podem esconder os prompts e as respostas atrás de camadas de abstração, o que dificulta a depuração.
export type Llm = (prompt: string) => Promise<string>;

type PullRequest = { numero: number; titulo: string; descricao: string; labels: string[] };
type Tipo = "novidade" | "correcao" | "interno";
type Item = { pr: PullRequest; tipo: Tipo };

// Routing: label resolve em código; o LLM só classifica o que sobra
async function rotear(llm: Llm, pr: PullRequest): Promise<Tipo> {
  if (pr.labels.includes("chore") || pr.labels.includes("deps")) return "interno";
  if (pr.labels.includes("bug")) return "correcao";
  if (pr.labels.includes("feature")) return "novidade";

  const tipo = (
    await llm(`Classifique o PR. Responda só: novidade, correcao ou interno.\n${pr.titulo}\n${pr.descricao}`)
  ).trim();
  if (tipo === "novidade" || tipo === "correcao" || tipo === "interno") return tipo;
  throw new Error(`PR #${pr.numero}: classificação inválida "${tipo}"`);
}

// Parallelization (sectioning): cada PR é independente
async function resumir(llm: Llm, itens: Item[]): Promise<string[]> {
  return Promise.all(
    itens.map(async ({ pr, tipo }) => {
      const frase = await llm(`Em uma frase, para o usuário final, o que mudou?\n${pr.titulo}\n${pr.descricao}`);
      return `#${pr.numero} (${tipo}): ${frase.trim()}`;
    }),
  );
}

// Verificador em código: todo PR visível precisa aparecer como #número
function ausentes(notas: string, itens: Item[]): number[] {
  return itens.filter(({ pr }) => !new RegExp(`#${pr.numero}\\b`).test(notas)).map(({ pr }) => pr.numero);
}

// Prompt chaining: classificar -> resumir -> redigir -> conferir
export async function notasDeRelease(llm: Llm, prs: PullRequest[], maxRodadas = 2): Promise<string> {
  const itens = await Promise.all(prs.map(async (pr): Promise<Item> => ({ pr, tipo: await rotear(llm, pr) })));
  const visiveis = itens.filter((item) => item.tipo !== "interno");
  const resumos = await resumir(llm, visiveis);

  let notas = await llm(`Escreva as notas de release em duas seções, novidades e correções. Cite cada PR como #numero.\n${resumos.join("\n")}`);

  for (let rodada = 0; ; rodada++) {
    const faltando = ausentes(notas, visiveis);
    if (faltando.length === 0) return notas;
    if (rodada === maxRodadas) throw new Error(`Notas sem ${faltando.join(", ")} após ${maxRodadas} correções`);
    notas = await llm(`Estas notas esqueceram ${faltando.map((n) => `#${n}`).join(", ")}. Inclua sem apagar o resto.\n\n${notas}\n\nResumos:\n${resumos.join("\n")}`);
  }
}
rotear é routing com uma escolha de custo: PR com label resolve num if, sem gastar token, e o LLM só classifica os PRs sem label. Uma resposta fora das três categorias interrompe a geração, porque esconder um PR das notas por erro de classificação é pior do que parar e avisar.
resumir é parallelization por sectioning. Cada PR é independente dos outros, então os resumos rodam juntos com Promise.all.
A função notasDeRelease é um prompt chaining: classificar, resumir, redigir e conferir, sempre nessa ordem.
O loop do fim é um evaluator-optimizer em que o avaliador é uma função comum. O critério de pronto ("todo PR visível aparece como #número") dá para verificar em código, e aí não há motivo para pagar outro LLM para julgar. Sempre que existe um critério assim, como um teste que passa, um schema que valida ou um link que responde, ele sai mais barato e mais previsível do que um prompt avaliador. O avaliador LLM fica para quando a qualidade é subjetiva, como no exemplo de tradução literária que o artigo usa.
O modelo não escolhe nenhum passo desse código. Ele escreve texto e classifica, mas a ordem das chamadas, quantas são e quando parar estão no seu código. Por isso cada função ganha um teste de unidade com um Llm falso que devolve respostas fixas (sobre o papel desses testes, veja Por que os testes automatizados são tão importantes?).
Onde começam o orquestrador e o agente?
Agora mude a tarefa para migrar todas as chamadas de uma API depreciada num monorepo. Quais pacotes mudam depende do código, e você só descobre lendo. Esse é o terreno do orchestrator-workers. Um LLM gera o plano, com a lista de pacotes e o que muda em cada um, o seu código valida esse plano e dispara um worker por item. O modelo decide a forma do trabalho uma vez, no começo, e o resto segue no código.
O agente aparece quando nem o plano dá para fixar no começo, porque o próximo passo depende do resultado do anterior. Investigar por que a versão nova quebrou o checkout funciona assim: o que você abre depois de ler o log depende do que o log disse. A Anthropic descreve os agentes como LLMs usando ferramentas com base no retorno do ambiente, em loop, indicados para problemas abertos em que é difícil ou impossível prever o número de passos. No código, a diferença está em quem devolve o próximo passo.
type Acao = { tipo: "usar"; ferramenta: string; entrada: string } | { tipo: "responder"; texto: string };
type Ferramenta = (entrada: string) => Promise<string>;

// Agente: o modelo escolhe o próximo passo a cada volta
export async function agente(
  proximoPasso: (historico: string[]) => Promise<Acao>,
  ferramentas: Record<string, Ferramenta>,
  objetivo: string,
  maxPassos = 15,
): Promise<string> {
  const historico = [objetivo];

  for (let passo = 0; passo < maxPassos; passo++) {
    const acao = await proximoPasso(historico);
    if (acao.tipo === "responder") return acao.texto;

    const ferramenta = ferramentas[acao.ferramenta];
    const resultado = ferramenta ? await ferramenta(acao.entrada) : `ferramenta inexistente: ${acao.ferramenta}`;
    historico.push(`${acao.ferramenta}(${acao.entrada}) -> ${resultado}`);
  }
  throw new Error(`Sem resposta em ${maxPassos} passos`);
}
proximoPasso encapsula a chamada ao modelo com as ferramentas disponíveis, e é ele quem decide se a próxima volta lê um log, consulta um deploy ou responde. O maxPassos existe porque essa autonomia tem preço. O artigo cita custo maior e a possibilidade de erros que se acumulam, recomenda testes extensos em ambiente isolado (sandbox) com guardrails e menciona condições de parada, como um número máximo de iterações, para manter o controle. Como o agente é basicamente esse loop, o artigo considera crucial desenhar com cuidado as ferramentas e a documentação delas.
Workflow ou agente: como decidir?
Dá para reduzir a escolha a quatro perguntas, nessa ordem.
- Você consegue escrever a sequência de passos antes de ver a entrada? Se sim, fique nos workflows fixos, chain, routing e parallelization, combinados como no exemplo das notas de release.
- Se a sequência depende da entrada, ela pode ser decidida uma vez, no início? Então use orchestrator-workers e valide o plano em código antes de executar. Se o próximo passo só existe depois de ver o resultado do anterior, você entrou no território do agente.
- Dá para checar o resultado sem outro LLM? Se dá, o loop de correção fica em código. Se não dá, um LLM avaliador ajuda, sempre com limite de rodadas, porque um avaliador que nunca aprova deixa o custo crescendo.
- Quanto custa um passo errado? Se o loop pode cobrar um cartão, mandar um e-mail ou apagar um dado, essas ações ficam fora do alcance do modelo ou atrás de aprovação humana. A Anthropic prevê agentes que pausam para feedback humano em checkpoints, e a lógica é a mesma.
O guia prático da OpenAI para construir agentes ajuda a calibrar a segunda pergunta. Ele indica agentes para fluxos com decisões cheias de exceções e de julgamento, regras que ficaram difíceis de manter ou forte dependência de dados não estruturados, e diz que, fora disso, uma solução determinística pode bastar. Dado não estruturado, sozinho, já se resolve com uma chamada de LLM dentro de um workflow, como a classificação dos PRs sem label. O agente se justifica quando ele vem junto com um caminho que você não consegue escrever antes. O mesmo guia observa que é tentador construir de imediato um agente totalmente autônomo, mas que os clientes costumam ter mais sucesso com uma abordagem incremental.
A Anthropic fecha o artigo pedindo para medir o desempenho e iterar, e para só adicionar complexidade quando ela melhora o resultado de forma demonstrável. Com o caminho no código, trocar o verificador por um avaliador LLM, por exemplo, é uma mudança local, e dá para rodar as duas versões nos mesmos PRs antes de decidir.
Esse tipo de decisão, construindo aplicações com LLMs a partir desses blocos, é o que a Formação em Inteligência Artificial trabalha na prática.
Referências
- Anthropic. Building effective agents. Erik Schluntz e Barry Zhang, 19 de dezembro de 2024.
- OpenAI. A practical guide to building agents.
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.