Como avaliar agente de IA: task, trial e grader
Avaliar agente de IA é mais difícil do que avaliar uma chamada de LLM, porque o agente trabalha por vários turnos, chama ferramentas, altera o estado do ambiente e se adapta ao que encontra pelo caminho. Um erro no segundo passo contamina o quarto, e olhar só a resposta final esconde isso.
O que é um eval de agente?
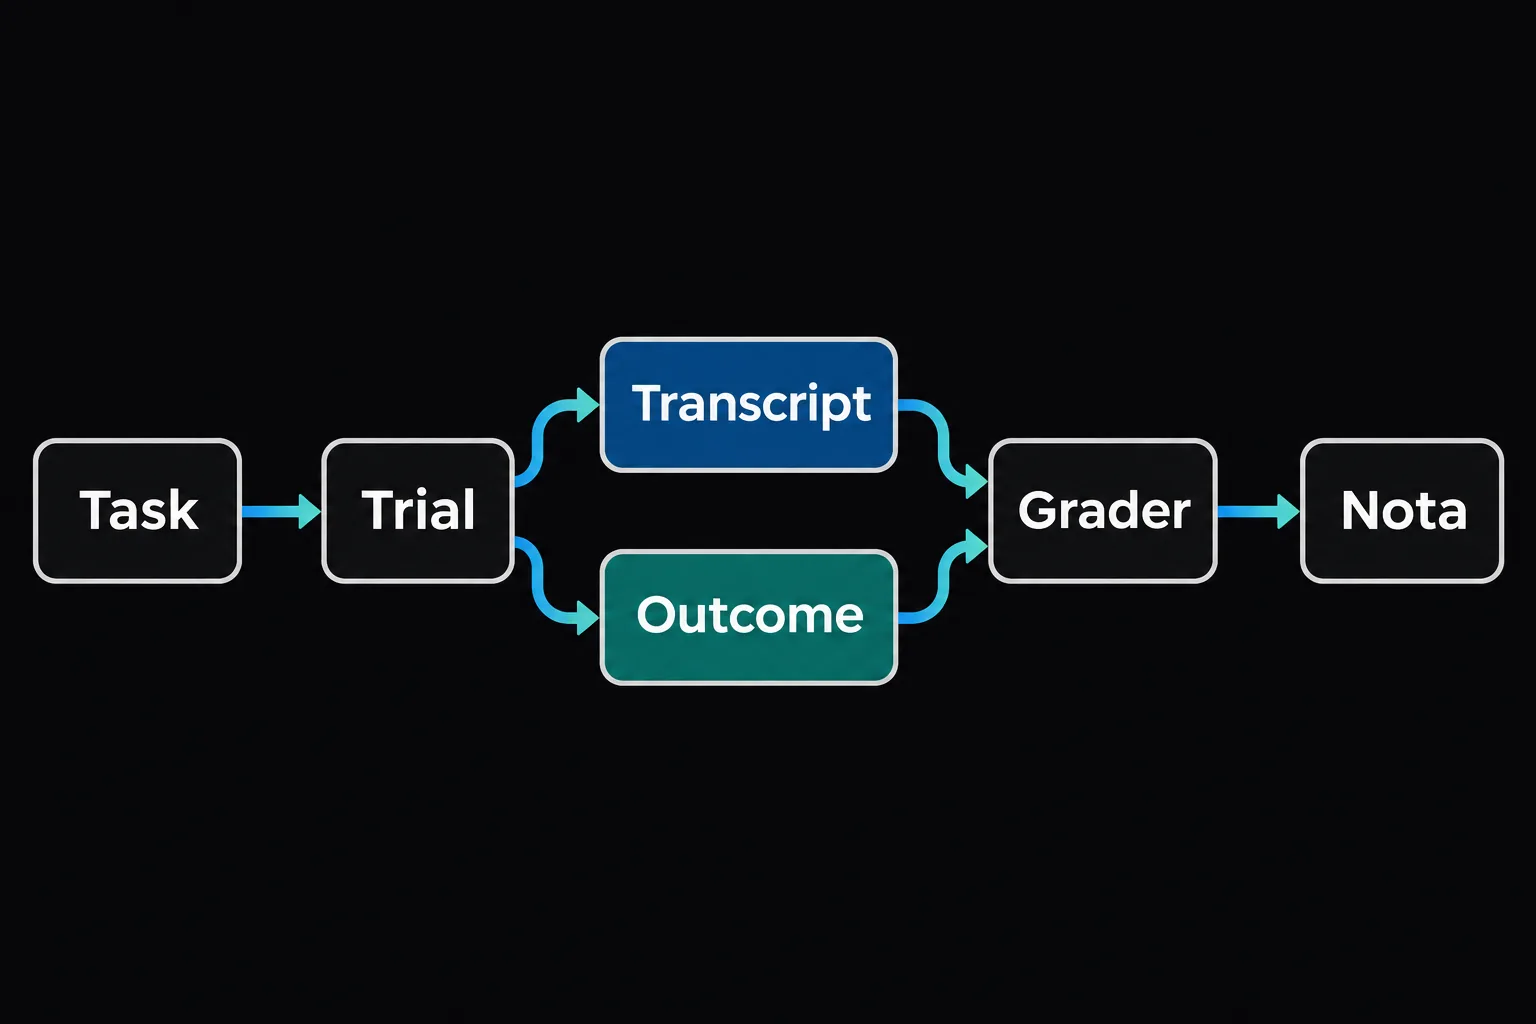
Um eval é um teste para um sistema de IA: você dá uma entrada e aplica uma lógica de correção sobre a saída para medir se deu certo. A definição é do post de engenharia da Anthropic "Demystifying evals for AI agents", de janeiro de 2026, que também fixa o vocabulário usado aqui:
- Task (ou test case): um teste individual, com entrada e critérios de sucesso definidos.
- Trial: cada tentativa de executar uma task. Como a saída do modelo varia entre execuções, você roda vários trials por task.
- Grader: a lógica que dá nota a algum aspecto do desempenho. Uma task pode ter vários graders.
- Transcript (também chamado de trace ou trajetória): o registro completo de um trial, com saídas, chamadas de ferramenta, raciocínio e resultados intermediários.
- Outcome: o estado final do ambiente ao fim do trial.
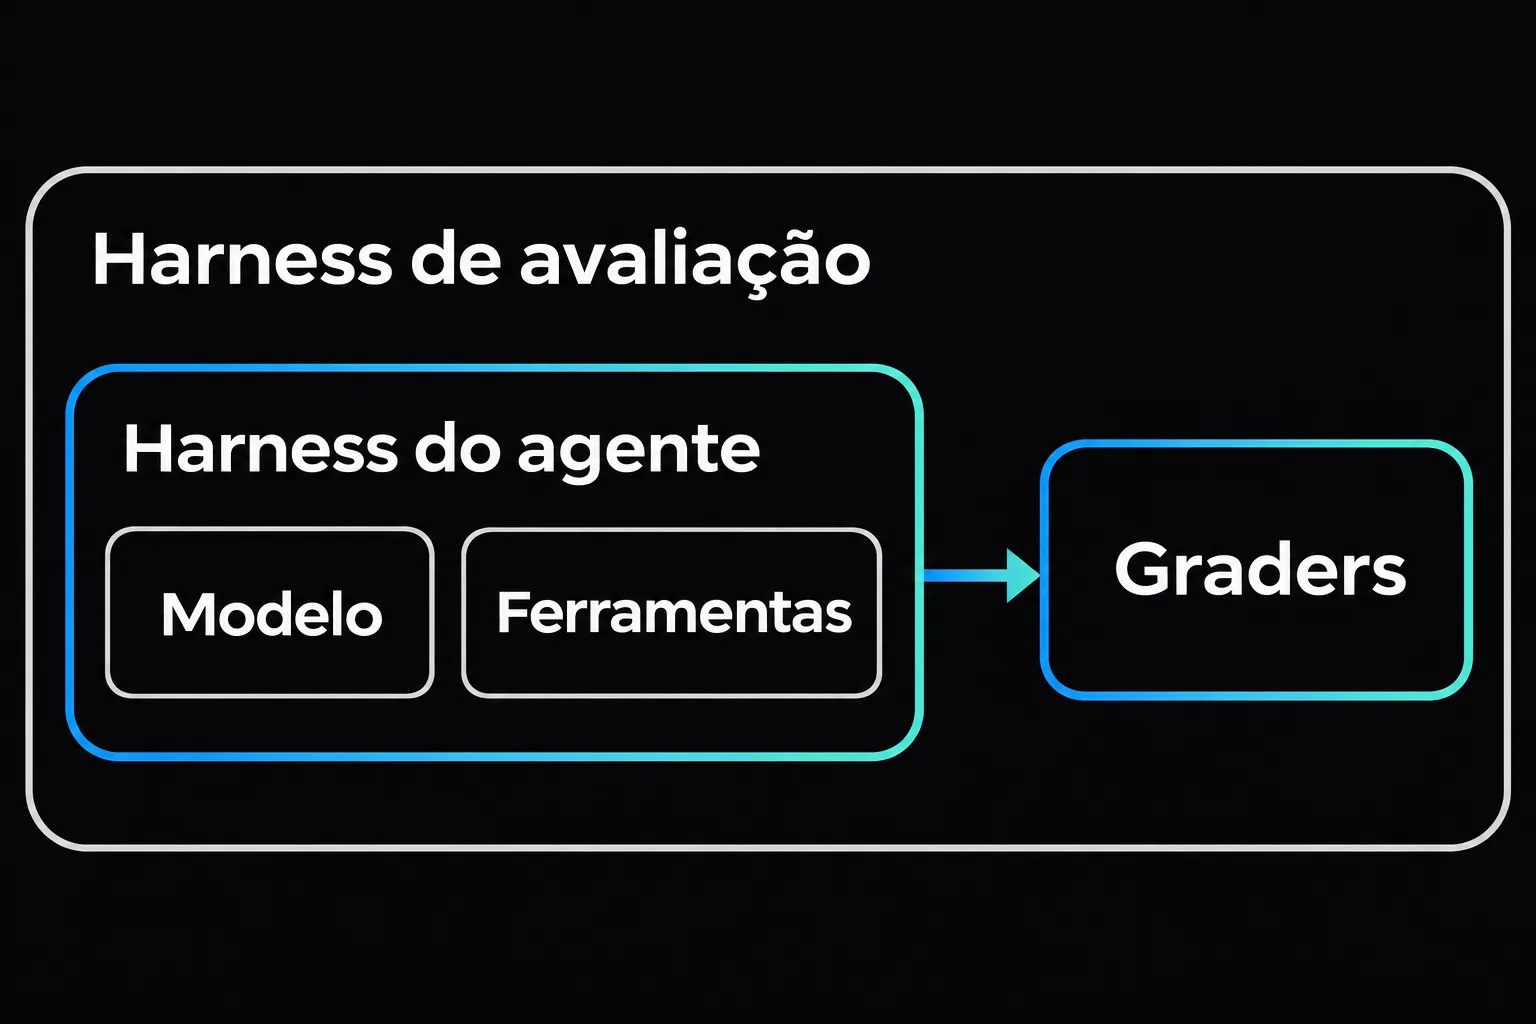
- Harness de avaliação: a infraestrutura que roda as tasks, registra os passos, aplica os graders e agrega os resultados.
A distinção entre transcript e outcome é a que mais confunde. Se um agente de pedidos termina dizendo "Endereço atualizado com sucesso", isso está no transcript. O outcome é o que a tabela de pedidos guarda depois do trial. O agente pode escrever a frase certa sem ter chamado a ferramenta, ou chamá-la com o ID errado, e só o outcome mostra isso.
Por que avaliar agente de IA é avaliar modelo mais harness?
O texto da Anthropic separa o harness de avaliação, descrito acima, do harness do agente, também chamado de scaffold: o sistema que permite ao modelo agir como agente, orquestrando chamadas de ferramenta e devolvendo resultados. Quando você avalia "um agente", diz o texto, está avaliando o harness e o modelo trabalhando juntos.
Se o score caiu depois de uma mudança, a causa pode estar no modelo, no prompt de sistema, na descrição de uma ferramenta, no limite de turnos ou no próprio grader. A Anthropic conta um caso do último tipo: o Opus 4.5 tinha 42% no CORE-Bench até um pesquisador encontrar correção rígida que penalizava "96.12" quando esperava "96.124991…", especificações ambíguas e tarefas estocásticas. Com os bugs corrigidos e um scaffold menos restritivo, o score foi para 95% sem trocar o modelo.
A Braintrust, num guia de fevereiro de 2026, separa a camada de raciocínio (planejar, escolher ferramentas) da camada de ação (chamar APIs e processar resultados): ajustes de prompt atacam falhas da primeira, e descrições e schemas de ferramenta, da segunda. Um score único esconde em qual camada está o defeito, por isso o código abaixo devolve uma nota por grader.
Como é a estrutura mínima em código?
O exemplo a seguir foi escrito para este post. Um agente de suporte troca o endereço de entrega de um pedido, o que só pode acontecer antes do despacho. O agente é uma função que recebe a entrada e o ambiente e devolve um transcript, e o outcome é o próprio ambiente depois da execução.
type ToolCall = { name: string; args: Record<string, unknown> };
type Transcript = { toolCalls: ToolCall[]; finalMessage: string };

type Order = { status: "pending" | "shipped"; address: string };
type Env = { orders: Map<string, Order> };

type Grade = { name: string; pass: boolean };
type Grader = (run: { transcript: Transcript; outcome: Env }) => Grade;
type Agent = (input: string, env: Env) => Promise<Transcript>;

type Task = {
  id: string;
  input: string;
  setup: () => Env; // ambiente novo a cada trial
  graders: Grader[];
};

// Outcome: o que ficou gravado, independente do que o agente disse.
const addressIs = (orderId: string, expected: string): Grader => ({ outcome }) => ({
  name: `address-${orderId}`,
  pass: outcome.orders.get(orderId)?.address === expected,
});

// Trajetória: só a ordem que importa para a regra de negócio.
const statusCheckedFirst: Grader = ({ transcript }) => {
  const names = transcript.toolCalls.map((c) => c.name);
  const update = names.indexOf("update_address");
  return {
    name: "status-checked-before-update",
    pass: update === -1 || names.slice(0, update).includes("get_order"),
  };
};

const maxCalls = (limit: number): Grader => ({ transcript }) => ({
  name: `max-${limit}-tool-calls`,
  pass: transcript.toolCalls.length <= limit,
});

async function runTrial(agent: Agent, task: Task) {
  const env = task.setup();
  const transcript = await agent(task.input, env);
  const grades = task.graders.map((g) => g({ transcript, outcome: env }));
  const passed = grades.filter((g) => g.pass).length;
  return { transcript, grades, score: passed / grades.length, passed: passed === grades.length };
}

async function runTask(agent: Agent, task: Task, k: number) {
  const trials = await Promise.all(Array.from({ length: k }, () => runTrial(agent, task)));
  const successes = trials.filter((t) => t.passed).length;
  return { taskId: task.id, trials, anyPassed: successes > 0, allPassed: successes === k };
}
setup cria um ambiente novo por trial, e como os trials rodam em paralelo, cada um precisa do seu. A Anthropic recomenda partir sempre de um estado limpo, porque arquivos sobrando, cache e esgotamento de recursos geram falhas correlacionadas que não dizem nada sobre o agente. Ela relata ter visto o Claude ganhar vantagem indevida em algumas tasks lendo o histórico do git de trials anteriores.
addressIs olha o outcome e ignora a mensagem final. Já statusCheckedFirst olha a trajetória, mas só para uma regra: se o agente chamou update_address, precisa ter consultado o pedido antes.
runTrial devolve também um score parcial, como a Anthropic recomenda para tasks com várias etapas. Um agente que consultou o pedido e respeitou o limite de chamadas, mas gravou o endereço errado, tira 2 de 3, à frente de um que falhou em tudo.
Por que a mesma entrada vira duas tasks?
A task em si é só dados, e o ambiente faz parte dela:
const seed = (status: Order["status"]): Env => ({
  orders: new Map([["A-100", { status, address: "Rua das Flores, 10" }]]),
});

const input = "Quero trocar o endereço do pedido A-100 para Av. Brasil, 200.";

const tasks: Task[] = [
  {
    id: "change-address-pending",
    input,
    setup: () => seed("pending"),
    graders: [addressIs("A-100", "Av. Brasil, 200"), statusCheckedFirst, maxCalls(5)],
  },
  {
    id: "change-address-shipped",
    input,
    setup: () => seed("shipped"),
    graders: [addressIs("A-100", "Rua das Flores, 10"), maxCalls(5)],
  },
];
O pedido do cliente é idêntico, mas na primeira o endereço precisa mudar e na segunda, com o pedido já despachado, precisa continuar o mesmo.
Sem a segunda task, um agente que chama update_address em qualquer situação passa com nota máxima. A Anthropic descreve o mesmo risco com busca na web: testar só quando o agente deveria buscar produz um agente que busca para tudo. Uma suíte precisa ter os casos em que o comportamento deve acontecer e os casos em que não deve.
Que tipo de grader usar?
O exemplo acima só tem graders em código, que são rápidos, baratos e reproduzíveis, mas quebram diante de variações válidas: se o agente gravar "Avenida Brasil, 200", addressIs reprova uma solução correta. Normalizar o endereço resolve esse caso, mas nenhuma comparação de string diz se o agente explicou com clareza por que não dava para trocar.
Para isso existem os graders baseados em modelo (LLM as judge), com rubricas ou asserções em linguagem natural. Eles lidam com saída livre, mas variam entre execuções, custam mais e precisam ser calibrados contra avaliadores humanos. O texto da Anthropic sugere deixar o juiz responder "Unknown" quando faltar informação e avaliar cada dimensão da rubrica com um juiz separado. A ordem recomendada é código onde der, LLM onde for necessário e humanos com parcimônia, principalmente para calibrar os juízes.
Sobre o que corrigir, a Braintrust defende examinar resultado e trajetória, e a Anthropic avisa que exigir uma sequência exata de chamadas gera testes frágeis, porque agentes encontram caminhos válidos que quem escreveu o eval não previu. As duas posições convivem no código acima: o outcome decide se a task foi cumprida, e a trajetória entra só como restrição de negócio (consultar antes de alterar) ou como custo (maxCalls).
Por que rodar vários trials?
O mesmo agente pode passar numa execução e falhar na seguinte, então cada task tem uma taxa de sucesso, que um trial isolado não consegue medir. O runTask devolve duas leituras sobre os mesmos k trials. A fração de tasks com anyPassed estima o pass@k, a chance de pelo menos um trial dar certo, que sobe com k. A fração com allPassed estima o pass^k, a chance de todos darem certo, que cai com k. Com 75% de sucesso por trial e 3 trials, diz a Anthropic, a chance de passar nos três é 0,75³, cerca de 42%. Num agente que mexe em pedidos de clientes, o segundo número é o que se aproxima da experiência de quem usa.
As tasks também têm dois papéis. Evals de capability medem o que o agente ainda não faz bem e começam com taxa baixa. Evals de regressão conferem se ele continua fazendo o que fazia e devem ficar perto de 100%. Uma task de capability resolvida de forma consistente migra para a regressão, na mesma lógica dos testes automatizados tradicionais, só que com resultado estatístico.
Como começar sem montar uma plataforma?
Segundo a Anthropic, 20 a 50 tasks simples tiradas de falhas reais já são um bom começo, porque no início cada mudança no agente tem efeito grande e amostras pequenas bastam. Elas saem do que você testa manualmente antes de cada release, da fila de suporte e do bug tracker.
Antes de confiar numa task, confira três coisas. Tudo o que o grader verifica precisa estar no enunciado: se o grader espera o endereço num formato que o enunciado não menciona, o agente falha sem culpa. Uma solução de referência precisa passar em todos os graders, provando que a task é resolvível. E 0% em muitos trials, com modelos de fronteira, costuma indicar task quebrada.
Depois, leia os transcripts das falhas. É assim que você descobre se o agente errou de fato ou se o grader rejeitou uma solução válida, como no caso do "Avenida" por extenso.
Quando um eval assim não é suficiente?
Um eval offline com tasks fixas mede o que você pensou em testar, e a própria Anthropic lista monitoramento em produção, testes A/B e pesquisa com usuários como sinais complementares. E o score só vale para a combinação de modelo e harness que você rodou: trocar o modelo, o prompt ou a descrição de uma ferramenta pede rodar a suíte de novo.
Se você quer praticar o desenho de evals, harness e graders em projetos completos, esse é um dos temas da Formação em Inteligência Artificial.
Referências
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial11 nov 2026 7 min
Workflow ou agente? Cinco padrões para compor LLMs
Workflow ou agente? Os cinco padrões da Anthropic para compor LLMs, um exemplo em TypeScript e quatro perguntas para decidir quando o agente compensa.

