Context engineering: a informação certa na hora certa
Context engineering é a prática de fornecer a informação certa, no formato certo, no momento certo para que uma tarefa seja executada dentro de uma janela de contexto específica. Quem usa agentes de código já viu o contrário: a tarefa vai bem nas primeiras trocas, depois o modelo começa a responder a pergunta anterior, inventa um comando de teste que não existe e escreve o arquivo na pasta errada.
A reação comum é escrever um prompt maior ou trocar por um modelo com mais tokens. Este post mostra por que nenhuma das duas coisas resolve e como separar o que o agente precisa saber em três camadas de memória. Se o conceito de agente ainda não está firme, veja antes o que é um agente de IA.
Por que a janela é cumulativa
Tudo o que entra na conversa faz parte do mesmo estado: perguntas, respostas, código lido, código gerado. Se você pergunta sobre culinária, depois sobre viagem, e na décima pergunta o modelo ainda responde a primeira, o comportamento é esperado. A janela de contexto acumula, e o modelo não sabe que o assunto mudou.
Por isso encadear uma tarefa atrás da outra na mesma conversa, sem limpar o contexto, degrada o resultado. Os avisos de que a janela está acabando e de que o contexto está sendo compactado são sintoma disso.
Janela maior resolve?
Na palestra do Dev Na Gringa Summit, a avaliação foi que 200 mil tokens, o que o Sonnet e o Opus oferecem, são mais que suficientes para programar. Janelas de 1 ou 2 milhões fazem sentido quando a tarefa realmente exige tudo ao mesmo tempo, como ler um livro de 1.500 páginas para perguntar algo sobre ele. Em programação, quase sempre dá para quebrar o trabalho em partes.
Há três custos em usar uma janela enorme por padrão:
- instruções divergentes convivem no mesmo contexto e aumentam a chance de alucinação;
- a resposta fica obrigatoriamente mais lenta, porque há mais coisa para processar;
- mais tokens queimados, sem garantia de resultado melhor.
O artigo da equipe de engenharia da Anthropic sobre context engineering para agentes chega à mesma conclusão por outro caminho. Ele trata o contexto como recurso finito e cita o conceito de context rot, observado em benchmarks do tipo agulha no palheiro: conforme o número de tokens na janela cresce, a capacidade do modelo de recuperar com precisão uma informação desse contexto diminui. Para a Anthropic, o objetivo passa a ser o menor conjunto possível de tokens de alto sinal.
Quais são as três memórias do context engineering?
A proposta é pensar em três tipos de memória, cada um com um escopo diferente.
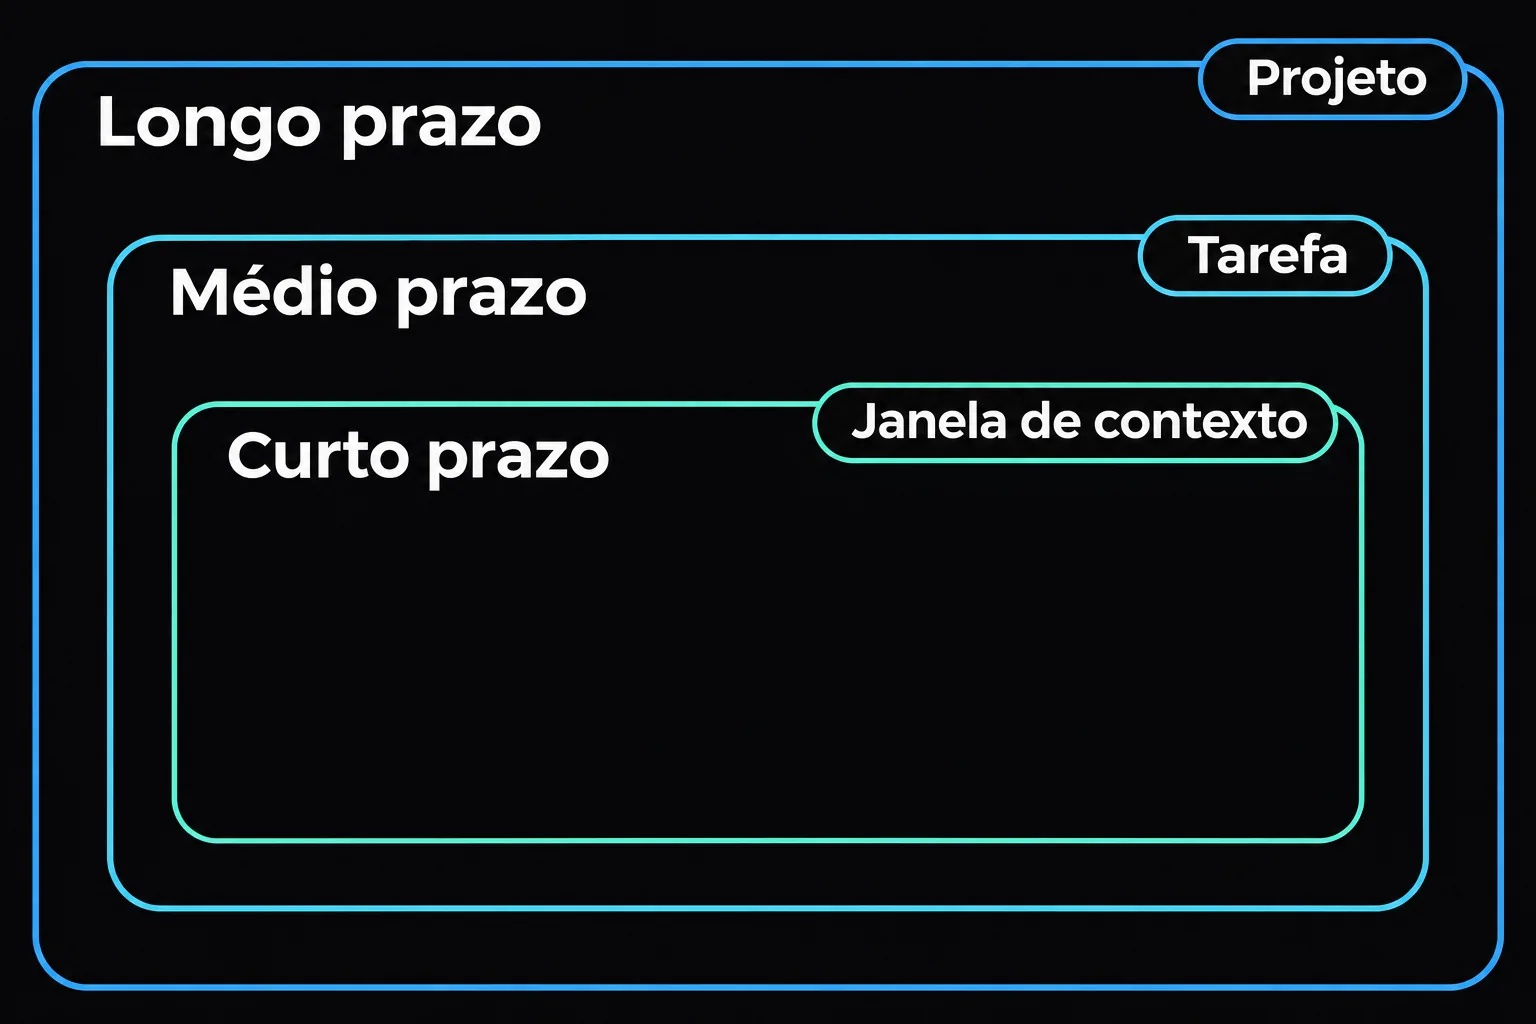
| Memória | O que contém | Escopo |
|---|---|---|
| Curto prazo | Tudo o que trafega: perguntas, respostas, código que entra e que sai | A janela de contexto em si |
| Médio prazo | Artefatos gerados para a tarefa: requisitos, especificação técnica, lista de subtarefas | Uma tarefa, com várias subtarefas |
| Longo prazo | Código-fonte, README, rules | O projeto inteiro, qualquer tarefa |
A memória de médio prazo é a menos conhecida das três, porque é uma categoria proposta na própria palestra. São documentos intermediários que servem a várias subtarefas dentro de uma tarefa grande, sem que uma interfira no escopo da outra. Eles funcionam como contexto auxiliar e não ficam o tempo todo na janela. Na formulação da palestra, esses documentos não estão no contexto, estão oferecidos para o contexto.
O que vai na memória de longo prazo?
O código-fonte é o básico, e as ferramentas de agente já cuidam dele com busca ou RAG. Quem cola trechos de código no ChatGPT entrega ao modelo só aquele pedaço, sem acesso ao restante do projeto, e essa é a principal deficiência desse uso.
O README responde ao que nenhum modelo consegue adivinhar: em qual porta o projeto roda, qual é o comando de teste, como rodar uma migration, como instalar dependências. Sem isso o agente tenta yarn test, depois yarn jest, depois npx, e cada volta dessa tentativa e erro queima token.
As rules cobrem as decisões que valem para praticamente qualquer tarefa:
- código-fonte em inglês, camelCase para métodos, funções e variáveis, PascalCase para classes e interfaces, kebab-case para arquivos e diretórios;
- nunca usar flag parameter para alternar comportamento de método;
- evitar mais de dois
if elseaninhados e mais de três parâmetros; - usar async/await em vez de callback, e os componentes da biblioteca de UI que o time já adota.
Sem essas informações o modelo precisa descobrir, e descobrir custa tempo e token. Dois cuidados valem a pena. Não copie rules aleatórias da internet, porque elas podem não bater com o que o seu projeto usa. O melhor caminho é sentar com o time, discutir cada regra, escrever em português e depois pedir a tradução e exemplos. E não escreva 50 mil tokens de rules: o suficiente basta, senão você gasta mais.
Como a memória de médio prazo funciona numa tarefa?
Pegue como exemplo um comparador de planos de ferramentas de IA, em que o usuário move um slider de orçamento e vê quais planos cabem nele. A tarefa tem aspectos de negócio e técnicos, e cada um vira um artefato, gerado em um contexto próprio:
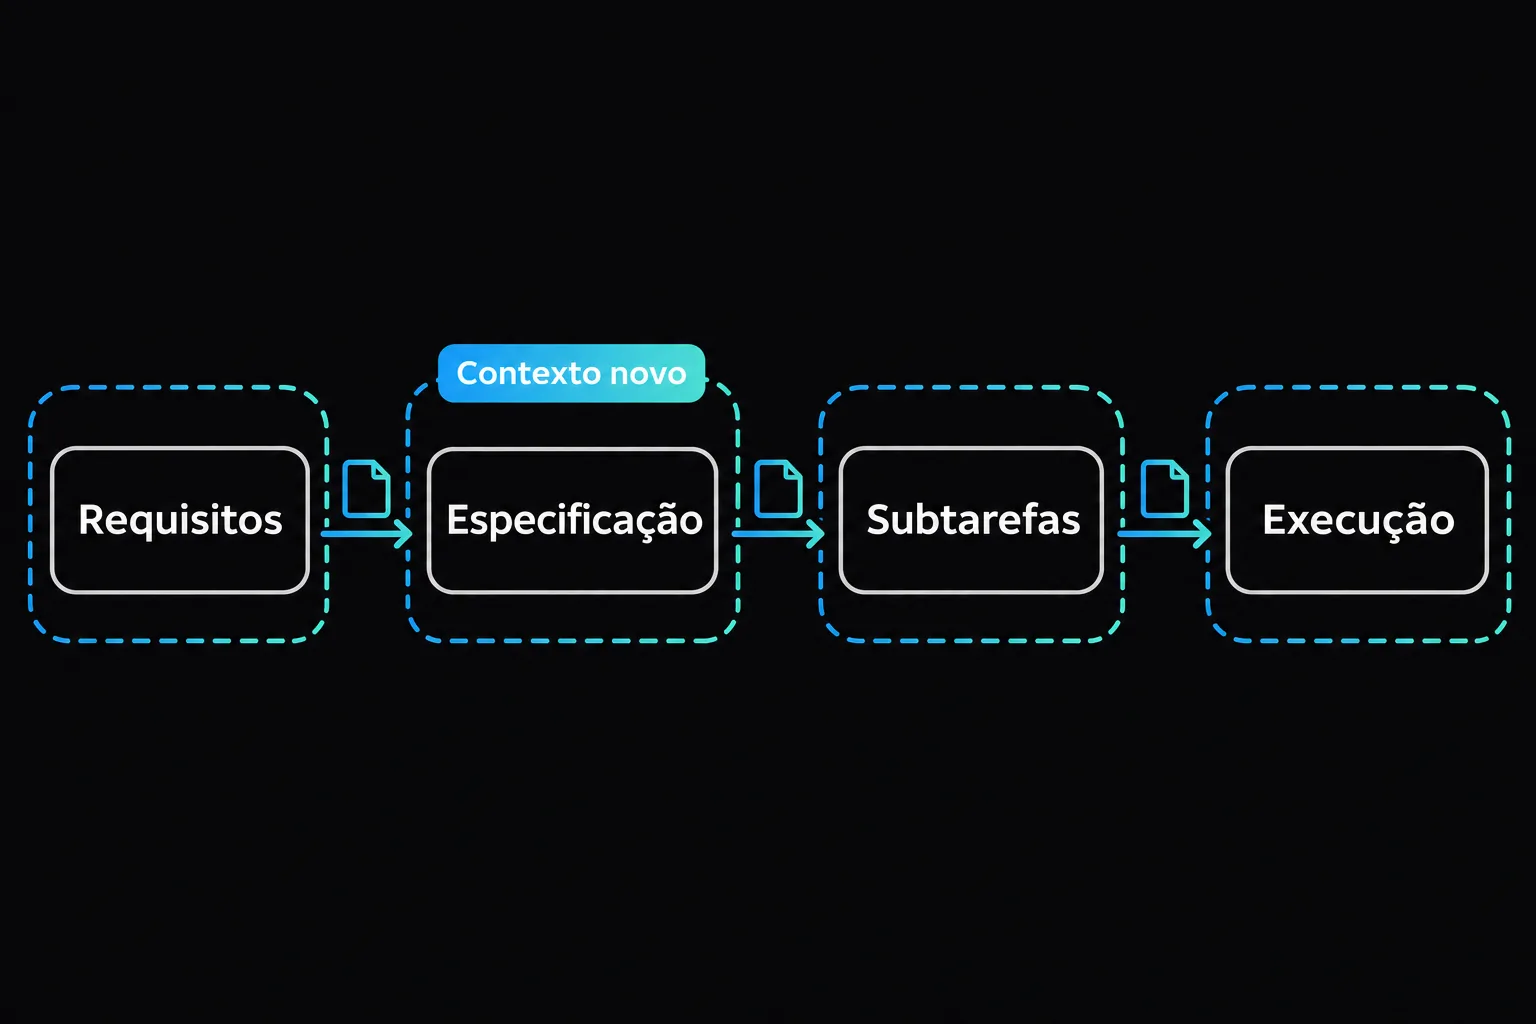
- Requisitos (PRD). Visão geral, objetivo, história de usuário, o que está e o que não está no escopo. Serve de base para a execução e, depois, como documentação.
- Especificação técnica. Combina o código-fonte, as rules, o README e os requisitos. Dela saem os componentes de back-end e front-end, os nomes de controllers, tabelas e colunas, payloads, interfaces e testes. Se algo estiver errado, corrige-se aqui, como num plan mode.
- Decomposição em subtarefas. Tarefas grandes são menos assertivas, então a especificação vira partes menores, com critérios de sucesso.
Cada etapa roda num contexto novo. O contexto dos requisitos termina, o da especificação começa recebendo o documento pronto, e assim por diante. Só depois disso vem a execução, que é novamente memória de curto prazo, agora com o contexto suficiente para uma subtarefa. Na palestra, o alerta foi sobre o excesso: 50 tarefas podem levar 6 horas para rodar, e menos de 10 costuma ser mais assertivo. Na execução entram também ferramentas que ampliam o que o modelo sabe: o Context7 para documentação atualizada de bibliotecas, o Figma MCP para ler cor, espaçamento e fonte de uma tela, o Playwright para abrir e validar a interface.
Como isso fica em código?
A ideia cabe em uma função: para cada passo, montar o contexto a partir das três camadas e entregar só o que aquele passo precisa. O exemplo abaixo é uma ilustração, não uma API de nenhuma ferramenta.
type Artifact = { name: string; content: string };

type MemoryLayers = {
  longTerm: Artifact[];  // README, rules
  midTerm: Artifact[];   // PRD, spec, tarefas da tarefa atual
};

type Step = {
  goal: string;
  needs: string[];       // nomes dos artefatos de médio prazo
};

function buildContext(layers: MemoryLayers, step: Step): string {
  const mid = layers.midTerm.filter((a) => step.needs.includes(a.name));
  const sections = [...layers.longTerm, ...mid].map(
    (a) => `## ${a.name}\n${a.content}`,
  );
  return [...sections, `## Objetivo\n${step.goal}`].join("\n\n");
}

const layers: MemoryLayers = {
  longTerm: [
    { name: "README", content: "Testes: npm test. API na porta 3000." },
    { name: "rules", content: "Arquivos em kebab-case. Use async/await." },
  ],
  midTerm: [
    { name: "prd", content: "Slider de orçamento filtra planos." },
    { name: "spec", content: "GET /api/plans retorna a lista de planos." },
  ],
};

console.log(
  buildContext(layers, {
    goal: "Criar o hook usePlans",
    needs: ["spec"],
  }),
);
A memória de longo prazo entra em todo passo. A de médio prazo entra só quando o passo declara que precisa dela, e o PRD fica de fora do passo que cria o hook, porque a especificação já o incorpora. O contexto resultante é pequeno e específico.
Quando não vale esse esforço?
Tem tarefa pequena, e para ela a especificação também será pequena. O exemplo da palestra é pedir a um modelo de raciocínio que coloque o asterisco vermelho de campo obrigatório num formulário: ele fica um tempão pensando e editando arquivos para algo que você faz copiando e colando três vezes. Nesses casos, faça à mão ou escreva um prompt direto, sempre referenciando o arquivo e, se possível, o intervalo de linhas, o que reduz a queima de token. A regra é proporcional: quanto maior e mais complexa a tarefa, mais a memória de médio prazo compensa. Os templates variam entre empresas e projetos, e itens como observabilidade só entram se o projeto os tem.
Também não há motivo para escrever tudo à mão. Os artefatos podem ser gerados com apoio de agentes e templates, e o que importa é revisar e aprovar cada um antes do próximo passo.
Resumo prático
Resultado bom com agente depende menos do tamanho do prompt e mais de onde cada informação mora. O que vale para o projeto inteiro fica em README e rules. O que vale para uma tarefa vira artefato, gerado em contexto próprio. A janela recebe só o necessário para o passo atual. Se você quiser aprofundar essa abordagem na prática, ela é trabalhada na Formação em Inteligência Artificial.
Referências
- Anthropic Engineering. Effective context engineering for AI agents.
- Palestra "A inteligência artificial não vai roubar seu emprego (ainda)", Dev Na Gringa Summit. YouTube.
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial13 nov 2026 7 min
IA em sistema grande funciona? A pergunta está errada
IA em sistema grande funciona? O LLM nunca lê a base inteira: o que pesa é a qualidade do design e a sua capacidade de reduzir o contexto de cada tarefa.
- Inteligência Artificial12 nov 2026 6 min
pass@k vs pass^k: seu agente acerta 75%, é confiável?
pass@k e pass^k medem coisas diferentes: acertar ao menos uma vez ou acertar sempre. Veja a conta, o código em TypeScript e qual usar para avaliar um agente.
- Inteligência Artificial12 nov 2026 7 min
O que é um agente de IA? O LLM decide quando parar
O que é um agente de IA: um loop de chamadas ao LLM em que o próprio modelo decide parar via tool calls. Veja a diferença para o workflow, com TypeScript.

