pass@k vs pass^k: seu agente acerta 75%, é confiável?
Um agente com 75% de acerto por tentativa parece bom. Só que o pass@k e o pass^k, duas métricas comuns em evals de agentes, resumem os mesmos trials de jeitos opostos, e a escolha entre elas muda a conclusão.
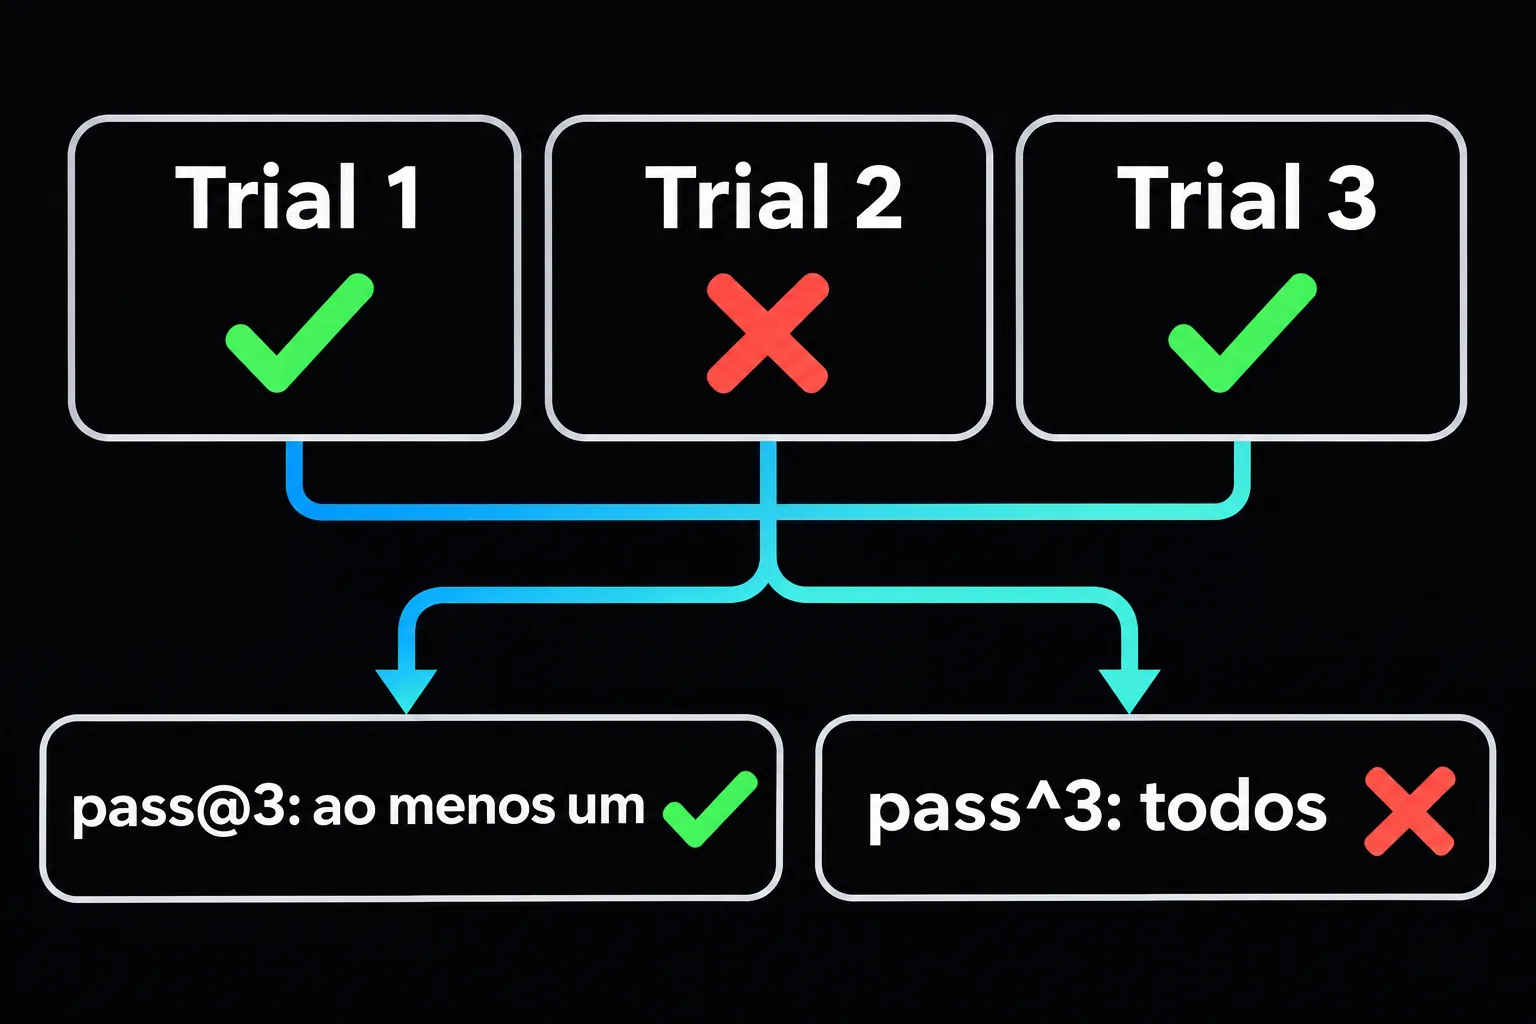
Rode o mesmo agente três vezes na mesma tarefa. Se bastar uma execução correta, ele passa em quase todas as tentativas de três. Se o usuário espera o acerto todas as vezes, ele passa em menos da metade.
Por que uma única rodada engana?
Agentes são não determinísticos. A mesma tarefa, com o mesmo prompt, pode passar numa execução e falhar na seguinte. O artigo de engenharia da Anthropic sobre evals de agentes faz essa observação: cada tarefa tem a sua taxa de sucesso, talvez 90% em uma e 50% em outra, e uma tarefa que passou numa rodada pode falhar na próxima.
Por isso o resultado de uma rodada única é uma amostra de tamanho um. Para medir de verdade, cada tarefa é executada várias vezes (cada execução é um trial, como no post sobre como avaliar um agente de IA). A pergunta passa a ser como resumir esses trials em um número. Há duas respostas, e cada uma corresponde a um produto diferente.
O que o pass@k mede?
O pass@k mede a probabilidade de o agente produzir pelo menos uma solução correta em k tentativas. A Anthropic descreve o efeito: quanto maior o k, mais "chutes ao gol", e a nota sobe.
Com p como taxa de sucesso por tentativa e tentativas independentes, a conta é a probabilidade de não falhar todas:
pass@k = 1 - (1 - p)^k
Com p = 0,75 e k = 3, dá 1 - 0,25³ ≈ 98%. Esse número sai da fórmula, sob a suposição de independência, e não de um benchmark.
Esse é o comportamento certo quando uma solução correta basta e existe um jeito barato de reconhecê-la. Um agente de código que roda a suíte de testes e devolve a primeira variante que passa se encaixa aí: errar duas vezes e acertar na terceira entrega o mesmo valor. Segundo a Anthropic, em código o mais comum é olhar o pass@1, o acerto na primeira tentativa, mas há casos em que propor muitas soluções é válido desde que uma funcione.
O que o pass^k mede?
O pass^k (lê-se "pass hat k" ou "pass ao k") faz a pergunta inversa: qual a probabilidade de todos os k trials terem sucesso? A métrica foi proposta no τ-bench, paper de Shunyu Yao e colegas, de junho de 2024, que avalia agentes em conversas com um usuário simulado, com ferramentas de API e regras de domínio. Os autores a introduzem para medir a confiabilidade do comportamento do agente ao longo de vários trials.
Se toda tarefa tiver a mesma taxa p e os trials forem independentes, a conta é a potência:
pass^k = p^k
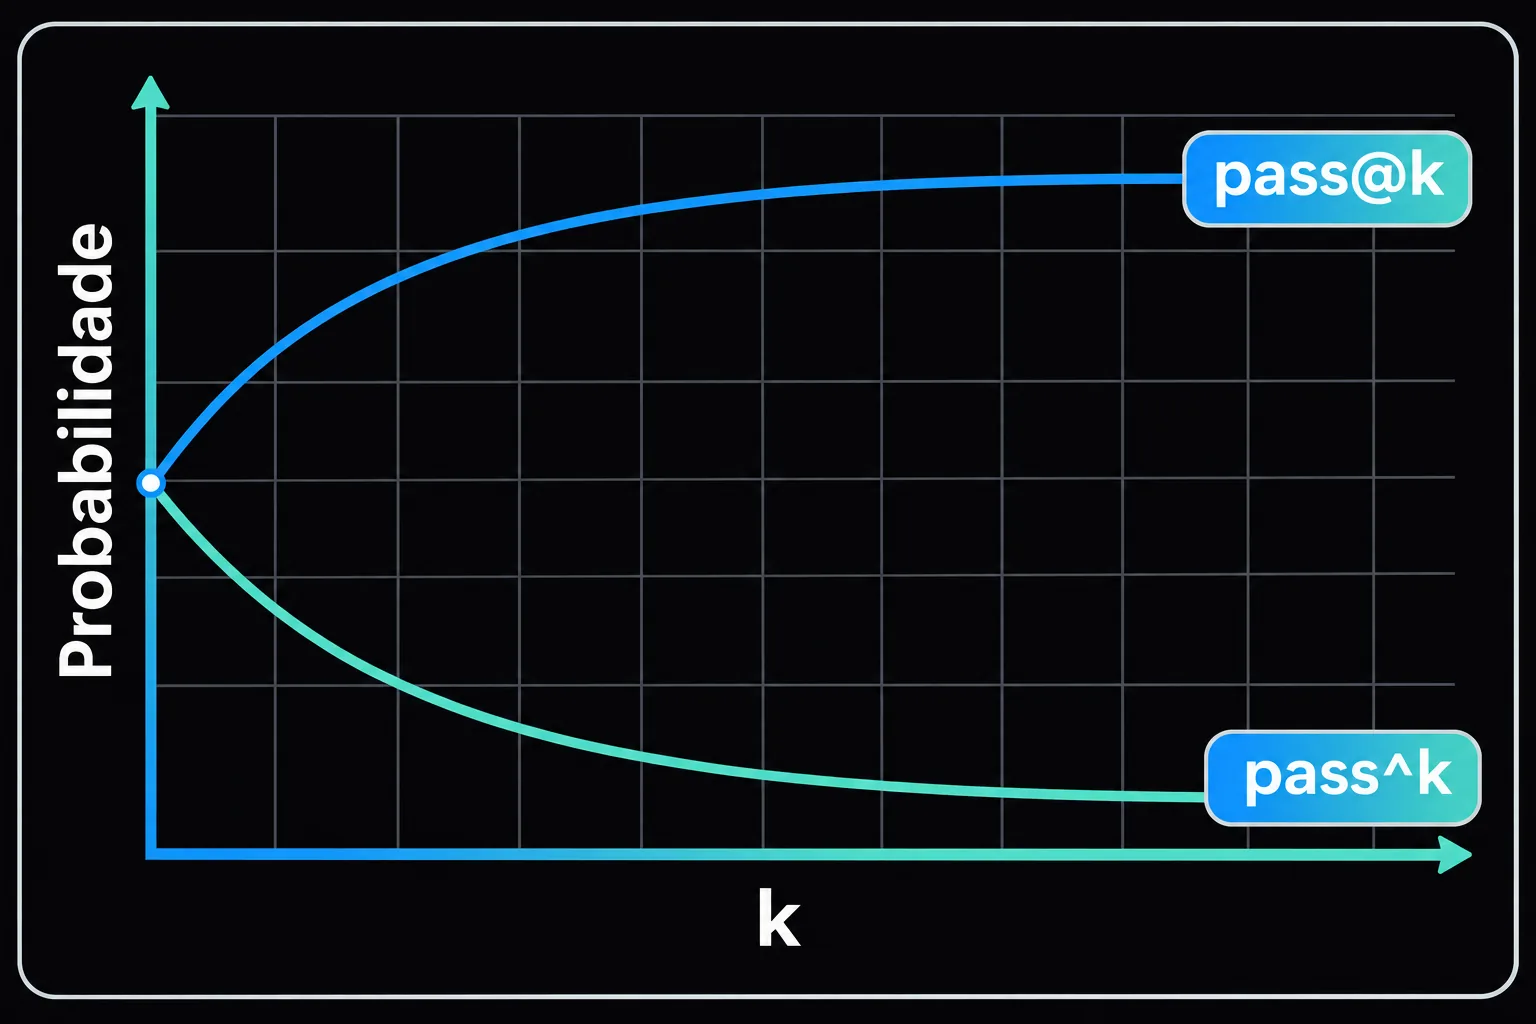
O exemplo da Anthropic é exatamente esse: com 75% de sucesso por trial e três trials, a probabilidade de passar nos três é (0,75)³ ≈ 42%. Para k = 8, o mesmo cálculo dá cerca de 10%, e para k = 10, cerca de 6%. Esses dois valores não estão no artigo: saem da mesma fórmula, com a mesma suposição de independência.
A Anthropic resume a divergência assim: em k = 1 as duas métricas são idênticas, ambas iguais à taxa de sucesso por trial. Em k = 10 elas contam histórias opostas, com o pass@k perto de 100% e o pass^k perto de 0%.
O próprio τ-bench mostra o efeito em dados reais. Segundo o abstract, mesmo agentes de function calling de ponta, como o gpt-4o, resolvem menos de 50% das tarefas e são bastante inconsistentes: o pass^8 fica abaixo de 25% no domínio de varejo. Os autores concluem que faltam métodos para fazer agentes agirem de forma consistente e seguirem regras com confiabilidade.
Como calcular os dois com dados reais?
A fórmula com potência assume que toda tarefa tem a mesma taxa de sucesso. Na prática, uma tarefa passa sempre e outra passa de vez em quando. Uma forma de lidar com isso é executar n trials por tarefa, contar os c sucessos, estimar a métrica por tarefa e tirar a média entre tarefas.
Sorteando k dos n trials sem reposição, a probabilidade de todos serem sucesso é C(c, k) / C(n, k). A probabilidade de pelo menos um ser sucesso é 1 menos a probabilidade de todos serem falha, ou seja, 1 - C(n - c, k) / C(n, k):
type TaskResult = { trials: number; successes: number };

function choose(n: number, k: number): number {
  if (k < 0 || k > n) return 0;
  let result = 1;
  for (let i = 1; i <= k; i++) {
    result = (result * (n - k + i)) / i;
  }
  return result;
}

function passAtK({ trials, successes }: TaskResult, k: number): number {
  if (k > trials) throw new Error("k maior que o número de trials");
  return 1 - choose(trials - successes, k) / choose(trials, k);
}

function passHatK({ trials, successes }: TaskResult, k: number): number {
  if (k > trials) throw new Error("k maior que o número de trials");
  return choose(successes, k) / choose(trials, k);
}

function mean(values: number[]): number {
  return values.reduce((sum, v) => sum + v, 0) / values.length;
}
Para ver a diferença, imagine um eval hipotético com três tarefas e 8 trials em cada uma. A primeira passa nos 8, a segunda em 6 e a terceira em 4. A média de acerto por trial é 75%:
const tasks: TaskResult[] = [
  { trials: 8, successes: 8 },
  { trials: 8, successes: 6 },
  { trials: 8, successes: 4 },
];

for (const k of [1, 3, 8]) {
  const at = mean(tasks.map((t) => passAtK(t, k)));
  const hat = mean(tasks.map((t) => passHatK(t, k)));
  console.log(`k=${k} pass@k=${at.toFixed(3)} pass^k=${hat.toFixed(3)}`);
}
A saída desse código:
k=1 pass@k=0.750 pass^k=0.750
k=3 pass@k=0.976 pass^k=0.476
k=8 pass@k=1.000 pass^k=0.333
Os dados são inventados para o exemplo, mas a lição vale para dados reais. Com k = 1 as duas métricas coincidem. Com k = 8, o pass@k diz que o agente resolve tudo, enquanto o pass^k diz que ele só é consistente em uma das três tarefas. As duas leituras estão corretas e respondem a perguntas distintas.
Note também que o pass^3 desse exemplo, 47,6%, ficou acima dos 42% da conta com potência, mesmo com a média de 75% nos dois casos. A conta p^k descreve um agente que falha ao acaso, com a mesma taxa, em todas as tarefas. No exemplo, a primeira tarefa continua em 100% para qualquer k e segura a média, enquanto as outras duas caem. Com a mesma média por trial, espalhar as falhas igualmente por todas as tarefas é o pior caso para o pass^k. Saber se as falhas estão espalhadas ou concentradas em algumas tarefas é um dos ganhos de olhar por tarefa.
Qual usar no meu produto?
A Anthropic dá o critério: ambas são úteis, e a escolha depende do requisito do produto. Use pass@k para ferramentas em que um sucesso basta, e pass^k para agentes em que a consistência é essencial.
- Gerar variantes de código verificadas por testes, sugerir rascunhos que uma pessoa vai escolher ou qualquer fluxo com um verificador barato no final: pass@k.
- Atendimento ao cliente, agente que altera dados, executa pagamento, cancela pedido ou segue política de negócio: pass^k. A Anthropic observa que a métrica importa especialmente para agentes voltados a clientes, em que o usuário espera comportamento confiável todas as vezes.
Há limites. O pass^k exige mais trials, e cada trial de um agente com ferramentas custa tempo e dinheiro. Se o seu k de produção é 1, porque cada conversa é uma tentativa só, o pass@1 já é a taxa de sucesso que o usuário vê, e o pass^k serve para medir quanto ela se mantém ao longo de uma sequência de usos do mesmo tipo de tarefa. Escolha o k pela quantidade de vezes que o usuário depende do agente na mesma situação, e não por um valor redondo.
Outro cuidado vem do mesmo artigo da Anthropic: uma nota baixa pode ser defeito do eval, não do agente. Com modelos de fronteira, uma tarefa com 0% de sucesso em muitos trials costuma indicar tarefa ou grader quebrado, e não um agente incapaz. Antes de interpretar um pass^k baixo, confira se o grader aceita respostas corretas. O loop do agente também importa aqui: quanto mais passos autônomos, mais chances de uma execução divergir, e mais o pass^k tende a cair.
O que levar para o seu eval
Reporte o número de trials por tarefa e o k junto com a nota. "75%" sem isso não diz se o agente acerta ao menos uma vez ou todas as vezes. Calcule as duas métricas por tarefa, olhe a distribuição entre tarefas e deixe o requisito do produto decidir qual delas vira o critério de aprovação.
Se você quer montar esse tipo de avaliação para agentes em produção, a Formação em Inteligência Artificial cobre o assunto dentro de um fluxo completo de engenharia com IA.
Referências
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial13 nov 2026 7 min
IA em sistema grande funciona? A pergunta está errada
IA em sistema grande funciona? O LLM nunca lê a base inteira: o que pesa é a qualidade do design e a sua capacidade de reduzir o contexto de cada tarefa.
- Inteligência Artificial13 nov 2026 6 min
Context engineering: a informação certa na hora certa
Context engineering é entregar ao agente a informação certa, no formato certo, no momento certo. Veja as memórias de curto, médio e longo prazo.
- Inteligência Artificial12 nov 2026 7 min
O que é um agente de IA? O LLM decide quando parar
O que é um agente de IA: um loop de chamadas ao LLM em que o próprio modelo decide parar via tool calls. Veja a diferença para o workflow, com TypeScript.

