IA em sistema grande funciona? A pergunta está errada
"IA em sistema grande funciona?" É uma das perguntas que mais aparecem quando o assunto é programar com LLM, e ela parte de uma premissa que não se sustenta: a de que o modelo precisa enxergar o sistema inteiro para trabalhar nele.
Ele não enxerga. Um LLM só processa o que chega na sua janela de contexto naquela chamada, e quem decide o que entra ali é você, ou a ferramenta que você usa. Por isso o tamanho da base importa bem menos do que parece, e a qualidade do design importa bem mais.
O modelo sabe quantas linhas tem o seu sistema?
Na palestra que fiz no Dev Na Gringa Summit (o vídeo foi publicado em janeiro de 2026), respondi a essa pergunta assim: uma LLM não lê o sistema inteiro e não tem a menor ideia se ele tem 10 linhas ou 10 bilhões de linhas, porque você reduz o contexto. Quando você pede "faça esta tela com base naquela", o que importa é a tela de referência. Se existem mais mil telas no repositório, elas simplesmente não são lidas.
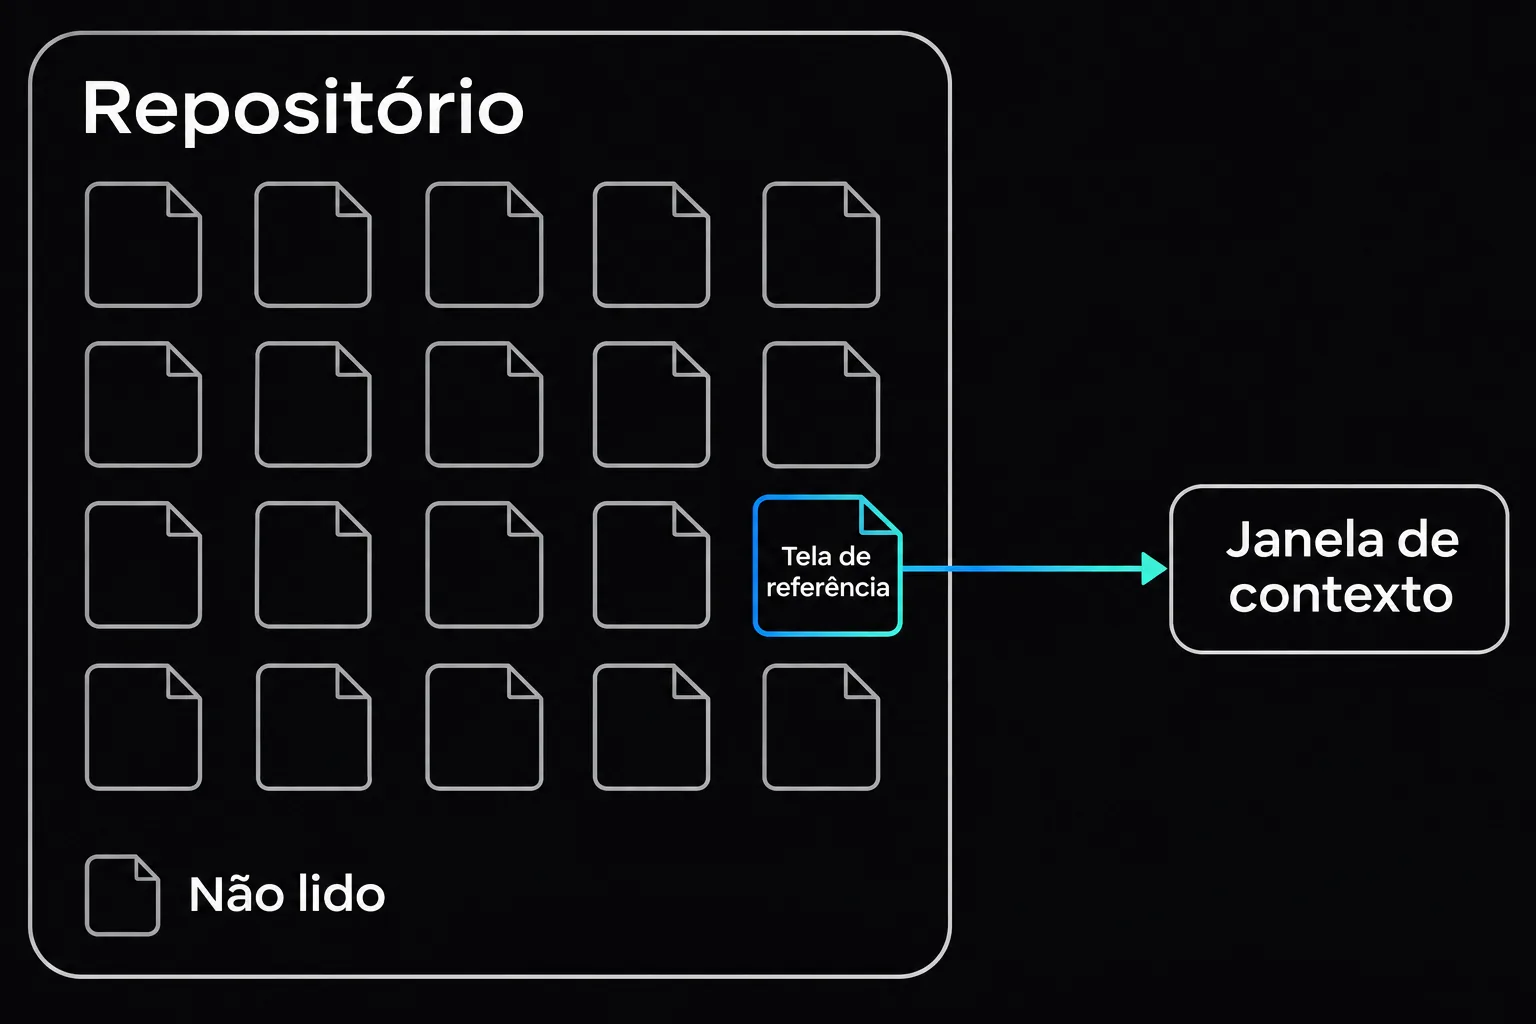
Isso muda o que a pergunta deveria ser. Em vez de "funciona em sistema grande?", vale perguntar duas coisas:
- consigo delimitar o que o modelo precisa ler para esta tarefa?
- o que ele vai ler está bem desenhado?
A primeira é uma questão de como você trabalha. A segunda é uma questão de arquitetura.
Por que mais contexto não resolve?
A reação comum é esperar que uma janela maior resolva. Na mesma palestra, comentei que 200 mil tokens, o tamanho de janela que Sonnet e Opus tinham na época, já é mais que suficiente, e que um modelo com janela maior não necessariamente traz o melhor resultado: a resposta fica mais lenta, você queima mais token e aumenta a chance de alucinação e de instruções divergentes. Ler um livro de 1.500 páginas para perguntar algo sobre ele justifica uma janela enorme. Programação, em geral, não. Até a refatoração de uma aplicação imensa pode ser feita em partes.
Há também um efeito prático que qualquer um percebe: o contexto é cumulativo. Tudo o que você perguntou e tudo o que o modelo respondeu continua na janela. Quem faz uma tarefa atrás da outra na mesma conversa termina com o contexto cheio de assunto que não tem relação com a tarefa atual, e o resultado piora.
O Waldemar Neto, em um vídeo de janeiro de 2026 sobre codebases de mais de 300 mil linhas, chega a uma recomendação parecida. Ele sugere ficar na faixa dos 200 mil tokens e, dentro dela, manter a janela bem longe de cheia, porque quando ela enche o modelo tem coisa demais para considerar e tende a alucinar. É uma orientação prática, que ele atribui ao que as próprias ferramentas recomendam, e não uma medição. Mesmo assim, ela combina com o que a palestra defende: o resultado depende de entregar a informação certa, no formato certo, no momento certo, e não de entregar tudo.
Como reduzir o contexto na prática?
Existem três movimentos que aparecem nas duas fontes e que se combinam bem.
O primeiro é ser específico no pedido. Na palestra, a recomendação foi sempre referenciar o arquivo e, se possível, o intervalo de linhas, com uma instrução clara e objetiva. Isso reduz a queima de token porque o modelo não precisa vasculhar o projeto para descobrir onde mexer.
O segundo é carregar contexto sob demanda. Waldemar descreve isso com dois nomes: divulgação progressiva, que é entregar ao modelo aos poucos o que ele precisa, e carregamento sob demanda, que é configurar a ferramenta para ler certos arquivos só quando o pedido os justifica. Na prática, são documentos de diretrizes por responsabilidade: um na raiz com o que vale para todo o projeto e outro dentro de cada módulo com as regras específicas dele. Quando a tarefa toca o módulo de cobrança, o guia de cobrança entra. Quando não toca, fica de fora.
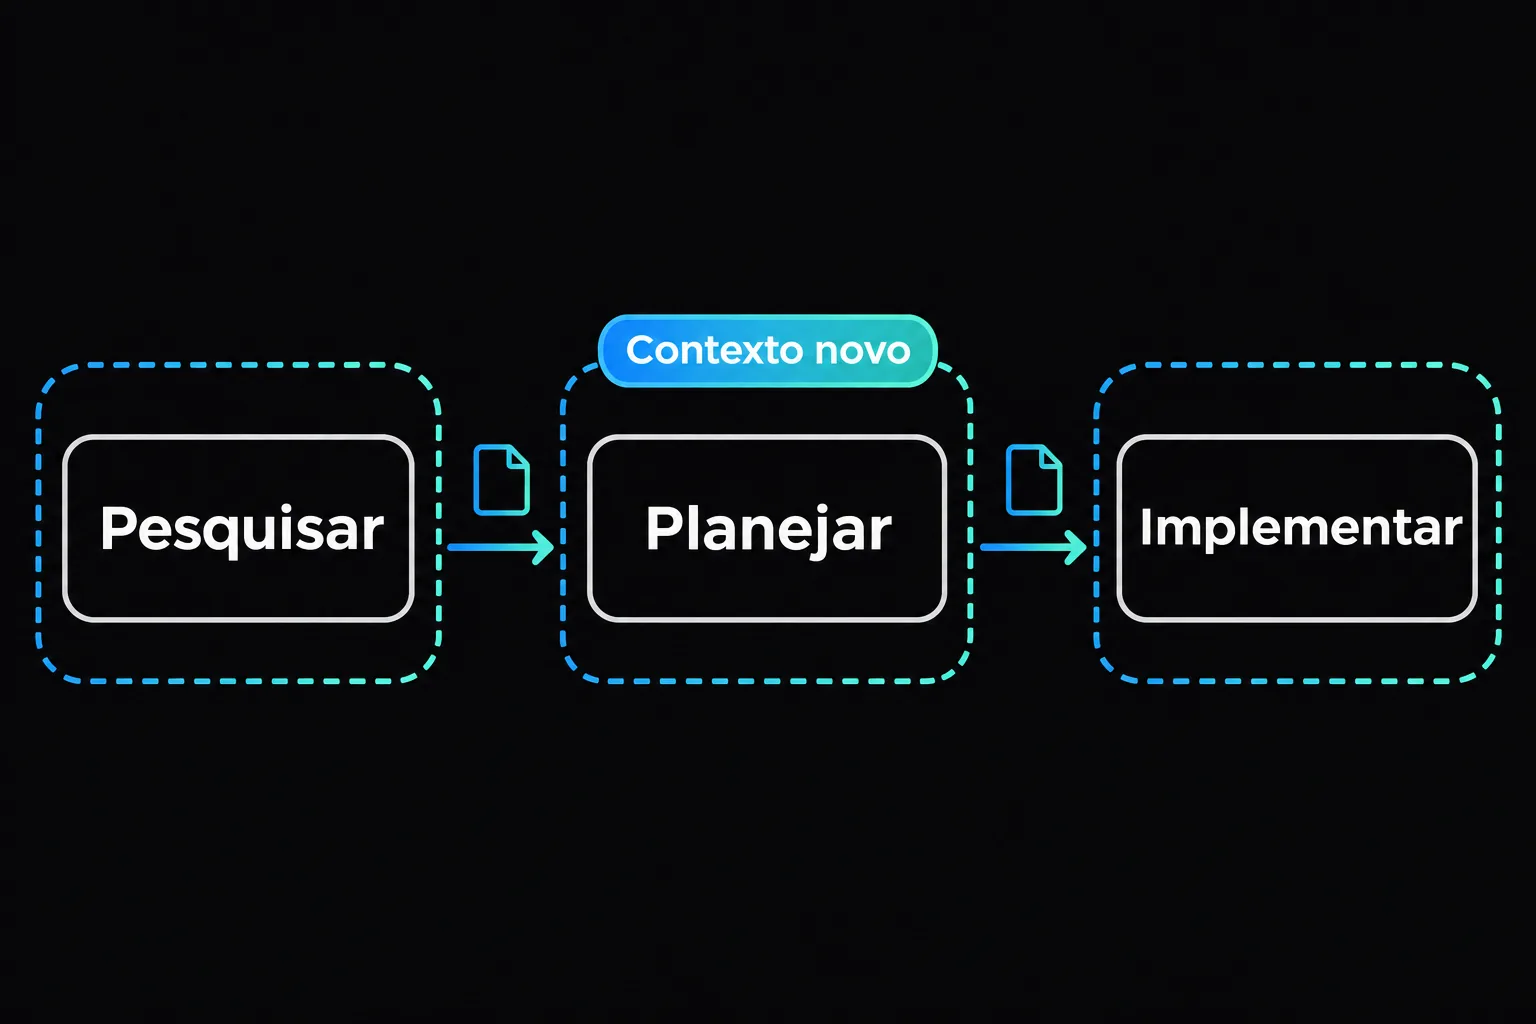
O terceiro é separar a pesquisa da execução. No vídeo do Waldemar, isso vira três fases: pesquisar onde as coisas estão, transformar isso em um plano e só então implementar, de preferência em uma janela nova que parte do plano salvo em arquivo. No vídeo, ele mostra uma pesquisa pedindo ao modelo para listar os arquivos que violavam as diretrizes do projeto. Só essa pesquisa já ocupou boa parte da janela, e pedir o plano em cima dela levou o uso para perto do limite que ele mesmo recomenda. Depois da pesquisa, o plano já aponta os arquivos e os comandos de validação, e quem implementa não precisa explorar o projeto de novo.
Quando a pesquisa é grande demais para a janela principal, subagentes ajudam. Em outro vídeo, de fevereiro de 2026, o Waldemar dispara um subagente por módulo para procurar o mesmo problema em paralelo. Cada um carrega os arquivos do seu módulo e devolve só o resultado, então a janela principal continua baixa mesmo com a pesquisa passando pelo sistema inteiro.
Como isso fica em código?
A ideia cabe em uma função pequena. Em vez de mandar o repositório, você monta o contexto de uma tarefa a partir de referências explícitas, e só anexa a diretriz do módulo quando alguma referência cai dentro dele.
import { readFileSync } from "node:fs";

type FileRef = { path: string; from?: number; to?: number };
type Task = { instruction: string; refs: FileRef[] };

// diretriz carregada somente quando a tarefa toca o diretório
const guidelines: Record<string, string> = {
  "src/billing/": "docs/billing-guidelines.md",
  "src/content/": "docs/content-guidelines.md",
};

function readRef({ path, from, to }: FileRef): string {
  const lines = readFileSync(path, "utf8").split("\n");
  const selected =
    from !== undefined && to !== undefined ? lines.slice(from - 1, to) : lines;
  return `// ${path}\n${selected.join("\n")}`;
}

function guidelinesFor(refs: FileRef[]): string[] {
  const files = Object.entries(guidelines)
    .filter(([dir]) => refs.some((ref) => ref.path.startsWith(dir)))
    .map(([, file]) => file);
  return files.map((file) => readFileSync(file, "utf8"));
}

export function buildContext(task: Task, maxChars = 40_000): string {
  const parts = [
    ...guidelinesFor(task.refs),
    ...task.refs.map(readRef),
    task.instruction,
  ];
  const context = parts.join("\n\n");
  if (context.length > maxChars) {
    throw new Error(
      `Contexto com ${context.length} caracteres. Quebre a tarefa em partes menores.`,
    );
  }
  return context;
}
Repare que a função não sabe nada sobre o tamanho do repositório. Ela recebe uma tarefa, os trechos que importam e a instrução. O limite de caracteres é arbitrário e serve para forçar a pergunta certa quando estoura: essa tarefa precisa mesmo de tudo isso, ou dá para dividir?
Uma ferramenta como Cursor ou Claude Code faz algo parecido por conta própria. A diferença é que, quando você entende o mecanismo, consegue ajudar a ferramenta a acertar.
IA em sistema grande: se o tamanho não importa, o que importa?
A resposta que dei na palestra foi direta: ter uma base de código maior ou menor não faz tanta diferença, mas ter um código muito ruim faz. A IA funciona, em boa parte, imitando. Se o código de referência é ruim, o que sai é ruim também, e a culpa não é da ferramenta.
Waldemar mostra o mesmo ponto pelo lado estrutural. Em uma base modular, com cada módulo em seu lugar e com suas regras, o modelo encontra onde mexer sem varrer o projeto. Em um monolito com vários services sem relação entre si, tudo misturado, ele diz que o resultado é ruim, porque o modelo não consegue entender nada. Sem um bom guia e sem um bom design de código, o output não tem como ser bom.
É por isso que defendi na palestra que arquitetura e design se aplicam mais hoje do que antes, enquanto saber detalhe de programação se aplica menos. Saber como escrever uma promise importa pouco quando você não vai escrever o código. Saber separar responsabilidades, desenhar módulos com fronteiras claras e decidir onde cada regra mora importa mais, porque é isso que torna possível apontar o modelo para um pedaço pequeno do sistema. Se quiser aprofundar a diferença entre os dois conceitos, vale ler qual é a diferença entre design e arquitetura de software.
Quando essa abordagem não ajuda?
Há limites que vale reconhecer.
Se a tarefa exige consistência entre muitas partes do sistema ao mesmo tempo, como uma refatoração que atravessa vários módulos, não existe um pedaço pequeno para apontar. Waldemar mostra o caminho: salvar a pesquisa em um arquivo, revisar e ajustar o plano manualmente, e quebrar em subplanos por fase. No exemplo dele, uma refatoração em que um service coordenava mais de 13 serviços em uma única transação virou várias fases, cada uma com seu plano, de modo que podia ser revisada em pull requests separados, em torno de seis no exemplo. Cada fase roda com contexto pequeno, mas revisar o plano, validar cada fase e revisar os pull requests continua sendo trabalho humano.
E se o código já é muito acoplado, reduzir o contexto fica difícil, porque qualquer arquivo puxa o resto junto. Waldemar defende que dá para adotar IA mesmo num código sem boa arquitetura, e o primeiro passo dele em qualquer codebase é gerar uma documentação básica da estrutura e das diretrizes. Citando a documentação do Claude Code, ele sugere manter esses documentos em torno de 500 linhas e dividir quando passarem disso, para o modelo ir buscando só o que precisa.
Por fim, para tarefas pequenas e pontuais, como corrigir um bug de uma linha, um pedido direto com arquivo e linha costuma bastar. Montar plano e subagentes para isso é custo sem retorno.
O que levar daqui?
A pergunta "funciona em sistema grande?" esconde o que realmente decide o resultado. O modelo trabalha sobre o recorte que você entrega. Quanto melhor o design, mais fácil é fazer um recorte pequeno, correto e independente do resto. Quanto melhor o seu hábito de delimitar a tarefa, menos o tamanho do sistema aparece.
Isso coloca arquitetura e design no centro do trabalho com IA, e é um dos temas que a Formação em Inteligência Artificial da Branas trata em detalhe. Para a parte de como montar esse recorte, o post context engineering na prática mostra o mecanismo com mais profundidade.
Referências
- Rodrigo Branas. Palestra: A inteligência artificial não vai roubar seu emprego (ainda), no Dev Na Gringa Summit. YouTube, publicado em janeiro de 2026.
- Waldemar Neto. Por que IA falha em codebases grandes (e como eu resolvi isso em codebases 300k+ linhas). YouTube, publicado em janeiro de 2026.
- Waldemar Neto. Refatoração com IA + Skills, Subagentes e Times de Agentes. YouTube, fevereiro de 2026.
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial13 nov 2026 6 min
Context engineering: a informação certa na hora certa
Context engineering é entregar ao agente a informação certa, no formato certo, no momento certo. Veja as memórias de curto, médio e longo prazo.
- Inteligência Artificial12 nov 2026 6 min
pass@k vs pass^k: seu agente acerta 75%, é confiável?
pass@k e pass^k medem coisas diferentes: acertar ao menos uma vez ou acertar sempre. Veja a conta, o código em TypeScript e qual usar para avaliar um agente.
- Inteligência Artificial12 nov 2026 7 min
O que é um agente de IA? O LLM decide quando parar
O que é um agente de IA: um loop de chamadas ao LLM em que o próprio modelo decide parar via tool calls. Veja a diferença para o workflow, com TypeScript.

