O que ocupa a janela de contexto de um agente?

A janela de contexto de um agente de código é um orçamento de tokens, e uma parte dele já foi gasta antes de você digitar o primeiro prompt. Quem trata a janela como um espaço infinito descobre o custo tarde: o agente começa bem, depois ignora uma instrução dada no meio da conversa e repete um erro que já tinha corrigido.
Este post mostra o que entra nessa janela, quanto cada peça costuma pesar segundo quem mediu no próprio Claude Code, por que o resultado piora quando ela enche e como transformar isso em uma conta simples no código.
O que é a janela de contexto, afinal?
A janela de contexto é o conjunto inteiro de tokens que o modelo enxerga em uma chamada: os tokens de entrada (system prompt, mensagens do usuário, resultados de ferramentas) mais os tokens de saída que ele mesmo gerou. Como cada resposta volta para a conversa, a janela só cresce enquanto você não a limpa.
Todo modelo tem um limite fixo definido pelo provedor. No vídeo sobre o tema, Matt Pocock consulta o models.dev e mostra o Claude Haiku 4.5 com 200 mil tokens, o Gemini 2.5 Pro como exemplo de janela grande, na casa do milhão, e o Qwen Math Plus com cerca de 4 mil, lembrando que modelos menores ou mais antigos costumam ter limites bem menores. Estourar o limite gera erro, ou interrompe uma resposta longa no meio.
Saber o limite ajuda pouco sem saber o que já ocupa a janela antes de você colocar qualquer coisa nela.
O que já está na janela antes do seu primeiro prompt?
Em uma sessão do Claude Code, o comando /context mostra a divisão do uso. No vídeo do Matt Pocock, numa sessão de reescrita de documentação com o Sonnet 4.5, a janela de 200 mil tokens estava com 95 mil usados: quase 8% era system prompt e 40% eram mensagens, o equivalente a 77 mil tokens de conversa.
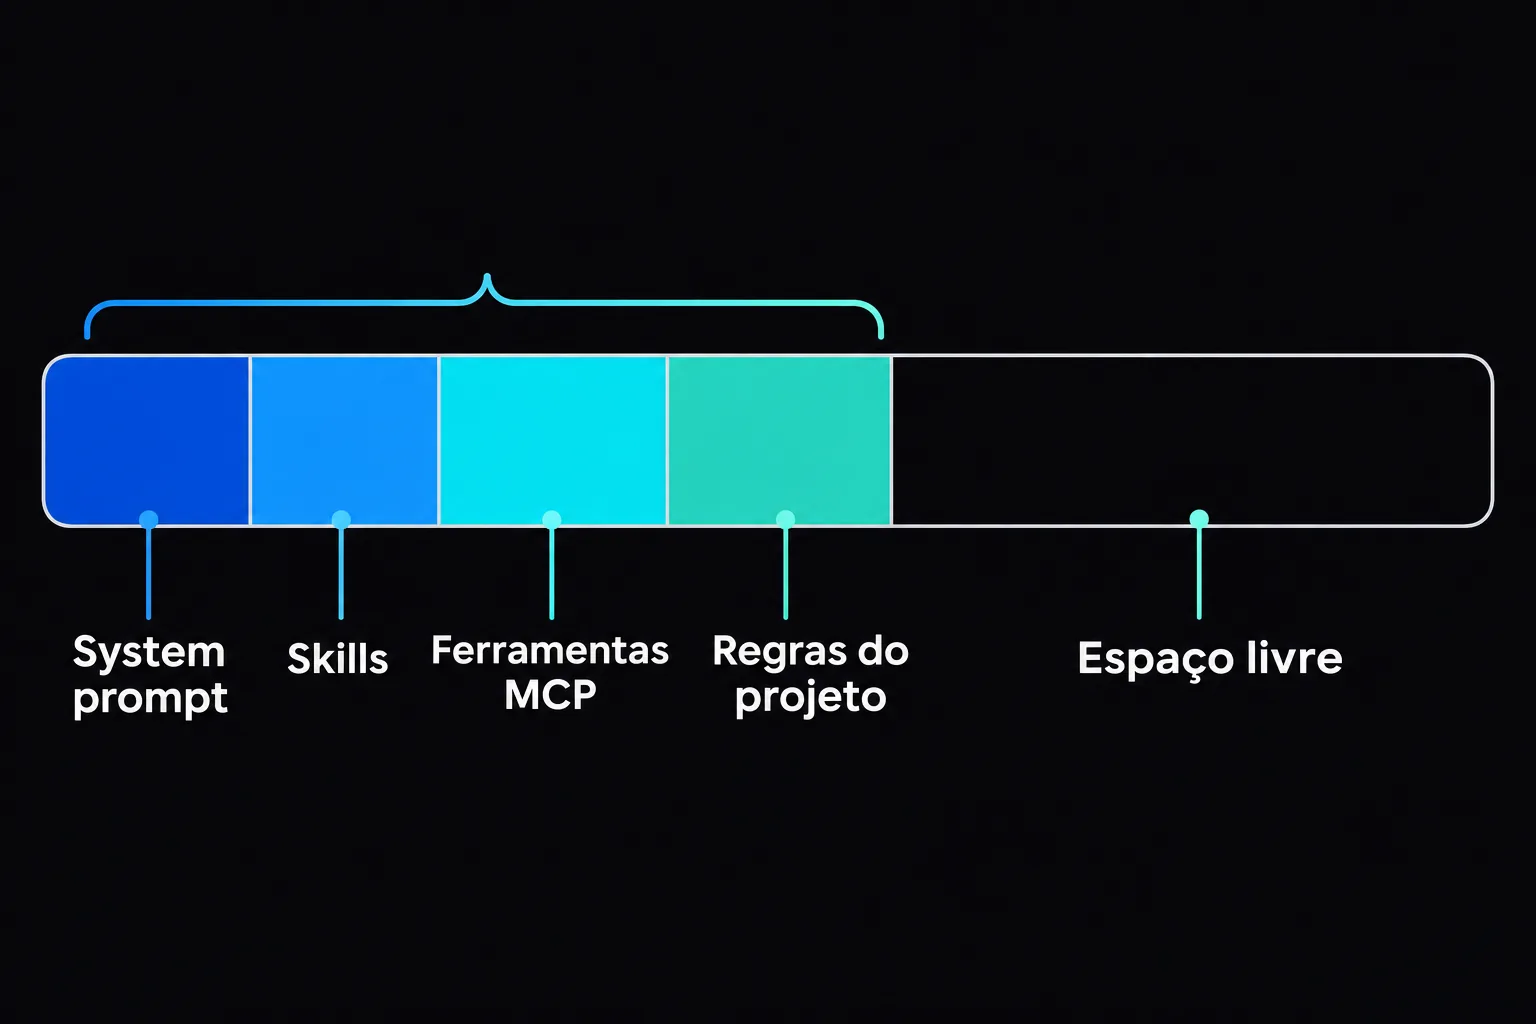
O vídeo da Better Stack detalha a parte fixa, a que existe antes de qualquer mensagem sua. Segundo o apresentador, num modelo Claude típico o system prompt ocupa 8,3% da janela e as definições das ferramentas do sistema outros 1,4%. São leituras de quem gravou, na versão da ferramenta daquele momento, e mudam a cada atualização; o número que vale é o do seu /context. Em cima disso entram, quando existirem:
- as skills carregadas;
- as ferramentas de servidores MCP configurados;
- o arquivo de instruções do projeto, como
AGENTS.mdouCLAUDE.md.
Cada um desses itens cresce com o que você mesmo configura. O system prompt você não controla, mas MCP, skills e regras do projeto você controla.
Quanto pesam MCP e arquivos de regras?
No vídeo de context engineering do IndyDevDan, o /context do Claude Code com Opus mostrava as ferramentas MCP ocupando cerca de 24 mil tokens, 12% da janela, com um .mcp.json padrão carregado em toda sessão. Ao remover esse arquivo, ele recuperou cerca de 20 mil tokens. Um servidor isolado, o de scraping, carregado só quando necessário, custava cerca de 6 mil.
O mesmo vídeo mostra um CLAUDE.md de 23 mil tokens, algo perto de 10% da janela. O próprio autor avisa que exagerou o arquivo de propósito para demonstrar a ideia, então não é um valor típico. O que se aproveita é o mecanismo: tudo que fica no arquivo de regras é pago em toda sessão, mesmo quando a tarefa do dia não precisa daquilo.
Matt Pocock adota a mesma postura por esse motivo. Ele diz ser muito cauteloso ao adicionar servidores MCP e que evita escrever arquivos de regras grandes, justamente por causa da perda de informação no meio da janela, tema da próxima seção.
Por que o desempenho cai quando a janela enche?
Dois fenômenos aparecem nas fontes, e vale separá-los.
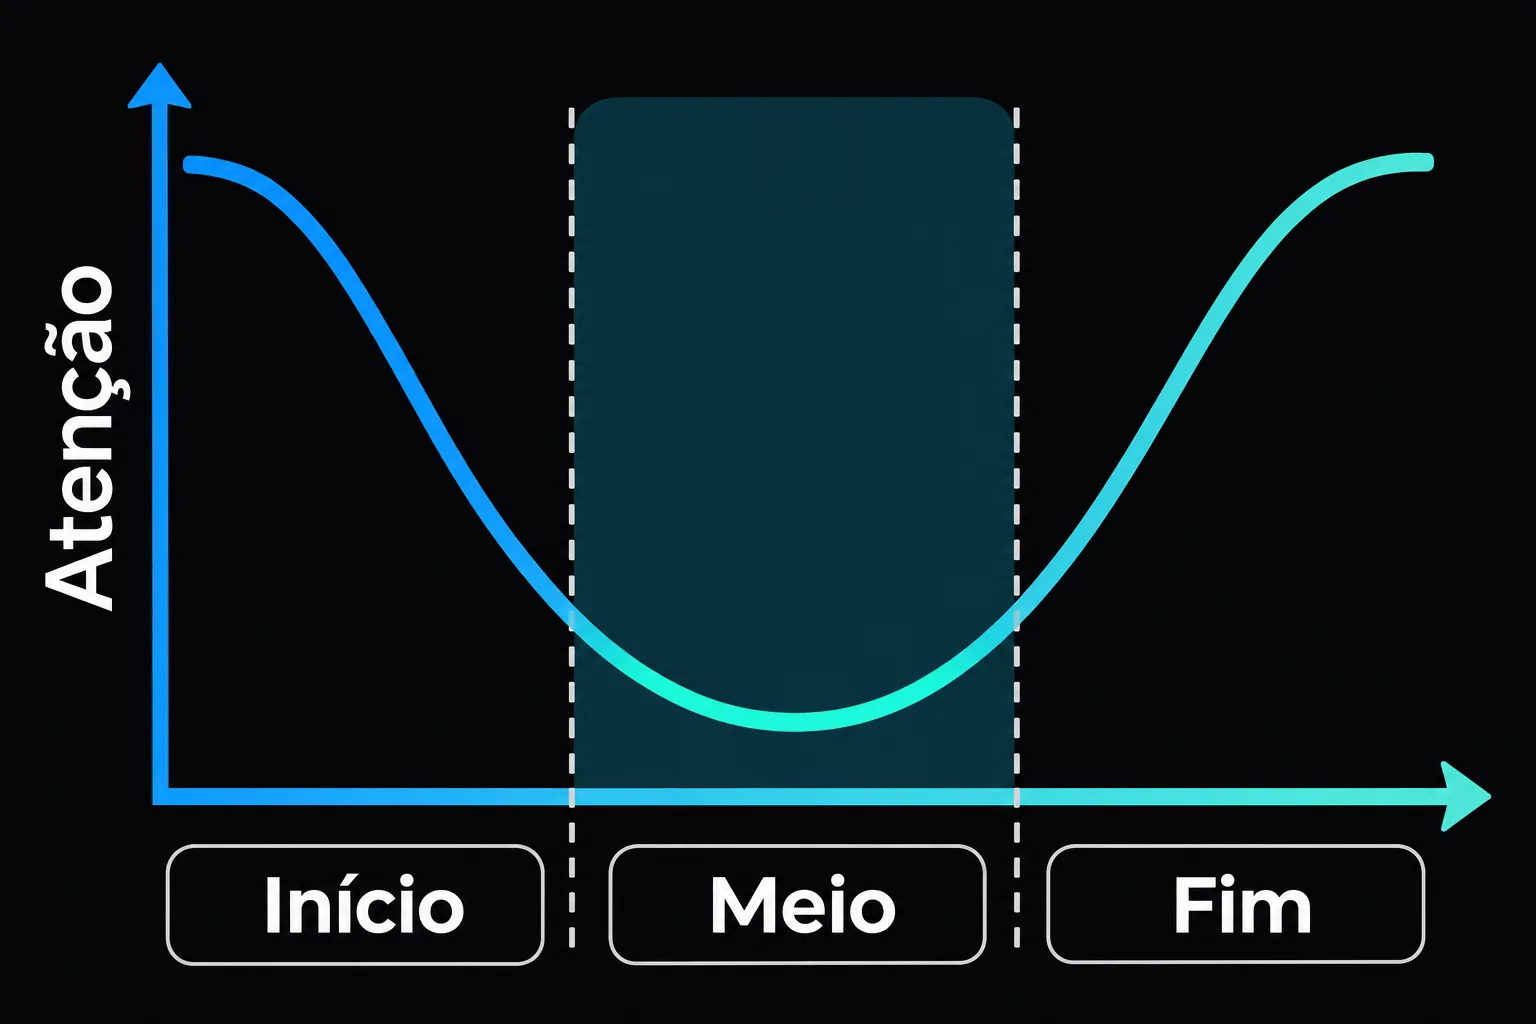
O primeiro é o lost in the middle. Matt Pocock explica que o modelo recupera mal informação enterrada no meio de um contexto longo: o que está no começo e no fim recebe mais peso do mecanismo de atenção, e o miolo recebe menos. Ele descreve isso como uma propriedade emergente do funcionamento desses sistemas, não como um comportamento projetado, e usa um gráfico que ele mesmo chama de pouco científico. Como exemplo, cita o Llama 4 Scout, anunciado pela Meta com janela de 10 milhões de tokens, que segundo ele sofreu de lost in the middle quando as pessoas passaram a testá-lo: aceitava a informação, mas não agia sobre ela.
O segundo é o context rot, nome do relatório técnico que a Chroma publicou em julho de 2025. Os autores testaram 18 modelos, entre eles GPT-4.1, Claude 4, Gemini 2.5 e Qwen3, mantendo fixos a pergunta e o trecho com a resposta e variando só a quantidade de texto irrelevante ao redor. O desempenho caiu com o comprimento da entrada em todos os experimentos, mesmo em tarefas simples. Um único distrator, um trecho parecido com a resposta sem ser ela, já reduziu o acerto, e o efeito dos distratores aumentou com o tamanho da entrada. E um detalhe contraria a intuição do parágrafo anterior: na tarefa de busca do relatório, ao testar 11 posições para a informação procurada, eles não encontraram variação notável por posição. "O meio é pior" não explica tudo; o volume de contexto pesa por conta própria.
Na prática, os dois levam à mesma conclusão: texto irrelevante na janela disputa a atenção do modelo com o que a tarefa precisa.
Existe uma faixa segura de uso?
Ninguém nas fontes mediu uma faixa segura. O que existe é a opinião de quem usa o Claude Code no dia a dia. O apresentador da Better Stack propõe zonas: de 0 a 30% da janela seria a "smart zone", de 30 a 60% o agente ainda vai bem, e a partir de 60% começa a degradar, a "dumb zone". Logo em seguida ele mesmo relativiza: os números não são fixos, a zona boa de um modelo pode ir a 40% ou 50%, e a piora costuma aparecer acima de 80%. E diz que a divisão vem da experiência pessoal dele com o modelo. Use como ponto de partida, não como medida.
Para dar escala, o vídeo compara os primeiros 60 mil tokens de uma janela de 200 mil ao roteiro de Star Wars: Uma Nova Esperança, que tem cerca de 54 mil tokens no GPT-5. Pela régua dele, cabe um roteiro de filme inteiro antes de sair da zona boa.
Dá para transformar isso em código. O exemplo abaixo recebe os itens que você leu no /context, soma o que é fixo e calcula em que zona a sessão está. Os limites são parâmetros, não verdades.
type ContextItem = {
  label: string;
  tokens: number;
  fixed: boolean; // carregado antes do primeiro prompt
};

type Zone = "smart" | "ok" | "degrading";

const WINDOW_SIZE = 200_000;

function zoneOf(
  ratio: number,
  limits = { smart: 0.3, ok: 0.6 },
): Zone {
  if (ratio <= limits.smart) return "smart";
  if (ratio <= limits.ok) return "ok";
  return "degrading";
}

function budgetReport(items: ContextItem[], windowSize = WINDOW_SIZE) {
  const used = items.reduce((sum, item) => sum + item.tokens, 0);
  const fixed = items
    .filter((item) => item.fixed)
    .reduce((sum, item) => sum + item.tokens, 0);

  return {
    used,
    free: windowSize - used,
    fixedRatio: fixed / windowSize,
    zone: zoneOf(used / windowSize),
  };
}

// Exercício ilustrativo: combina percentuais e valores citados nos vídeos
// acima. Não é uma medição de uma sessão real.
const session: ContextItem[] = [
  { label: "system prompt", tokens: 16_600, fixed: true }, // 8,3% de 200 mil
  { label: "ferramentas do sistema", tokens: 2_800, fixed: true }, // 1,4%
  { label: "ferramentas MCP", tokens: 24_000, fixed: true },
  { label: "CLAUDE.md", tokens: 23_000, fixed: true },
];

console.log(budgetReport(session));
// { used: 66400, free: 133600, fixedRatio: 0.332, zone: 'ok' }
A soma desse exercício mostra o ponto: com um MCP grande e um arquivo de regras inflado, mais de 30% da janela estaria ocupada antes de qualquer pedido seu. Pela régua da Better Stack, a sessão já nasceria fora da faixa que o apresentador chama de melhor.
O que fazer quando a janela enche: limpar, compactar ou delegar?
O Claude Code oferece duas saídas dentro da própria sessão. O /clear apaga o histórico e devolve uma janela em branco. O /compact troca o histórico por um resumo gerado pelo próprio modelo. Na demonstração do Matt Pocock, a compactação levou cerca de um minuto, gastou tokens para gerar o resumo e reduziu as mensagens de uns 70 mil tokens para 4 mil, deixando 90% da janela livre. Ele usa o compact para preservar o "clima" da conversa e o clear como padrão quando quer recomeçar. Como regra de bolso própria, ele disse que começa a se preocupar quando restam uns 50 mil tokens.
A Better Stack aponta o risco da compactação: o agente escolhe o que parece importante, mas não sabe o que de fato será necessário na próxima tarefa, e pode perder algo crítico. É essa a motivação do Ralph loop descrito no vídeo, um laço em bash que reexecuta o mesmo prompt para que cada tarefa comece com o contexto limpo, em vez de herdar um resumo.
A terceira saída é delegar. O IndyDevDan mostra subagentes fazendo trabalho pesado, como scraping de documentação, com cerca de 3 mil tokens por agente, e esse consumo não entra no agente principal. A janela do subagente absorve o custo e devolve só o resultado.
Resumindo o trade-off:
| Estratégia | Ganha | Custa |
|---|---|---|
/clear | Janela em branco, sem ruído | Perde todo o histórico da conversa |
/compact | Mantém a intenção da conversa | Tempo, tokens e risco de omitir algo |
| Subagente | Isola o trabalho ruidoso | Precisa de um contrato claro de entrada e saída |
Quando menos contexto não é a resposta?
Reduzir o contexto ajuda, mas não vira regra absoluta. O Cole Medin defende, no vídeo dele, entregar ao assistente informação, exemplos e restrições logo de início, o que para ele separa um resultado real de um vibe coding. As duas posições convivem quando o critério é a relevância: o que atrapalha é o que não serve para a tarefa em curso, e o que serve pode e deve entrar.
Na palestra que fiz no Dev Na Gringa Summit, defendi que os 200 mil tokens do Sonnet e do Opus bastam para programar na maioria dos casos e que, numa tarefa grande, a saída é dividir o trabalho em partes, cada uma com a própria janela. Os motivos e o jeito de fazer essa divisão estão em Context engineering na prática.
Se a ideia de agente como um laço em que o modelo decide parar ainda não está firme, o post O que é (e o que não é) um agente explica esse laço. Para a conta deste post, basta lembrar que cada volta acrescenta à janela a resposta do modelo e o resultado da ferramenta que ele chamou.
Como aplicar na prática
- Rode
/contextem uma sessão nova e veja quanto da janela já está ocupado antes de qualquer pedido. - Remova servidores MCP que você não usa na tarefa e carregue o resto sob demanda.
- Deixe o arquivo de regras só com o que vale para todas as tarefas.
- Limpe a conversa ao trocar de assunto e use compactação só quando o histórico tiver valor.
- Empurre trabalho ruidoso para subagentes.
Se você quer praticar esse tipo de decisão sobre agentes de código, com exercícios de arquitetura e contexto, a Formação em Inteligência Artificial cobre esse caminho.
Referências
- Matt Pocock. Most devs don’t understand how context windows work. YouTube, 2025.
- Better Stack. I Can't Believe Anthropic Messed Up The Ralph Wiggum. YouTube, 2026.
- IndyDevDan. Elite Context Engineering with Claude Code. YouTube, 2025.
- Kelly Hong, Anton Troynikov e Jeff Huber. Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma, julho de 2025.
- Cole Medin. Context Engineering 101: The Simple Strategy to 100x AI Coding. YouTube, 2025.
- Rodrigo Branas. A inteligência artificial não vai roubar seu emprego (ainda), Dev Na Gringa Summit. YouTube, 2026.
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial14 nov 2026 8 min
Prompt injection indireto em agentes e as defesas
Prompt injection indireto acontece quando o agente lê um texto com instruções do atacante. Veja o ataque, o que os benchmarks mediram e as defesas em camadas.
- Inteligência Artificial13 nov 2026 7 min
IA em sistema grande funciona? A pergunta está errada
IA em sistema grande funciona? O LLM nunca lê a base inteira: o que pesa é a qualidade do design e a sua capacidade de reduzir o contexto de cada tarefa.
- Inteligência Artificial13 nov 2026 6 min
Context engineering: a informação certa na hora certa
Context engineering é entregar ao agente a informação certa, no formato certo, no momento certo. Veja as memórias de curto, médio e longo prazo.

