Accessibility tree ou screenshot para agentes de IA
Quando um agente de IA opera uma interface, a primeira decisão de projeto é o que ele recebe como observação: a árvore de acessibilidade (accessibility tree) da tela ou um screenshot. A escolha muda custo, velocidade e o tipo de erro que o agente comete, e um erro frequente é tratá-la como uma disputa em que uma das opções precisa vencer.
Este post compara as quatro famílias de observação (pixels, árvore de acessibilidade, híbrido e declarativo/código), mostra onde cada uma falha e propõe um roteador em TypeScript que escolhe o canal por chamada. Para o laço em que essa observação entra, veja O que é (e o que não é) um agente.
O que o agente recebe quando "olha" a tela?
Uma tela é a renderização de um estado: arquivos, DOM, memória do processo, backend da aplicação. O agente nunca vê esse estado diretamente. Ele recebe um canal, e existem dois tipos básicos.
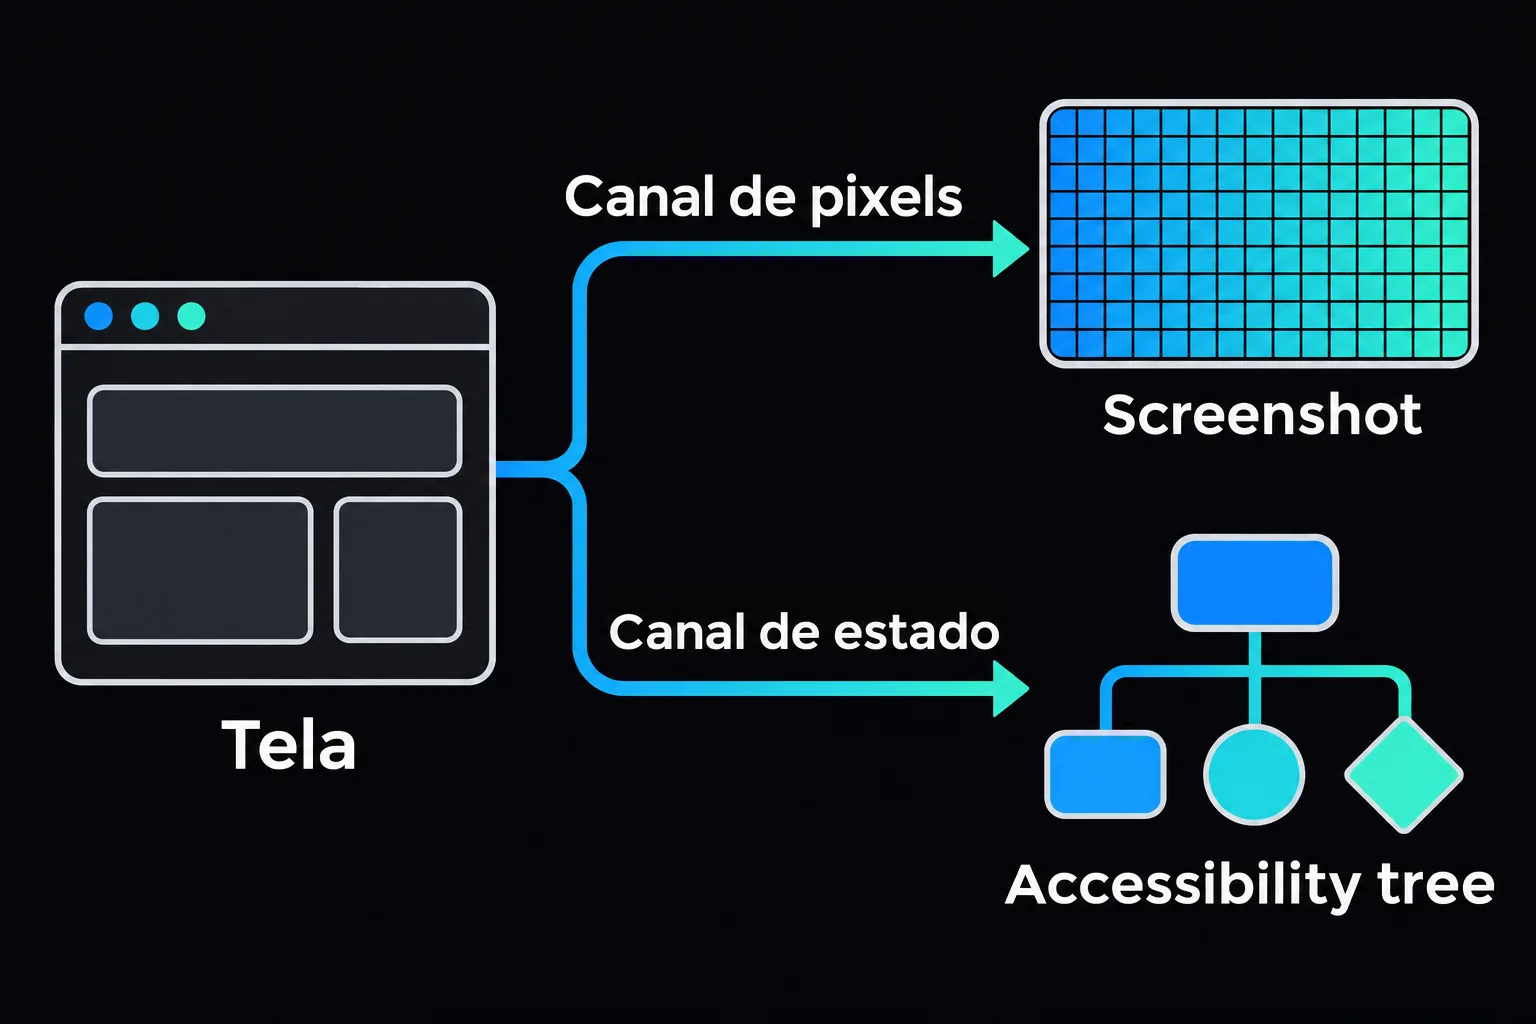
O canal de pixels é a imagem renderizada. O canal de estado é uma consulta sobre a mesma máquina: percorrer a árvore de acessibilidade, serializar o DOM, ler uma célula de planilha, listar um diretório.
A diferença importa porque a renderização perde informação. Duas telas idênticas podem vir de estados diferentes: o total exibido numa planilha pode ser uma fórmula ou um valor digitado, e uma linha relevante pode estar fora da área visível. O artigo StateAct (2026) usa esse argumento: a entrega de uma tarefa em desktop é uma mudança de estado, não uma imagem dela.
A árvore de acessibilidade é o canal de estado mais direto quando o aplicativo não oferece API. Ela é o mapa estruturado que o sistema operacional ou o navegador expõe para leitores de tela: cada controle com papel (button, textbox), nome, valor, estado e as ações que aceita. No macOS é a API de Accessibility, no Windows é o UI Automation, no Linux é o AT-SPI2 e, na web, o navegador deriva a árvore do DOM e dos atributos ARIA.
Quais são as quatro famílias de observação?
| Família | O que o modelo recebe | Ação típica | Força | Falha típica |
|---|---|---|---|---|
| Pixels | Screenshot, às vezes com caixas numeradas ou OCR | Clicar em (x, y) | Funciona em qualquer coisa visível | Muitos tokens, sensível a DPI, incerteza de coordenada |
| Árvore AX | Papéis, nomes, valores, estados | Invocar ou preencher por id | Determinística e estável a tema e resolução | Árvore incompleta, velha ou vazia |
| Híbrido | Candidatos fundidos de árvore, OCR e visão | Ação semântica, ou coordenada se não houver | Cobertura sem abandonar a estrutura | Canais que discordam, ranking que descarta o nó certo |
| Declarativo / código | Estado em esquema, arquivo, API, DOM | set_value, chamada de API, script | Trajetórias curtas e artefato verificável | Exige um caminho de acesso |
A divisão em quatro famílias resume o que propõem artigos como LUMOS, Tactile, ASIL e StateAct. Nenhuma família substitui as outras, e as próximas seções mostram por quê.
Quando o screenshot é a resposta certa?
O screenshot é o canal universal. Se há algo desenhado na tela, ele existe numa imagem, e é por isso que os agentes de computer use baseados em captura de tela cobrem aplicativos que ninguém preparou para automação: jogos, editores de imagem, uma área de desenho, um desktop remoto.
O preço vem em três itens. O primeiro é a ambiguidade: uma imagem mostra o botão "Enviar", mas não garante que ele esteja habilitado nem diz como confirmar que o clique funcionou. O segundo é a geometria: o mesmo botão muda de coordenada com o DPI e o zoom, e o agente precisa converter. O terceiro é o custo em tokens.
Sobre o custo, um relato de Anup Karanjkar, de julho de 2026, faz a conta com a documentação de visão da Anthropic: uma imagem custa ⌈largura/28⌉ × ⌈altura/28⌉ tokens visuais, com teto de 4.784 nos modelos de alta resolução. Em 31 passos no teto, são 148.304 tokens, ou US$ 0,74 ao preço do Opus 5 (US$ 5 por milhão de tokens de entrada), para extrair sessenta linhas de texto que o aplicativo já tinha em memória, estruturadas. É a conta de um autor, com os preços de julho de 2026, e serve para ilustrar a ordem de grandeza, não como medição geral.
O que a accessibility tree entrega, e onde ela quebra?
No navegador, o exemplo mais direto é o servidor MCP do Playwright. A documentação oficial descreve que ele deixa o modelo interagir com páginas por snapshots de acessibilidade estruturados, sem precisar de screenshots nem de modelos de visão. Cada nó recebe uma referência (ref), e a ação seguinte usa essa referência em vez de coordenadas:
- heading "Pedido #4821" [level=1] [ref=e10]
- textbox "CEP" [ref=e11]
- button "Calcular frete" [ref=e12]
- checkbox "Entrega expressa" [checked] [ref=e13]
Duas coisas fazem esse formato valer a pena. A ação é semântica: "clicar em e12" não depende de resolução. E a verificação é barata: no próximo snapshot, [checked] aparece ou não aparece.
Os mesmos mecanismos explicam as falhas.
A árvore pode não existir. Um canvas aparece como um único elemento. O estudo Screen2AX (2025) auditou aplicativos de macOS: nos 99 aplicativos gratuitos mais populares, 17,7% não tinham metadados de acessibilidade, 45,9% tinham metadados parciais e 36,4% tinham metadados completos. Numa amostra aleatória de 452 aplicativos da Mac App Store e do Brew Cask, 32,7% não tinham nada e só 29,4% eram completos. A árvore é o tipo certo de objeto, mas a cobertura é irregular.
A árvore também pode estar velha. A referência do QASkills sobre snapshots do Playwright MCP lista como primeira armadilha agir sobre refs velhas: elas valem para o snapshot em que nasceram, e depois de qualquer ação é preciso tirar um snapshot novo. Páginas reais animam, hidratam e buscam dados de novo, então um snapshot tirado no meio de uma animação pode nem conter o elemento.
E a árvore pode ganhar de uma tela que está certa. O artigo Do GUI Agents Believe Their Eyes? (2026) montou 735 sondagens em web, mobile e desktop, em que a estrutura e os pixels discordam. Os modelos acertam o que veem na imagem isolada, mas, diante do conflito, tendem a copiar o texto da estrutura. Com snapshots desatualizados de páginas reais, seguem a estrutura velha em até 88% das sondagens, e a recuperação em tarefas de vários passos fica em no máximo 3%. É o mesmo padrão de prompt injection indireto: um nó injetado ou obsoleto vira a verdade do agente.
E o híbrido e o declarativo?
O híbrido nasce da constatação de que a árvore às vezes falha em partes da tela. O projeto Tactile usa uma escada: primeiro a árvore de acessibilidade; depois o OCR, quando o texto visível é o melhor localizador; por fim o controle por screenshot, para canvas, editores de mídia e ícones sem nome. Os candidatos só são fundidos quando apontam o mesmo alvo.
O declarativo ou código vai além: quando existe um caminho de acesso, a observação sai da tela. O artigo ASIL propõe que o agente leia e escreva o estado do aplicativo por arquivo, script ou API, com ações como set_value e api_call. O StateAct segue a mesma linha: o agente principal trabalha em arquivos, backends de aplicação e DOM, e um subagente de interface gráfica só entra para o que é puramente visual. Segundo o artigo, isso ocorreu em 28 de 108 tarefas e em 1,1% dos passos do agente principal.
O limite é óbvio: se a tarefa é editar uma foto, o resultado está nos pixels e nenhuma consulta de estado o substitui.
Como combinar as quatro: um roteador por chamada?
Os estudos convergem em um ponto: produção não escolhe uma família na inicialização, escolhe por chamada. Um fornecedor de automação de desktop, o Terminator, relata que a árvore cobre cerca de 95% dos cliques em aplicativos de negócio e a visão fica com os 5% restantes. Esse número é de quem vende a ferramenta, não de uma medição independente, então use-o como relato e meça a proporção nos seus aplicativos.
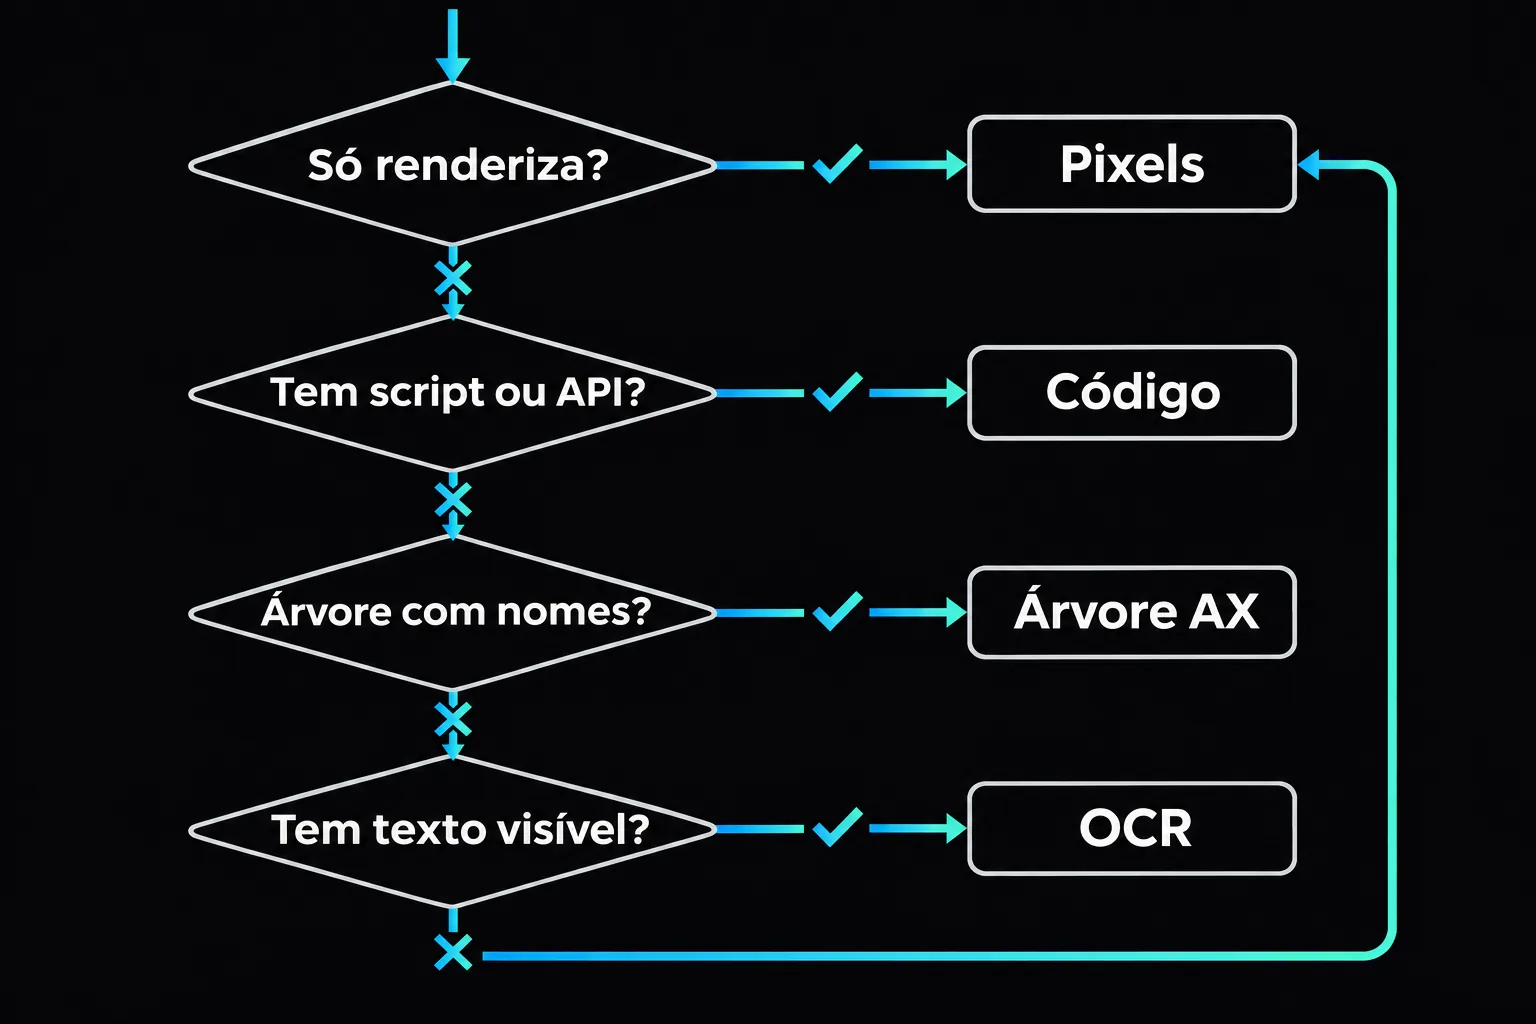
Um roteador mínimo recebe o que se sabe sobre a superfície e devolve o canal:
type Surface = {
  hasScriptPath: boolean; // arquivo, API ou consulta ao DOM
  hasAxProvider: boolean; // o app expõe uma árvore
  namedRatio: number; // fração de controles interativos com nome (0 a 1)
  hasVisibleText: boolean; // OCR tem o que ler
  renderOnly: boolean; // canvas, jogo, edição de imagem
};

type Channel = "code" | "ax" | "ocr" | "pixels";

function pickChannel(s: Surface): Channel {
  if (s.renderOnly) return "pixels";
  if (s.hasScriptPath) return "code";
  if (s.hasAxProvider && s.namedRatio >= 0.8) return "ax";
  if (s.hasVisibleText) return "ocr";
  return "pixels";
}

type AxNode = { ref: string; role: string; name: string };
type Snapshot = { id: number; nodes: AxNode[] };

function clickRef(snapshot: Snapshot, latestId: number, ref: string): string {
  if (snapshot.id !== latestId) {
    throw new Error("snapshot velho: observe de novo antes de agir");
  }
  const node = snapshot.nodes.find(n => n.ref === ref);
  if (!node) throw new Error(`ref ${ref} não existe neste snapshot`);
  return `click ${node.role} "${node.name}"`;
}
O limiar de 0,8 é um valor de exemplo: ajuste-o com uma amostra de telas do seu produto. A segunda função mostra a regra que evita um erro comum da árvore, a referência velha: a ação só passa se o snapshot ainda for o mais recente.
O roteador ainda precisa de uma cláusula para o conflito. Se a árvore diz que o botão está habilitado e a imagem mostra o oposto, o que o agente faz? O resultado de 88% acima mostra que confiar na estrutura por padrão é arriscado. Das quatro mitigações que o artigo Do GUI Agents Believe Their Eyes? compara, só uma reduziu ao mesmo tempo o sequestro da ação e o erro na tarefa: um portão de consistência, sem treino, que detecta o conflito e volta a ancorar a decisão antes de agir.
Quando usar cada um, e o que ainda precisa de screenshot?
- Aplicativo web ou desktop com acessibilidade boa: comece pela árvore. É o caminho mais barato e, como o README do Playwright MCP lembra, evita a ambiguidade dos screenshots.
- Existe API, arquivo ou script: use o canal de código e deixe a interface para o resto. A tarefa vira uma chamada verificável.
- Texto visível, árvore fraca: OCR como degrau intermediário.
- Canvas, jogo, editor de imagem, vídeo: pixels, e aceite o custo.
- Conteúdo que muda entre as ações: a observação por snapshot não ajuda. O artigo AOI (2026) lembra que os agentes atuais tiram um screenshot a cada 3 a 5 segundos e ficam cegos entre eles; com uma camada de observação contínua, modelos de 7B a escala de fronteira ganharam de 17 a 48 pontos percentuais no DynaCU-Bench, sem retreino.
Duas observações valem para qualquer família. A primeira: re-observe depois de toda ação que muda estado, porque os identificadores podem ter mudado. A segunda: a árvore só é tão boa quanto a acessibilidade do software. Um botão sem nome falha para o leitor de tela e para o agente, e consertar o nome ajuda os dois.
Se você quer construir esse tipo de agente com critério de engenharia, a Formação em Inteligência Artificial trabalha esses temas.
Referências
- Microsoft. Playwright MCP server. GitHub, 2026.
- Anup Karanjkar. Everyone Is Teaching AI Agents to Look. macOS Already Lets Them Read. Mac O'Clock, julho de 2026.
- LUMOS: A Semantic Operating-System Layer for Accessibility-Grounded AI Agents. arXiv:2606.30697, 2026.
- Screen2AX: Vision-Based Approach for Automatic macOS Accessibility Generation. arXiv:2507.16704, 2025.
- Do GUI Agents Believe Their Eyes? Diagnosing State-Belief Reliance on Pixels versus Structure. arXiv:2607.04334, 2026.
- Agent-Computer Observation Interfaces Enable Dynamic Computer Use. arXiv:2606.29472, 2026.
- Terminator. Accessibility tree vs screenshot desktop automation: it is a router, not a binary choice, 2026.
- QASkills. Playwright MCP Accessibility Snapshots: Complete Reference 2026.
- Chrome for Developers. Full accessibility tree in Chrome DevTools.
- StateAct: Program State Before Pixels for Long-Horizon Computer-Use Agents. arXiv:2607.22798, 2026.
- Tactile: Giving Computer-Using Agents Hands and Feet. arXiv:2607.14443, 2026.
- ASIL: Replacing Screenshot and Click with Structured State and Semantic Actions. arXiv:2608.26991, 2026.
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial22 nov 2026 7 min
Git worktree para agentes em paralelo, sem colisão
Como usar git worktree para rodar agentes de código em paralelo sem colisão: comandos reais, best-of-N e as pegadinhas de porta, node_modules, .env e banco.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.
- Inteligência Artificial20 nov 2026 7 min
Clustering de texto: embedding e LLM na zona cinzenta
Clustering de texto com embedding e cosseno, mandando só os pares ambíguos a um classificador LLM, e por que o centróide cria grupos gigantes.

