Autocorreção de LLM: o verificador deve ser externo
A autocorreção de LLM parece um jeito barato de ganhar confiabilidade: você pede para o modelo revisar a própria resposta e corrigir o que estiver errado. É um dos padrões mais repetidos em agentes. Em tarefas de raciocínio, porém, o resultado medido é ruim. Sem um sinal externo dizendo o que está certo, o modelo tende a trocar respostas certas por erradas com mais frequência do que conserta as erradas. O que muda o resultado é quem decide se a resposta passa.
Abaixo, o que três papers de 2023 e 2024 mediram e um loop em TypeScript em que o modelo gera e um código determinístico aprova.
O que acontece na autocorreção de LLM quando o modelo revisa a própria resposta?
Huang et al. (Google DeepMind e Universidade de Illinois), em "Large Language Models Cannot Self-Correct Reasoning Yet", chamam de autocorreção intrínseca o cenário em que o modelo tenta corrigir a resposta inicial usando só as próprias capacidades, sem feedback externo. O fluxo testado tem três passos: gerar, pedir ao modelo que revise a própria resposta e pedir que responda de novo levando a revisão em conta. Os autores rodaram até duas rodadas em três benchmarks de raciocínio: GSM8K, CommonSenseQA e HotpotQA.
Segundo o paper, depois da autocorreção a acurácia de todos os modelos caiu em todos os benchmarks. O caso mais forte é o GPT-3.5 no CommonSenseQA, que acertava 75,8% com um único prompt e passou a acertar 38,1% depois de uma rodada de revisão. O GPT-4, que muda menos de ideia, também perdeu pontos. No GSM8K, entre as respostas que o GPT-3.5 mudou, a troca de certo por errado foi mais comum do que o contrário. Para os autores, o modelo não consegue julgar se o próprio raciocínio está correto.
Trabalhos anteriores relataram ganhos porque usavam o gabarito para decidir quando parar o loop: se a resposta já estava certa, a revisão não mexia nela. Aí quem corrige é o gabarito. Os próprios autores comentam que, se você já tem a resposta certa em mãos, há pouca razão para pedir a um LLM que resolva o problema.
Por que o modelo falha como verificador?
Stechly, Valmeekam e Kambhampati (Arizona State), em "On the Self-Verification Limitations of Large Language Models on Reasoning and Planning Tasks", isolaram o papel de verificador. Escolheram problemas cuja resposta dá para checar automaticamente: Game of 24, coloração de grafos e planejamento no estilo STRIPS, com o Blocksworld e uma versão de nomes disfarçados, o Mystery Blocksworld. Foram 100 instâncias por domínio. No sistema que chamam de LLM+LLM, o GPT-4 responde, o mesmo GPT-4 critica a resposta e a crítica volta como novo prompt.
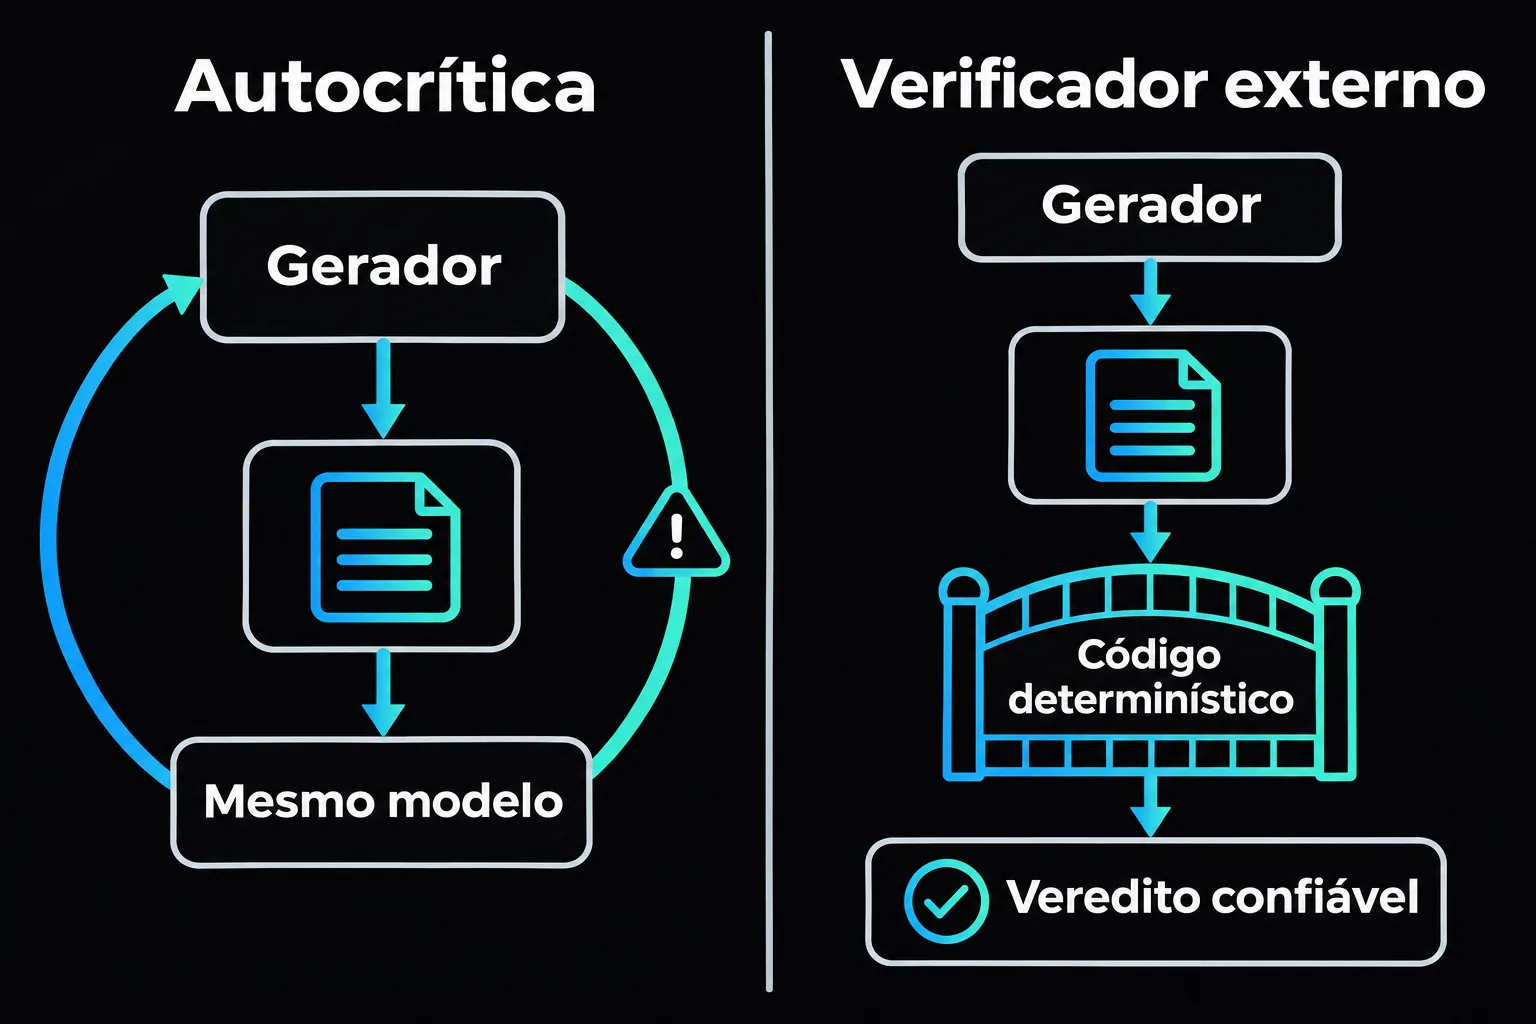
Na coloração de grafos, o GPT-4 com um único prompt acertou 16% das instâncias. Com o loop de autocrítica, caiu para 2%. O paper atribui a queda à taxa de falso negativo do modelo como verificador: das 118 colorações corretas que ele avaliou, rejeitou 113, ou 95,8%. O loop descarta a resposta certa e termina com uma tentativa pior.
O paper registra uma exceção. No Blocksworld, onde o modelo erra menos ao verificar, o LLM+LLM melhorou um pouco, mas ficou bem abaixo do que um verificador sólido alcança no mesmo domínio. A qualidade do verificador interno muda de um domínio para outro, e você não sabe de antemão em qual caso está.
O que muda quando o verificador é sólido?
Verificador sólido, aqui, é a tradução do sound verifier do paper: um programa que confere a resposta contra a definição do problema e devolve o veredito certo. Com ele no lugar do modelo-verificador, o mesmo gerador melhora em todos os domínios. Na coloração de grafos, o GPT-4 chegou a 38% recebendo do verificador só a mensagem de que a resposta anterior estava errada, sem dizer onde.
O resultado menos intuitivo está na ablação. Os autores tiraram a crítica do loop: o modelo recebia sempre o mesmo prompt, sem histórico das tentativas, até o verificador sólido aprovar alguma resposta. Esse re-sorteio manteve a maior parte do ganho e, com 25 tentativas, superou as versões com feedback no Game of 24 e na coloração de grafos. A conclusão do paper é que o benefício vem da solidez do verificador e que é fácil atribuí-lo por engano a uma autocrítica sofisticada ou a um feedback detalhado.
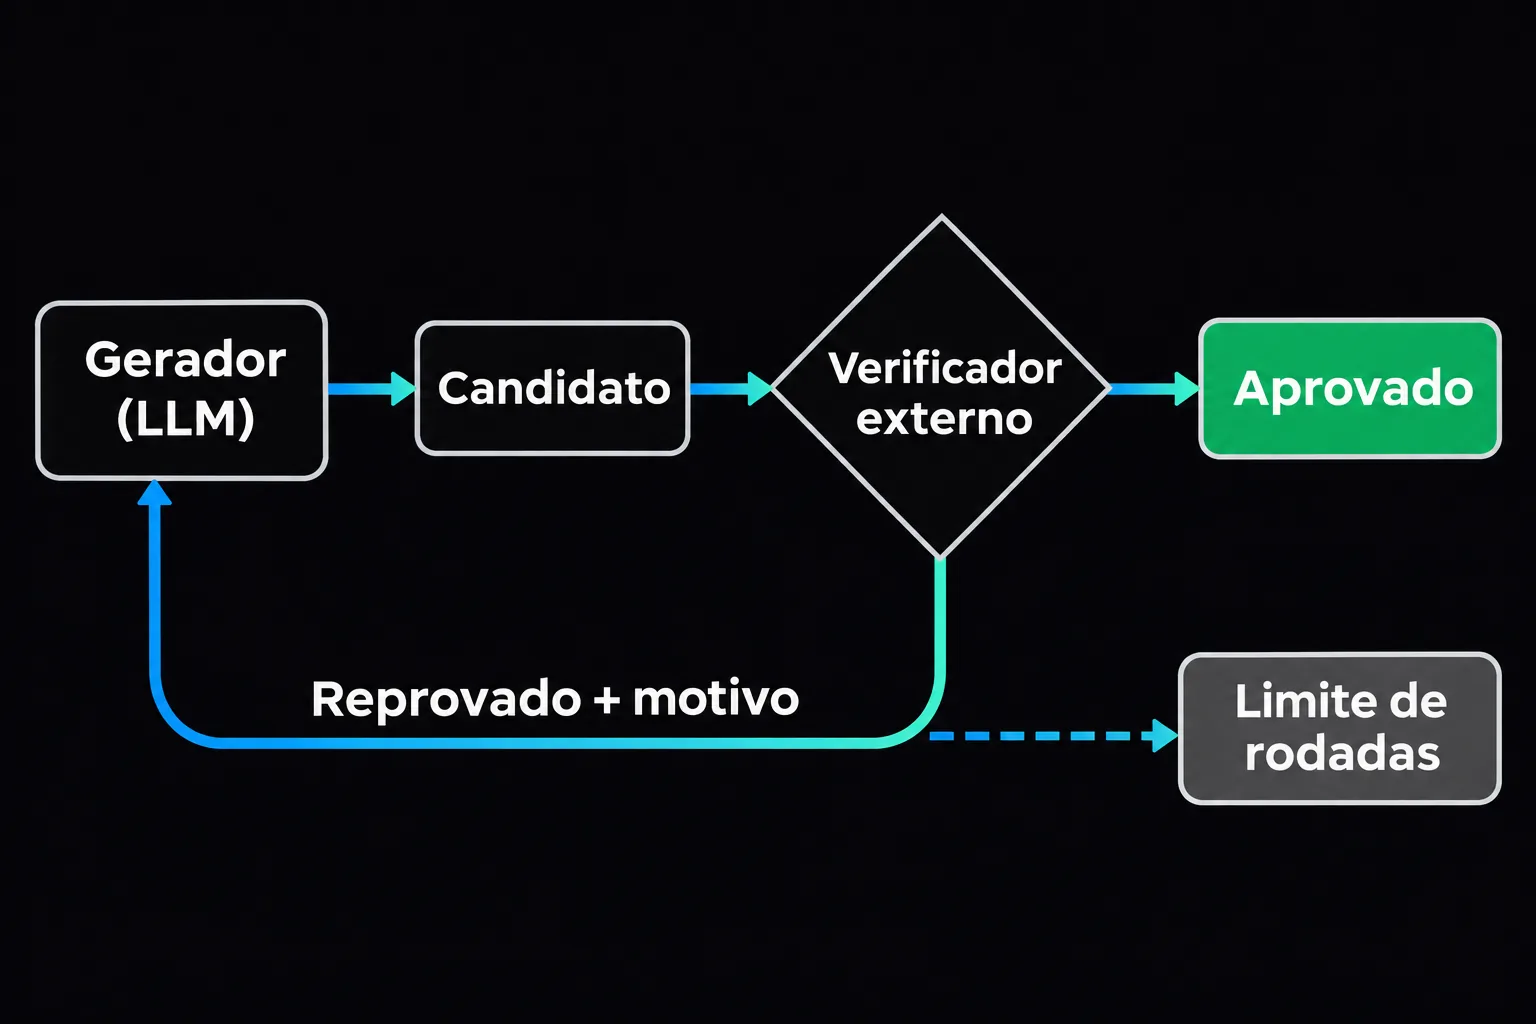
O paper de planejamento de Valmeekam et al., "On the Planning Abilities of Large Language Models", chega ao mesmo ponto por outro caminho. Os autores pegaram 50 instâncias de Blocksworld em que o GPT-4 tinha errado e passaram cada plano pelo validador VAL, devolvendo o erro como novo prompt, com limite de 15 rodadas. O GPT-4 acertou 82% delas. No Mystery Blocksworld, com os nomes disfarçados, acertou 5 de 50. O verificador filtra erros, mas só aproveita a capacidade que o gerador já tem.
Como fica um loop gerar-verificar em código?
A arquitetura que Stechly et al. recomendam, detalhada por Kambhampati e coautores num position paper da ICML 2024, se chama LLM-Modulo: o modelo propõe candidatos e verificadores externos sólidos validam. O desenho mínimo separa dois papéis. O gerador pode ser qualquer chamada de LLM. O verificador é uma função pura que devolve aprovado ou o motivo da rejeição.
type Verdict = { ok: true } | { ok: false; reason: string };
type Verifier<T> = (candidate: T) => Verdict;

type Outcome<T> =
  { status: "verified"; value: T; rounds: number } | { status: "exhausted"; rounds: number };

async function generateUntilVerified<T>(
  generate: (feedback: string | null) => Promise<T>,
  verify: Verifier<T>,
  maxRounds = 15
): Promise<Outcome<T>> {
  let feedback: string | null = null;
  for (let round = 1; round <= maxRounds; round++) {
    const candidate = await generate(feedback);
    const verdict = verify(candidate);
    if (verdict.ok) return { status: "verified", value: candidate, rounds: round };
    feedback = verdict.reason; // pode ser só "a resposta anterior está errada"
  }
  return { status: "exhausted", rounds: maxRounds };
}
O estado exhausted faz parte do contrato. Com um verificador sólido, o loop nunca devolve uma resposta errada como se fosse certa: ou entrega uma resposta aprovada, ou admite que não conseguiu. A falha fica visível, e você decide se escala para um humano ou tenta outro modelo.
Para o Game of 24, o verificador cabe em poucas linhas de código determinístico. Ele lê a expressão, calcula com frações exatas para não depender de ponto flutuante, confere se os números usados são os do enunciado e compara o resultado com 24.
// evaluate: parser recursivo que devolve uma fração exata (denominador positivo)
// e registra os números usados. Implementação omitida; a parte que decide é o game24.
declare function evaluate(expr: string, used: number[]): { n: bigint; d: bigint };

const game24 =
  (numbers: number[]): Verifier<string> =>
  expr => {
    try {
      const used: number[] = [];
      const value = evaluate(expr, used);
      if ([...used].sort().join() !== [...numbers].sort().join())
        return { ok: false, reason: `use exatamente os números ${numbers.join(", ")}` };
      return value.n === 24n * value.d ? { ok: true } : { ok: false, reason: `${expr} não dá 24` };
    } catch (e) {
      return { ok: false, reason: (e as Error).message };
    }
  };
Pela ablação, o texto do reason pesa pouco no resultado, e dá para devolver só que a resposta está errada. O que precisa ficar fora do modelo é a decisão de aprovar.
E um segundo agente avaliador, ou um debate entre modelos?
Separar gerador e avaliador em dois agentes evita que o mesmo contexto aprove o próprio trabalho. Um segundo LLM, porém, continua sendo um verificador sem garantia: pode rejeitar respostas certas, como na coloração de grafos, e aprovar respostas erradas. Ele funciona como camada adicional, para critérios que código não alcança, como clareza ou aderência a um estilo, por cima de uma checagem determinística.
Huang et al. também testaram a versão em que três instâncias do GPT-3.5 debatem a resposta no GSM8K. O debate melhorou em relação ao prompt único, mas, com o mesmo número de respostas geradas, perdeu para a autoconsistência, que só gera várias respostas e escolhe a mais votada. Para os autores, o ganho do debate vem da consistência entre gerações, e não de correção de erro.
Em agentes de código, o verificador sólido costuma ser o que o projeto já tem: compilador, lint, suíte de testes, checagem de tipos. O loop acima vira um hook que roda o comando e lê o código de saída em vez de aceitar o "pronto" do agente. A solidez é relativa à especificação. Um teste ausente não reprova nada, e um verificador sólido para o critério errado aprova a coisa errada sem hesitar. Para o que fica entre código e juízo, os posts sobre LLM-as-judge ou teste determinístico e sobre vieses e calibração do juiz mostram como escolher e calibrar o avaliador.
Quando a autocorreção ainda ajuda?
Os resultados acima são de raciocínio. Liu et al., em "On the Intrinsic Self-Correction Capability of LLMs", estudam autocorreção intrínseca em tarefas de moralidade, como desintoxicação de texto e mitigação de viés social em perguntas de múltipla escolha. Segundo os autores, repetir instruções de autocorreção reduz a incerteza do modelo, e o desempenho converge para um patamar estável. O paper deixa raciocínio de fora de propósito, por causa da discordância sobre a eficácia da autocorreção nesse campo. A leitura é de escopo: em estilo e alinhamento, sem gabarito formal, a autocorreção pode ajudar; com resposta verificável, use o verificador.
Os papers de raciocínio testam modelos de 2023 e 2024, como GPT-3.5, GPT-4 e Llama-2, e modelos mais novos podem ter outra magnitude. Antes de confiar num verificador interno, meça a taxa de falso negativo dele contra um verificador sólido, no seu domínio.
Um resumo de decisão:
- Tem verificador determinístico para o critério (teste, tipo, validador, cálculo exato): coloque-o como portão e deixe o modelo só gerar.
- Não tem, mas o critério se decompõe em perguntas fechadas: use um juiz de LLM calibrado como camada adicional, com amostra humana para medir o erro.
- Critério subjetivo e sem gabarito: a autocorreção intrínseca pode ajudar, mas trate o resultado como estimativa.
Gerar, verificar e reparar, com o verificador fora do gerador, é um dos eixos do trabalho com agentes na Formação em Inteligência Artificial.
Referências
- Huang, J. et al. Large Language Models Cannot Self-Correct Reasoning Yet. arXiv:2310.01798, 2023 (v2, 2024).
- Stechly, K.; Valmeekam, K.; Kambhampati, S. On the Self-Verification Limitations of Large Language Models on Reasoning and Planning Tasks. arXiv:2402.08115, 2024.
- Valmeekam, K. et al. On the Planning Abilities of Large Language Models: A Critical Investigation. arXiv:2305.15771, 2023.
- Liu, G. et al. On the Intrinsic Self-Correction Capability of LLMs: Uncertainty and Latent Concept. arXiv:2406.02378, 2024.
- Kambhampati, S. et al. Position: LLMs Can't Plan, But Can Help Planning in LLM-Modulo Frameworks. ICML 2024.
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial22 nov 2026 7 min
Git worktree para agentes em paralelo, sem colisão
Como usar git worktree para rodar agentes de código em paralelo sem colisão: comandos reais, best-of-N e as pegadinhas de porta, node_modules, .env e banco.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial20 nov 2026 7 min
Clustering de texto: embedding e LLM na zona cinzenta
Clustering de texto com embedding e cosseno, mandando só os pares ambíguos a um classificador LLM, e por que o centróide cria grupos gigantes.

