Clustering de texto: embedding e LLM na zona cinzenta
Clustering de texto, ou agrupar textos por significado, parece um problema resolvido pelo embedding: você vetoriza tudo, mede o cosseno e junta o que estiver perto. Na prática, dois posts que descrevem a mesma dor, escritos por pessoas diferentes, raramente chegam perto o bastante para um limiar único decidir. Este post mostra uma divisão de trabalho em que o embedding resolve os casos fáceis, um classificador LLM resolve os ambíguos e o código controla a deriva dos grupos.
Os números abaixo vêm de um experimento interno: 2.925 ideias de produto extraídas de posts do Reddit e agrupadas em necessidades. Ele foi medido sem gabarito humano. Os limiares foram escolhidos lendo os grupos que saíam, não comparando com rótulos feitos por pessoas. Trate os valores como ponto de partida para o seu caso, não como resultado validado.
Por que não comparar todos os pares com um modelo?
A saída mais simples seria perguntar a um modelo, para cada par de textos, se eles dizem a mesma coisa. O problema é combinatório. Com 1.586 ideias, são cerca de 1,2 milhão de pares, o que é inviável em tempo mesmo que cada chamada custe pouco. O paper do ClusterLLM (Zhang, Wang e Shang, EMNLP 2023), que usa um LLM para guiar o agrupamento de textos, parte da mesma constatação: percorrer todos os pares do conjunto perguntando ao modelo é intratável, então ele usa a entropia da atribuição de grupo para escolher os casos em que o embedding está mais incerto e só pergunta ao LLM sobre eles.
A saída oposta, só embedding com um corte único de cosseno, falha por outro motivo. A região intermediária de similaridade é onde convivem tanto os pares certos quanto os errados, e um único número obriga a jogar fora um dos dois.
A divisão que funcionou no experimento tem três faixas, definidas pelo cosseno entre o texto novo e o exemplar de cada grupo existente:
| Cosseno | Decisão |
|---|---|
| ≥ 0,80 | funde direto, sem chamar modelo |
| entre 0,50 e 0,80 | pergunta a um classificador LLM |
| < 0,50 | cria um grupo novo |
É o desenho de cascata que o paper FrugalGPT (Chen, Zaharia e Zou, 2023) descreve para chamadas de LLM: a consulta passa por uma lista de modelos em ordem, e só sobe para o próximo, mais caro, quando a resposta do anterior não é confiável. Aqui a primeira etapa é uma conta de cosseno sobre vetores já calculados, e a faixa de cosseno faz o papel do critério de confiança. O custo de dinheiro ficou onde se espera. Para as 2.925 ideias, o embedding (text-embedding-3-small, a US$ 0,02 por milhão de tokens no preço usado no experimento) custou menos de um centavo. A rodada inteira, incluindo os 2.521 pares que o classificador julgou, levou 142 segundos e custou US$ 0,079.
Por que o limiar de manual não funcionou?
A primeira configuração usava zona cinzenta a partir de 0,70 e fusão automática em 0,85, valores que soam razoáveis para quem já viu tabelas de similaridade. Em 592 ideias, ela não agrupou quase nada: foram 558 grupos, só 21 com mais de um texto, e o classificador foi consultado 38 vezes.
A explicação está na distribuição de cosseno desse modelo de embedding. Dois posts sobre a mesma necessidade, em comunidades diferentes e com vocabulário diferente, ficavam entre 0,50 e 0,80. Uma zona cinzenta que começa em 0,70 quase nunca é alcançada.
Baixar o piso para 0,50 e a fusão automática para 0,80 mudou o quadro. As rodadas de calibração usaram amostras de 592 a 620 ideias:
| Zona cinzenta | Fusão automática | Grupos | Com 2+ textos | Pares ao classificador | Fundidos |
|---|---|---|---|---|---|
| ≥ 0,70 | ≥ 0,85 | 558 | 21 | 38 | 32 |
| ≥ 0,50 | ≥ 0,80 | 433 | 76 | 488 | 178 |
Dois cuidados. Primeiro, esses limiares pertencem ao modelo de embedding usado. Outro modelo, outra dimensão ou outro tipo de texto muda a distribuição, então a calibração se refaz por modelo. Segundo, a calibração e a rodada final usaram o mesmo tipo de dado e foram avaliadas por leitura. Se você quiser tratar o limiar como hiperparâmetro de verdade, reserve casos que não participaram da escolha, como discute o post sobre held-out e overfitting ao iterar prompts.
O que o classificador recebe?
A pergunta que vai ao modelo é fechada e tem um alvo claro: os textos A e B descrevem a mesma necessidade subjacente, de modo que um único produto serviria os dois autores? O enunciado manda julgar o trabalho a ser feito e o usuário, e ignorar a redação, o setor e as ferramentas citadas. A saída é uma probabilidade, e o código funde se ela for maior ou igual a 0,7.
Esse corte também veio da leitura dos grupos. Com 0,6, um post sobre leads que somem em empresa de limpeza caiu num grupo sobre handoff de customer success. Subir para 0,7 evitou esse caso. Ainda assim, pares como esses podem passar quando o modelo lê os dois como "falha de comunicação com o cliente". O erro ficou raro, não zero.
Repare que o modelo não clusteriza nada. Ele responde uma pergunta sobre dois textos, e o resto (ordem, comparação, limites de tamanho) é código. É a mesma lógica do post sobre quando usar juiz de LLM em vez de teste determinístico: o modelo entra onde a decisão é semântica, e o código fica com o que dá para verificar.
Por que o centróide cria bolhas?
A intuição natural é comparar cada texto novo com a média dos vetores do grupo, o centróide. Na primeira versão do experimento, isso produziu um grupo de 64 textos espalhados por 26 subreddits, sob o rótulo "qual é sua maior dor com dados de RH?". Os membros iam de conciliação de vendas da Amazon a plano de projeto que nunca bate com a realidade. Surgiu também um segundo grupo de 49 textos sobre visibilidade em gestão de projetos.
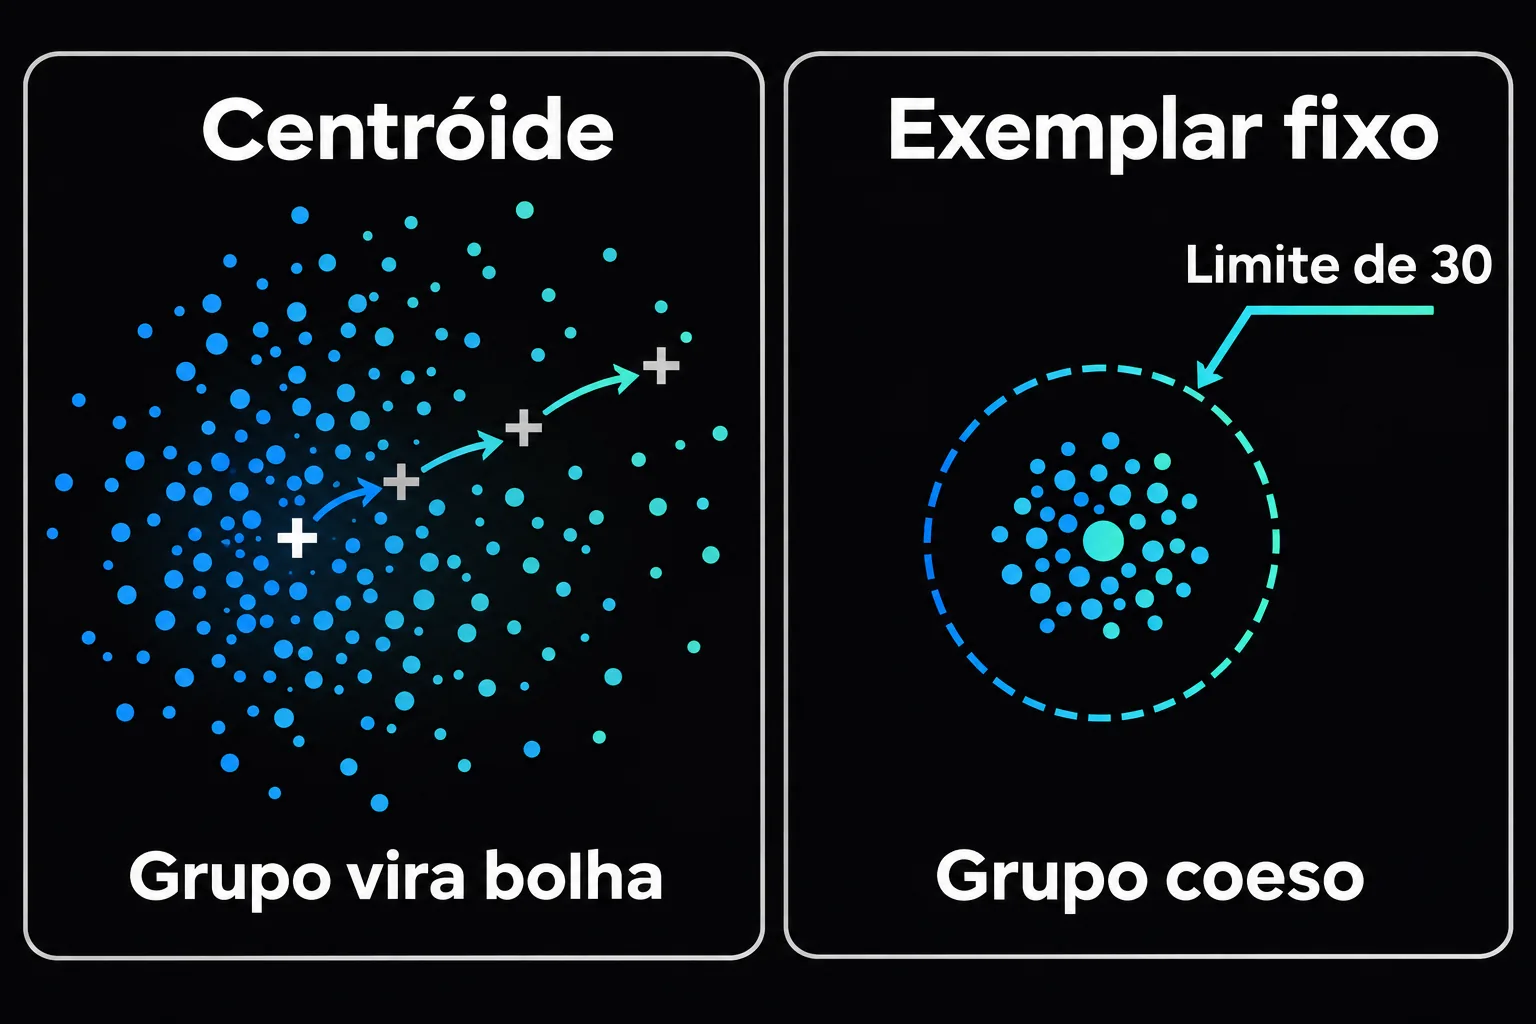
O mecanismo é simples. Um grupo grande tem centróide genérico, e um centróide genérico fica perto de qualquer texto genérico. Cada fusão deixa o centróide ainda mais genérico, o que torna a próxima fusão mais provável. É um ciclo que se alimenta.
Duas mudanças resolveram:
- Comparar com o exemplar, que é o primeiro membro do grupo e não se move. Como os textos são processados do maior rank para o menor, o exemplar é o texto mais forte da necessidade.
- Parar de fundir textos num grupo quando ele chega a 30 membros.
Com as mesmas 2.925 ideias, a versão de centróide deu 2.070 grupos, 325 deles com mais de um texto. A versão final deu 2.043 grupos, 468 com mais de um texto, e o maior ficou com 15 membros em vez de 64. Mais textos agrupados e nenhuma bolha como as anteriores, embora sem gabarito humano para confirmar: a avaliação foi a leitura dos grupos.
Como fica o clustering de texto em código?
Um esqueleto em TypeScript do laço principal. O judge é qualquer função que devolva a probabilidade de os dois textos descreverem a mesma necessidade, e o embedding já vem calculado (e em cache) em cada item.
type Vector = number[];

interface Item {
  id: string;
  text: string;
  embedding: Vector;
  rank: number;
}

interface Cluster {
  exemplar: Item;
  members: Item[];
}

// Devolve a probabilidade de a e b descreverem a mesma necessidade.
type Judge = (a: string, b: string) => Promise<number>;

const FUSE_AT = 0.8;
const SPLIT_BELOW = 0.5;
const JUDGE_MIN = 0.7;
const MAX_SIZE = 30;

function cosine(a: Vector, b: Vector): number {
  let dot = 0;
  let na = 0;
  let nb = 0;
  for (let i = 0; i < a.length; i++) {
    dot += a[i] * b[i];
    na += a[i] * a[i];
    nb += b[i] * b[i];
  }
  return dot / (Math.sqrt(na) * Math.sqrt(nb));
}

async function cluster(items: Item[], judge: Judge): Promise<Cluster[]> {
  const clusters: Cluster[] = [];
  const byRank = [...items].sort((x, y) => y.rank - x.rank);

  for (const item of byRank) {
    let best: Cluster | undefined;
    let bestSim = -1;
    for (const c of clusters) {
      const sim = cosine(item.embedding, c.exemplar.embedding);
      if (sim > bestSim) {
        best = c;
        bestSim = sim;
      }
    }

    if (!best || bestSim < SPLIT_BELOW || best.members.length >= MAX_SIZE) {
      clusters.push({ exemplar: item, members: [item] });
    } else if (bestSim >= FUSE_AT) {
      best.members.push(item);
    } else {
      const p = await judge(best.exemplar.text, item.text);
      if (p >= JUDGE_MIN) best.members.push(item);
      else clusters.push({ exemplar: item, members: [item] });
    }
  }
  return clusters;
}
Como no experimento, cada texto é comparado só com o grupo de exemplar mais parecido, e um grupo cheio deixa de receber membros, seja pela fusão direta ou pelo classificador. A diferença está na vazão. O experimento processava os textos em blocos de 24, comparados com os grupos existentes antes do bloco, com 8 chamadas simultâneas ao classificador. Isso baixou o tempo de cerca de 20 minutos, com decisões sequenciais, para 142 segundos. O preço é que um texto que deveria se juntar a um grupo criado no mesmo bloco acaba virando grupo duplicado, uma perda pequena.
Quais são os limites?
O rótulo de cada grupo é o título do exemplar. Isso funciona quando o exemplar é claro e falha quando ele é retórico. Um modelo gerador nos grupos principais resolveria, e no experimento isso não foi feito.
A ordem importa. Processar do maior rank para o menor favorece exemplares fortes, mas um texto fraco que chega antes do forte da mesma necessidade vira exemplar. O limite de 30 e a comparação com o exemplar reduzem o dano sem eliminá-lo.
Há ainda a contagem. O experimento não guardou o autor de cada post, então "três textos em três comunidades" pode ser uma única pessoa postando três vezes. Se o seu caso conta recorrência como sinal, guarde o autor desde a coleta.
Por fim, o dado que falta para tudo isso: sem rótulos humanos, você sabe que os grupos parecem coerentes, mas não sabe a precisão. Antes de usar um agrupamento assim para decidir algo caro, separe uma amostra de pares fundidos e separados e faça uma pessoa julgar.
Quando o conjunto estabiliza, o problema muda. Em vez de descobrir grupos, você passa a encaixar textos novos num catálogo existente, e uma classificação hierárquica com uma opção "outro" em cada nó tende a servir melhor. Para descobrir categorias que você ainda não conhece, o guloso com juiz na zona cinzenta é o ponto de partida. Se você quer praticar esse tipo de decisão entre código e modelo em sistemas reais, a Formação em Inteligência Artificial trabalha esses padrões.
Referências
- FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance (Chen, Zaharia e Zou, 2023)
- ClusterLLM: Large Language Models as a Guide for Text Clustering (Zhang, Wang e Shang, EMNLP 2023)
- Vector embeddings, guia da OpenAI sobre embeddings,
text-embedding-3-smalle similaridade por cosseno
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial22 nov 2026 7 min
Git worktree para agentes em paralelo, sem colisão
Como usar git worktree para rodar agentes de código em paralelo sem colisão: comandos reais, best-of-N e as pegadinhas de porta, node_modules, .env e banco.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.

