Git worktree para agentes em paralelo, sem colisão
Dois agentes de código no mesmo diretório vão, mais cedo ou mais tarde, escrever no mesmo arquivo. O git worktree evita essa colisão dando a cada agente uma pasta e uma branch próprias, sem clonar o repositório de novo. Ele resolve só uma parte do problema: porta, dependências, .env e banco continuam compartilhados, e é neles que as execuções em paralelo costumam quebrar.
O que é um git worktree e como criar um?
Segundo a documentação do git, um repositório pode ter vários working trees, o que permite manter mais de uma branch com checkout ao mesmo tempo. Todos compartilham o histórico, e cada um tem o seu HEAD, o seu índice e os seus arquivos. No worktree secundário, o .git é um arquivo de uma linha que aponta para uma pasta dentro do .git do repositório principal. Como explica o Augusto Galego, é como ter dois clones do repositório sem o segundo clone, e sem o stash ou o commit pela metade que a troca de branch exige.
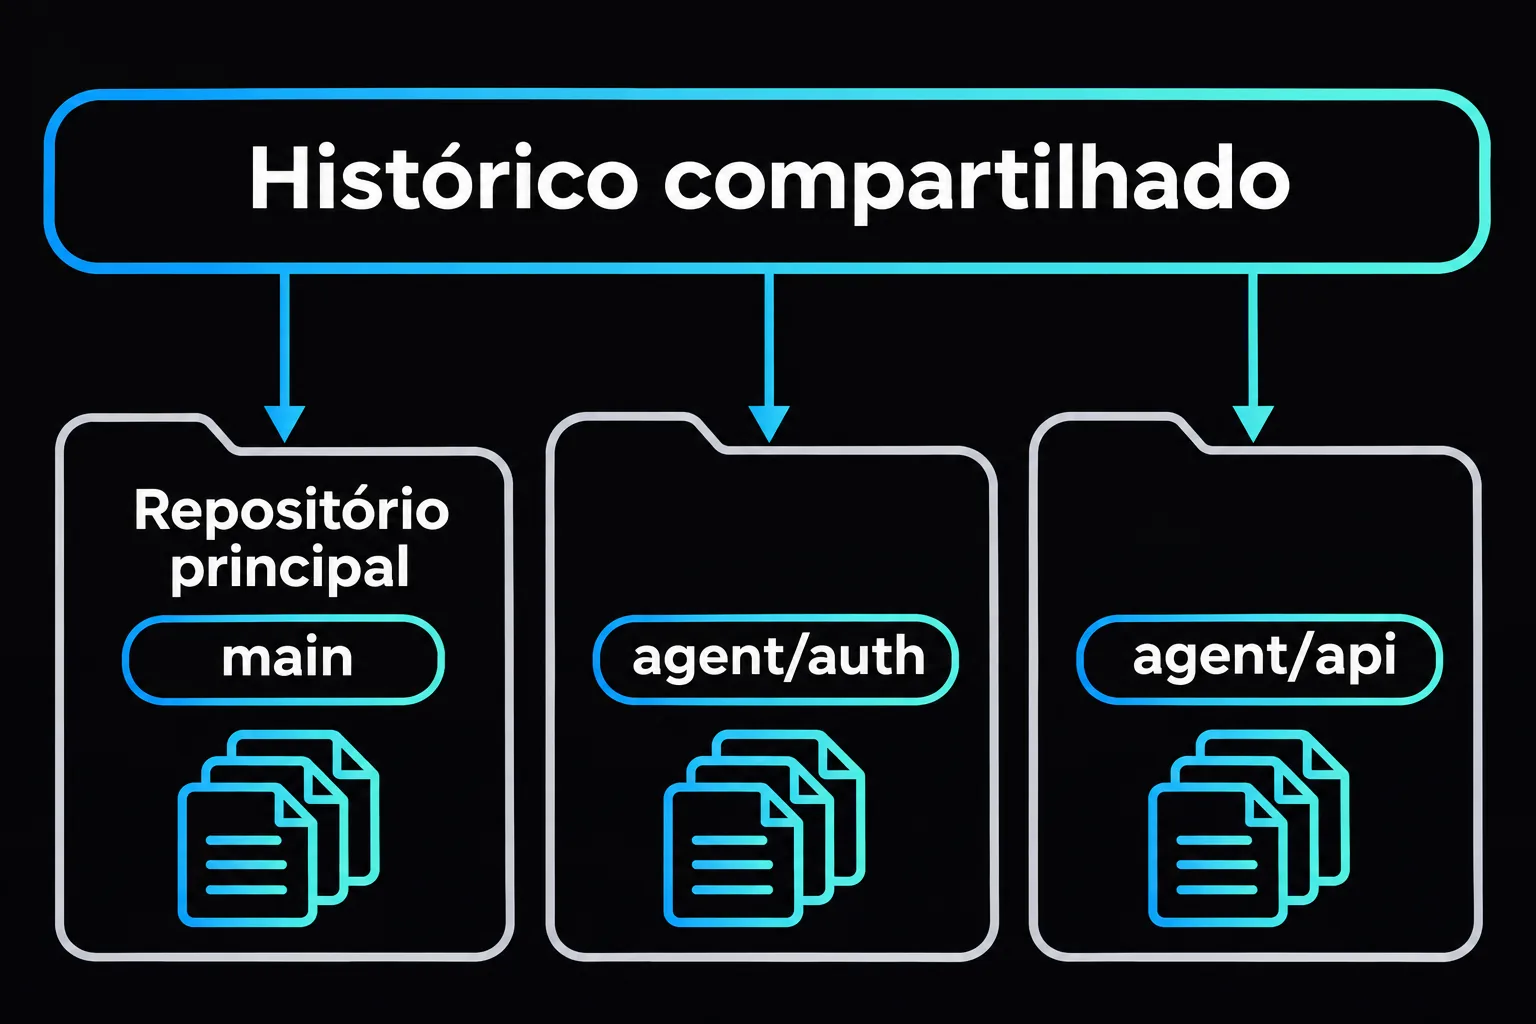
git worktree add -b agent/auth ../app-auth
git worktree add -b agent/api ../app-api
git worktree list
/home/dev/app       f6c2e9a [main]
/home/dev/app-api   f6c2e9a [agent/api]
/home/dev/app-auth  f6c2e9a [agent/auth]
A sintaxe é git worktree add -b <nova-branch> <caminho> [<commit>]. Sem o commit, a branch nasce do HEAD atual. O caminho fica fora do repositório (../app-auth) para a pasta não aparecer como conteúdo não rastreado.
O git também impede que duas pastas usem a mesma branch. Na versão 2.56, git worktree add ../outra agent/auth termina em fatal: 'agent/auth' is already used by worktree at .... Para um orquestrador, isso é uma trava de graça: dois workers não conseguem pegar a mesma branch por engano.
Para limpar, o ciclo é este:
git worktree remove ../app-auth      # recusa se houver arquivo modificado ou não rastreado
git worktree remove --force ../app-auth
git worktree prune                   # esquece worktrees cuja pasta foi apagada na mão
git worktree add --detach ../app-teste HEAD   # experimento descartável, sem branch
Arquivos ignorados pelo .gitignore, como node_modules, não impedem o remove. Se alguém apagar a pasta com rm -rf, o git worktree list marca a entrada como prunable até o prune rodar. A branch continua existindo depois do remove, e apagá-la é um passo separado (git branch -d).
Como o orquestrador entrega um worktree para cada worker?
No padrão orchestrator-workers da Anthropic, descrito em Workflow ou agente? Os cinco padrões da Anthropic, um orquestrador divide a tarefa, delega para workers e junta os resultados. Quando os workers escrevem código, o worktree torna essa delegação segura: o orquestrador cria agent/<tarefa> a partir da main, aponta o worker para a pasta e é o único que integra. A analogia com container ajuda até certo ponto, porque o worktree isola só os arquivos rastreados de cada agente.
As ferramentas de agente já embalam esse fluxo, e os nomes abaixo são exemplos datados. Em vídeos de fevereiro de 2026, Matt Pocock e o canal Better Stack mostraram o flag claude --worktree <nome> do Claude Code. O Better Stack e o texto Loop Engineering, de Addy Osmani, citam também o campo isolation: worktree no frontmatter de um subagente, que dá a cada ajudante um checkout próprio. Flags mudam entre versões, então confira na sua.
No teste, Matt Pocock notou que, sem um nome de branch explícito no push, o agente enviaria o trabalho para a branch de onde o worktree saiu, no caso a main. Em git puro dá para reproduzir esse efeito. Uma branch criada a partir de origin/main passa a acompanhar origin/main. Num repositório de teste com git 2.56 e push.default=upstream, um git push dentro de agent/api enviou os commits para a main remota. Com o padrão simple, o git recusa o push, porque o nome da branch local não bate com o da remota. O remédio tem duas partes:
git worktree add --no-track -b agent/api ../app-api origin/main
# no fim do trabalho do worker:
git push -u origin HEAD
O --no-track impede o vínculo com a main, e o push -u origin HEAD cria no remoto uma branch com o nome da local. Proteger a main no remoto fecha o resto da porta.
Porta, node_modules, .env e banco: o que o worktree não isola?
O git só faz checkout de arquivos rastreados. Tudo o que o .gitignore esconde (node_modules, .env, bancos locais) não aparece no worktree novo. E o que é da máquina, como as portas e o servidor de banco, nunca esteve no repositório.
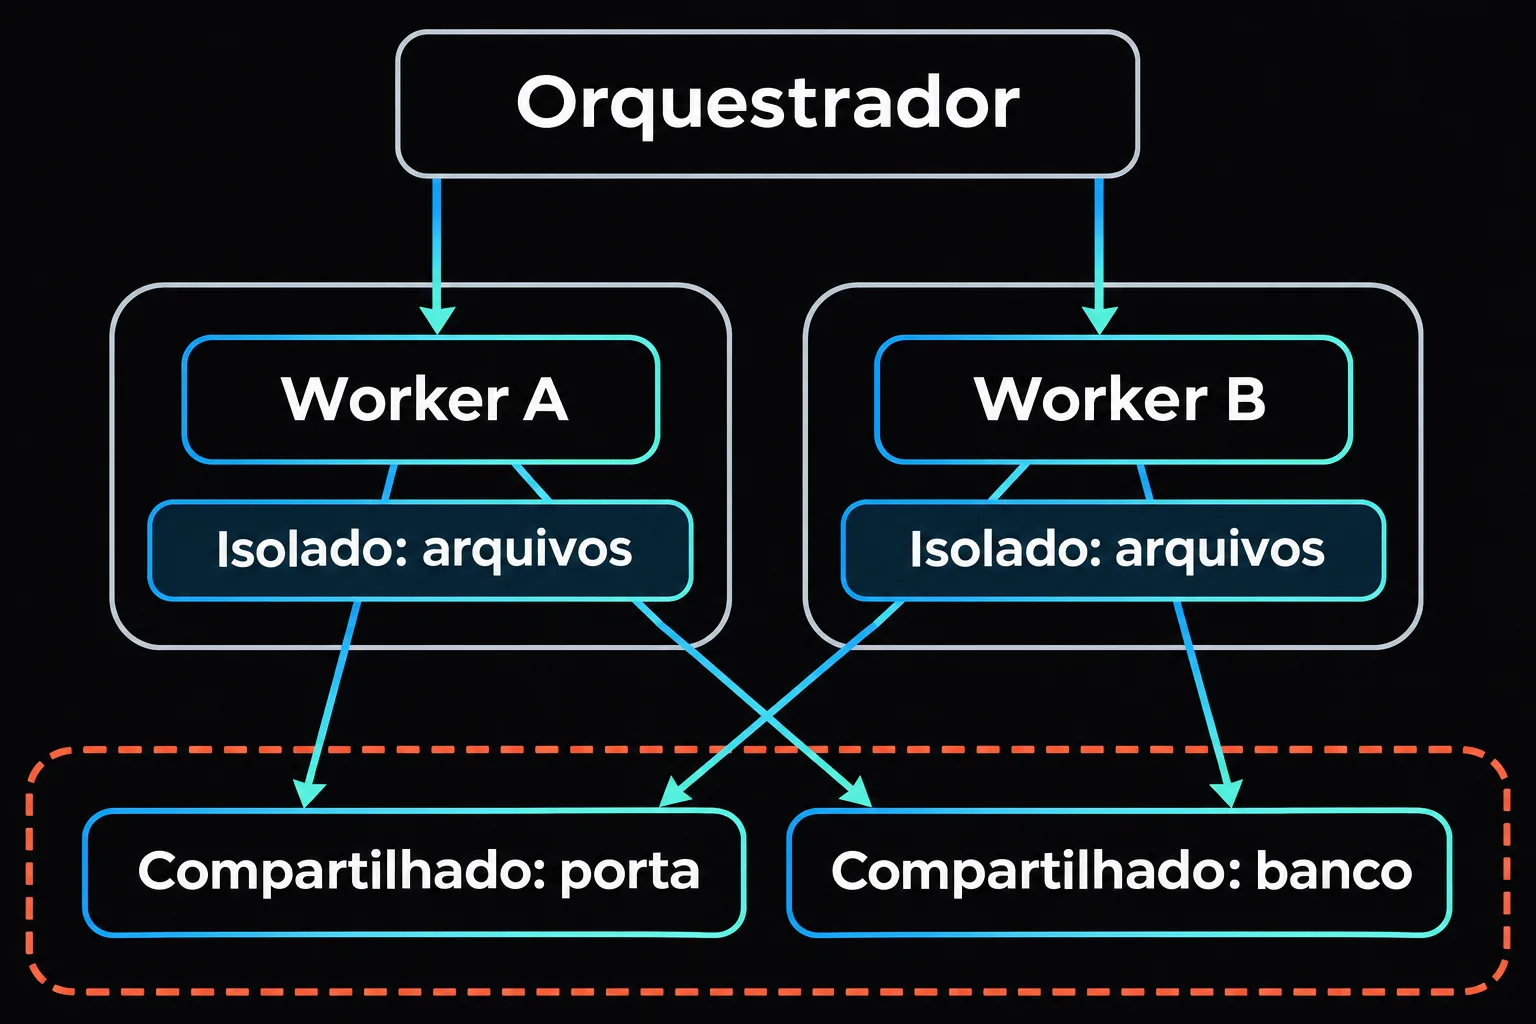
| Recurso | Dentro do worktree | O que fazer |
|---|---|---|
| Arquivos rastreados | isolado | nada |
node_modules | ausente | instalar na criação |
.env | ausente | copiar e sobrescrever porta e banco |
| Porta | compartilhada | uma por worktree |
| Banco de dados | compartilhado | um por worktree |
As fontes convergem nesses pontos. Indy Dev Dan, em maio de 2025, descreve um prompt de setup que cria o worktree, copia o .env, instala as dependências e muda a porta no config do Vite. Cole Medin, em abril de 2026, lista conflito de porta e instalação de dependências entre os problemas de rodar agentes com validação de ponta a ponta em paralelo, e trata o banco à parte. Ele instala os node_modules antes de o agente começar e deriva a porta do nome do worktree a partir de uma base 4000.
A função abaixo junta essas peças. Um orquestrador a chamaria uma vez por tarefa:
import { execFileSync } from "node:child_process";
import { createHash } from "node:crypto";
import { existsSync, readFileSync, writeFileSync } from "node:fs";
import { basename, resolve } from "node:path";

function portFor(task: string, taken: Set<number>, base = 4000, range = 1000): number {
  const hash = createHash("sha1").update(task).digest().readUInt16BE(0);
  for (let i = 0; i < range; i++) {
    const port = base + ((hash + i) % range);
    if (!taken.has(port)) return port;
  }
  throw new Error("nenhuma porta livre no intervalo");
}

export function createWorkspace(repo: string, task: string, taken: Set<number>) {
  const run = (cwd: string, cmd: string, ...args: string[]) =>
    execFileSync(cmd, args, { cwd, stdio: "inherit" });
  const branch = `agent/${task}`;
  const path = resolve(repo, "..", `${basename(repo)}-${task}`);
  const database = `app_${task.replace(/\W/g, "_")}`;

  run(repo, "git", "fetch", "origin", "main");
  run(repo, "git", "worktree", "add", "--no-track", "-b", branch, path, "origin/main");

  const envFile = resolve(repo, ".env");
  const lines = existsSync(envFile) ? readFileSync(envFile, "utf8").split("\n") : [];
  const env = lines.filter(l => l !== "" && !/^(PORT|DATABASE_URL)=/.test(l));
  const port = portFor(task, taken);
  taken.add(port);
  env.push(`PORT=${port}`, `DATABASE_URL=postgres://localhost/${database}`);
  writeFileSync(resolve(path, ".env"), env.join("\n") + "\n");

  run(path, "npm", "install");
  return { path, branch, port, database };
}
A porta vem de um hash do nome da tarefa, e o conjunto taken, mantido pelo orquestrador, resolve a colisão de dois nomes com o mesmo hash. Como o worktree nasce sem .env, a função copia o do repositório principal sem PORT e DATABASE_URL, que são reescritas. Sem esse filtro, todos os agentes herdam a DATABASE_URL do desenvolvimento e escrevem no mesmo banco.
O banco é o ponto mais caro de descobrir tarde. Cole Medin observa que, se implementações diferentes mexem no banco, elas quebram umas às outras quando apontam para o mesmo, e propõe algo como um worktree para o banco: branching de banco, num serviço que ofereça isso, ou um SQLite local por worktree. Em PostgreSQL puro, dá para clonar um banco usando-o como template:
CREATE DATABASE app_agent_auth TEMPLATE app_molde;
-- ao remover o worktree:
DROP DATABASE app_agent_auth;
A documentação do PostgreSQL avisa que nenhuma outra sessão pode estar conectada ao banco de origem durante a cópia, e que o CREATE DATABASE falha se houver alguma conexão quando ele começa. Por isso o template é um banco molde que nenhuma aplicação usa, e não o banco de desenvolvimento em que o seu servidor está conectado. Mesmo com um banco por worktree, duas migrations criadas por agentes diferentes só se encontram na hora do merge.
Esses comandos de setup o agente não adivinha. O lugar deles é o README do projeto, como mostra o post sobre README e rules para LLM.
Como o best-of-N usa o mesmo mecanismo?
Até aqui cada worktree recebe uma tarefa diferente. No best-of-N, todos recebem a mesma. Indy Dev Dan argumenta que, como os LLMs são não determinísticos, rodar vários agentes sobre o mesmo plano gera versões diferentes do código e permite escolher a melhor, e avisa que a técnica não é barata. Em código, o uso típico é gerar N implementações, rodar a suíte de testes e ficar com a que passa.
for i in 1 2 3; do
  git worktree add --no-track -b try/ui-$i ../app-ui-$i origin/main
done

# o mesmo plano roda em cada pasta; depois a mesma suíte de testes avalia as três
git merge --no-ff try/ui-2
git worktree remove ../app-ui-2 && git branch -d try/ui-2
for i in 1 3; do
  git worktree remove --force ../app-ui-$i
  git branch -D try/ui-$i
done
O critério de escolha precisa ser verificável: com testes, a seleção é mecânica; com "qual parece melhor", o gargalo volta para você. Cole Medin acrescenta que quem revisa não deve ser a mesma sessão que escreveu, nem enxergar a conversa dela, porque quem acabou de fazer o trabalho tende a aprovar o próprio resultado. Um revisor em contexto limpo pega o que o autor deixou passar.
Quantos agentes em paralelo você consegue revisar?
O limite está fora da ferramenta. Addy Osmani escreve, em Loop Engineering, que o worktree remove a colisão mecânica, mas a banda de revisão de quem lê e aprova decide quantos agentes dá para rodar.
O paralelismo não compensa em alguns casos:
- As tarefas mexem nos mesmos arquivos. O worktree só adia o conflito para o merge.
- Uma tarefa depende do resultado da outra, o que pede execução em sequência.
- O projeto não tem testes, e cada candidato exige revisão manual completa.
- O custo de tokens já pesa. Cole Medin sugere modelos menores em etapas que pedem pouco raciocínio, como análise de código e pesquisa.
Se você passa muito tempo corrigindo o que os agentes entregam, Cole Medin trata isso como sinal para acrescentar validação automática. É o mesmo princípio de outras partes do ciclo de agentes, como a avaliação por tarefa, trial e grader: o que sustenta a escala é uma checagem que não depende da sua atenção.
Quem quiser aprofundar esse tipo de orquestração e de avaliação de agentes encontra o tema na Formação em Inteligência Artificial.
Referências
- Git. git-worktree documentation.
- PostgreSQL. Template Databases.
- Addy Osmani. Loop Engineering.
- Anthropic. Building effective agents.
- Matt Pocock. I'm using claude --worktree for everything now (YouTube, fev. 2026).
- Cole Medin. Parallel Claude Code + Git Worktrees: this setup will change how you ship (YouTube, abr. 2026).
- IndyDevDan. Claude 4 ADVANCED AI Coding: How I PARALLELIZE Claude Code with Git Worktrees (YouTube, maio 2025).
- Better Stack. Native Worktrees Just Killed Traditional Claude Code Workflows (YouTube, fev. 2026).
- Augusto Galego. Você não pode se dar ao luxo de ignorar Git-Worktree (YouTube, abr. 2026).
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.
- Inteligência Artificial20 nov 2026 7 min
Clustering de texto: embedding e LLM na zona cinzenta
Clustering de texto com embedding e cosseno, mandando só os pares ambíguos a um classificador LLM, e por que o centróide cria grupos gigantes.

