Avaliação de LLM: juiz ou teste? Escolha o grader
Quem escolhe entre LLM-as-judge e teste determinístico na avaliação de LLM está decidindo, antes de tudo, qual tipo de erro a avaliação pode tolerar. Um teste em código que rejeita uma resposta válida gera ruído no seu CI. Um juiz que aprova uma resposta errada deixa um bug passar com cara de nota boa.
O post de engenharia da Anthropic, "Demystifying evals for AI agents", organiza os graders em três famílias: baseados em código, baseados em modelo e humanos. A recomendação que ele dá para o desenho é direta: graders determinísticos onde for possível, graders de LLM onde for necessário ou para ganhar flexibilidade, e humanos com parcimônia, para validação. Este post mostra o que cada família faz bem, como combiná-las num score só e como saber se o seu juiz merece confiança.
O que cada família de grader entrega?
A tabela da Anthropic resume os pontos fortes e fracos de cada uma.
Os graders por código incluem comparação de string (exata, regex, fuzzy), testes binários (fail-to-pass, pass-to-pass), análise estática, verificação de outcome e verificação de chamadas de ferramenta. Segundo o texto, são rápidos, baratos, objetivos, reproduzíveis e fáceis de depurar. O custo: são frágeis a variações válidas que não batem exatamente com o padrão esperado, e têm pouca nuance para tarefas subjetivas.
Os graders por modelo incluem rubricas, asserções em linguagem natural, comparação em pares, avaliação com referência e consenso entre vários juízes. São flexíveis, escalam, capturam nuance e lidam com saída livre. Em compensação, são não determinísticos, mais caros que código e exigem calibração com avaliadores humanos para ter acurácia.
Os graders humanos incluem revisão por especialista, julgamento de multidão, amostragem para checagem pontual, testes A/B e concordância entre anotadores. A Anthropic os chama de padrão ouro e os usa para calibrar os graders de modelo. São caros, lentos e muitas vezes exigem acesso a especialistas em escala.
Para combinar os resultados de uma task, o texto lista três formas: ponderada (a soma das notas precisa passar um limiar), binária (todos os graders precisam passar) ou híbrida.
Quando o teste determinístico basta?
Sempre que a correção puder ser verificada por uma condição objetiva no estado do mundo. Um agente de suporte que deveria reembolsar o pedido 1042 em R$ 80 tem um outcome checável: existe um registro de reembolso com esse valor? Isso não depende de interpretação.
A fragilidade aparece quando você verifica a forma em vez do fato. A própria Anthropic conta o caso do CORE-Bench: o Opus 4.5 pontuou 42% até um pesquisador da Anthropic achar problemas como uma avaliação rígida que penalizava "96.12" quando o esperado era "96.124991…", além de especificações ambíguas e tarefas estocásticas. Depois de corrigir os bugs e usar um scaffold menos restritivo, o score foi para 95%. O modelo era o mesmo. Parte da diferença vinha de um grader por código que reprovava respostas válidas, e parte de tarefas e de um scaffold mal configurados.
O mesmo vale para verificar a trilha. O texto avisa que checar uma sequência específica de chamadas de ferramenta costuma ser rígido demais, porque agentes encontram caminhos válidos que quem escreveu o eval não previu. A sugestão é avaliar o que o agente produziu, e não o caminho que ele seguiu.
Quando o juiz de LLM se justifica?
Quando a qualidade é semântica, subjetiva ou depende de contexto. A documentação do DeepEval dá exemplos: a resposta atendeu o pedido do usuário, está fundamentada no contexto recuperado, o tom é adequado, o agente completou a tarefa. Um texto fluente pode alucinar, e um agente pode chamar todas as ferramentas com sucesso e mesmo assim falhar na tarefa do usuário. Comparação exata de string costuma deixar essas falhas passar.
O DeepEval separa três técnicas, que servem como mapa de quanto controle você quer sobre o juiz:
- G-Eval: critérios em linguagem natural, o jeito mais rápido de criar um juiz customizado. O guia sugere começar com
criteriae migrar paraevaluation_stepsexplícitos quando a métrica passa a valer para CI ou monitoramento em produção, porque os passos deixam a avaliação mais estável. - DAG: o critério vira uma árvore de decisão, em que cada nó faz um julgamento menor. Serve para portões duros, como "o JSON precisa ser válido antes de avaliar a qualidade", e deixa o caminho da decisão inspecionável.
- Métricas no estilo QAG: decompõem um julgamento amplo em perguntas fechadas e calculam a nota a partir das respostas. As métricas prontas de RAG e de agentes usam essa abordagem.
O DAG traz determinismo para dentro do juiz. Quanto mais o critério puder virar perguntas fechadas e portões, mais estável fica o grader.
Como combinar os graders num score?
A pergunta que decide o formato é se uma falha é eliminatória ou se ela só reduz a qualidade.
O promptfoo implementa duas das três formas da Anthropic. Por padrão, cada asserção tem weight 1, e a nota do caso de teste é a média ponderada das notas. A documentação dá o exemplo de duas asserções: equals com peso 2 e contains com peso 1. Se a saída for "Goodbye world", só contains passa, e a nota final é 0,33. Um threshold no caso de teste define a nota mínima para aprovar. Já um assert-set passa quando todas as asserções do grupo passam, ou quando uma fração delas, definida em threshold, passa.
Para o nosso agente de reembolso, a configuração poderia ser esta:
tests:
  - vars:
      pedido: "1042"
    threshold: 0.7
    assert:
      - type: contains
        value: "1042"
        weight: 2
      - type: llm-rubric
        value: "A resposta é educada e explica o prazo do estorno sem prometer valores que o texto não confirma"
        weight: 1
Com peso 2 e threshold 0,7, uma resposta que não menciona o pedido cai para 0,33 e reprova. Essa proteção vem só da aritmética: acrescente mais quatro rubricas de peso 1 e a mesma resposta soma 5 de 7, cerca de 0,71, e passa, com as notas de tom compensando o fato que faltou. Há ainda um segundo problema: contains confere o texto, e não se o reembolso existe. Se o fato é eliminatório, ele deve entrar como portão, e não como peso. O código abaixo é um desenho híbrido: portões determinísticos reprovam sozinhos, e o juiz entra como nota ponderada, com um terceiro estado para quando ele não consegue decidir.
type Run = { reply: string; refunds: { orderId: string; amount: number }[] };
type Result = { name: string; score: number | null }; // null = o juiz devolveu "unknown"
type Verdict = "pass" | "fail" | "unknown";
type Judge = (rubric: string, reply: string) => Promise<Verdict>;

const refundIssued =
  (orderId: string, amount: number) =>
  (run: Run): Result => ({
    name: "refund-issued",
    score: run.refunds.some(r => r.orderId === orderId && r.amount === amount) ? 1 : 0,
  });

const rubric =
  (judge: Judge, name: string, text: string) =>
  async (run: Run): Promise<Result> => {
    const verdict = await judge(text, run.reply);
    return { name, score: verdict === "unknown" ? null : verdict === "pass" ? 1 : 0 };
  };

type Weighted = { result: Result; weight: number };
type Outcome = "pass" | "fail" | "review";

function combine(gates: Result[], weighted: Weighted[], threshold: number): Outcome {
  if (gates.some(g => g.score !== 1)) return "fail"; // portão: reprova sozinho
  if (weighted.some(w => w.result.score === null)) return "review"; // juiz não decidiu
  const total = weighted.reduce((sum, w) => sum + w.weight, 0);
  const got = weighted.reduce((sum, w) => sum + w.weight * (w.result.score ?? 0), 0);
  return got / total >= threshold ? "pass" : "fail";
}
Dois detalhes seguem recomendações da Anthropic. O primeiro é dar ao juiz uma saída, como devolver "Unknown" quando não tem informação suficiente, para reduzir alucinação. Aqui isso vira o estado review, que manda o caso para um humano em vez de forçar uma nota. O segundo é usar rubricas estruturadas por dimensão e avaliar cada dimensão com um juiz isolado, em vez de um único juiz para tudo. Por isso rubric recebe um critério e devolve uma nota, e você chama uma vez por dimensão.
A Anthropic também recomenda crédito parcial em tarefas com várias etapas. Um agente que identifica o problema e verifica o cliente, mas não processa o reembolso, é melhor que um que falha de cara. O score ponderado representa essa gradação, enquanto o binário puro a esconde. Use binário quando o ponto é um gate de regressão, e ponderado quando você quer enxergar progresso numa suíte de capacidade. Para a diferença entre esses dois tipos de suíte, veja como avaliar um agente de IA.
Como saber se o juiz merece confiança?
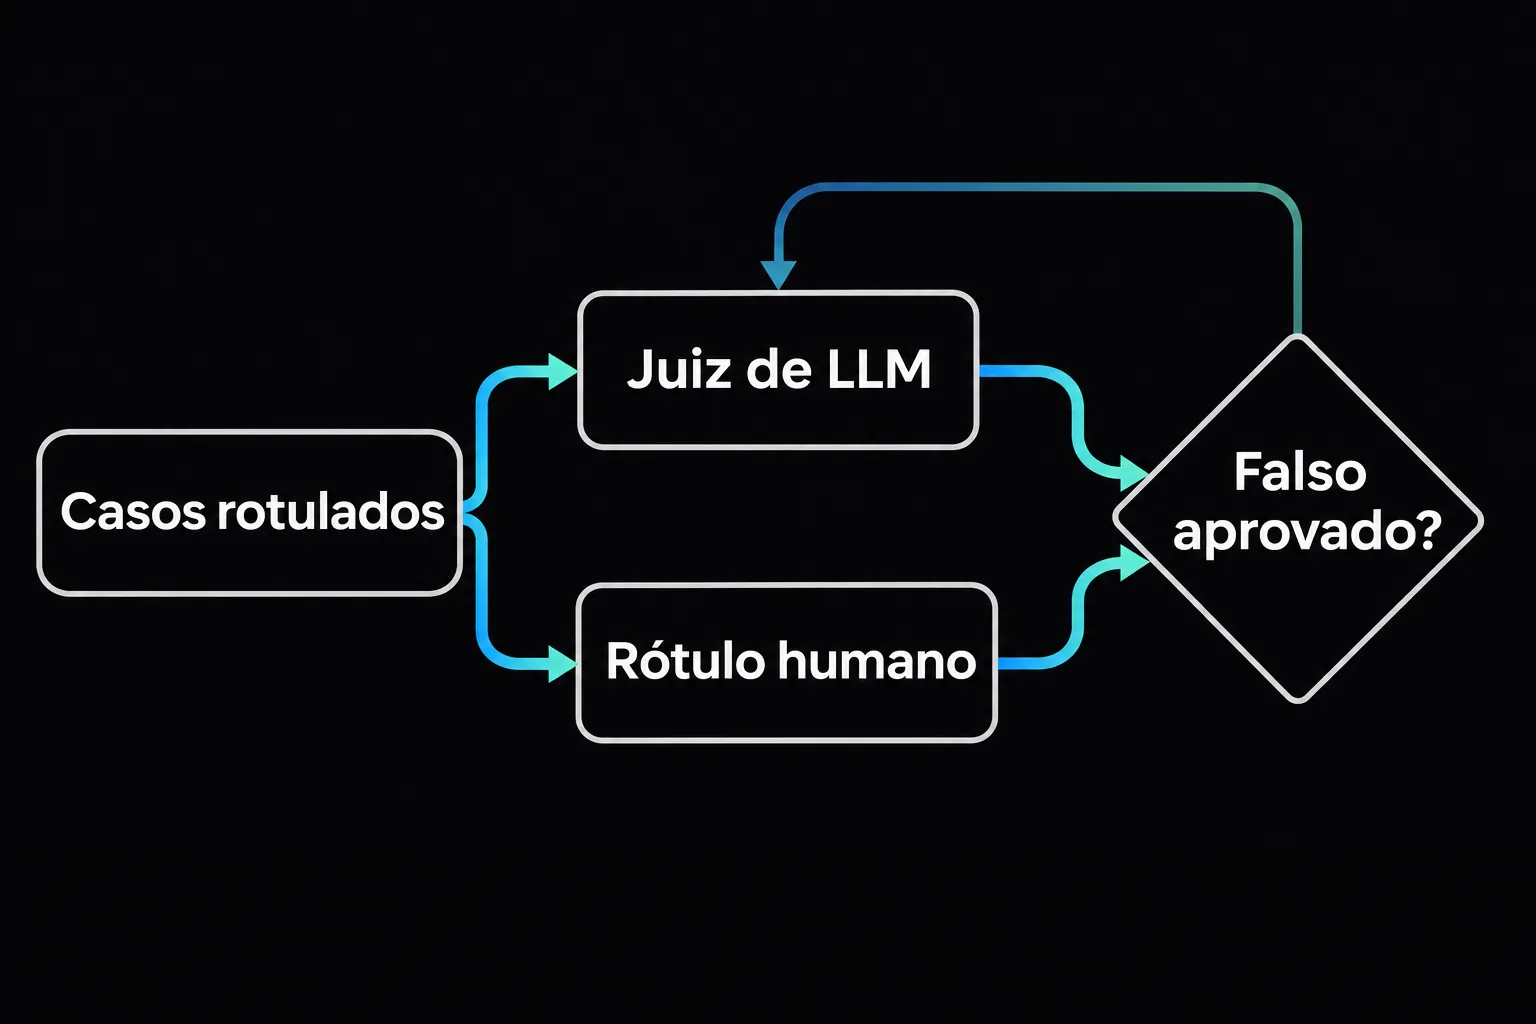
Tratando o juiz como um instrumento de medida com erro próprio, e medindo esse erro contra rótulos humanos. A Anthropic diz que juízes de LLM precisam ser calibrados com especialistas para que haja pouca divergência entre a nota humana e a do modelo. A ideia mínima é separar um conjunto de casos rotulados por uma pessoa e comparar:
type Labeled = { human: "pass" | "fail"; judge: Verdict };

function calibrate(rows: Labeled[]) {
  const decided = rows.filter(r => r.judge !== "unknown");
  const agree = decided.filter(r => r.judge === r.human).length;
  const falsePass = decided.filter(r => r.judge === "pass" && r.human === "fail").length;
  return {
    coverage: rows.length ? decided.length / rows.length : 0,
    agreement: decided.length ? agree / decided.length : 0,
    falsePass, // aprovou o que o humano reprovou
    humanFails: rows.filter(r => r.human === "fail").length,
  };
}
Concordância média alta pode esconder o erro que mais importa. Se quase todos os casos são bons, um juiz que aprova tudo concorda quase sempre com o humano. Por isso o código separa falsePass e humanFails: o que interessa é quantos defeitos reais o juiz deixou passar. A cobertura mostra quantos casos ele decidiu, porque um juiz que manda quase tudo para revisão pode ter boa precisão e ser inútil.
O tamanho da amostra também limita o que você pode afirmar: zero falsos aprovados em 20 casos ainda é compatível com uma taxa de erro real de até cerca de 13,9%, com 95% de confiança.
O juiz também tem vieses conhecidos, como a sensibilidade à ordem das respostas e ao tamanho do texto, que pedem testes próprios.
Avaliação de LLM: qual grader usar em cada caso?
Uma regra de bolso que decorre do que vimos:
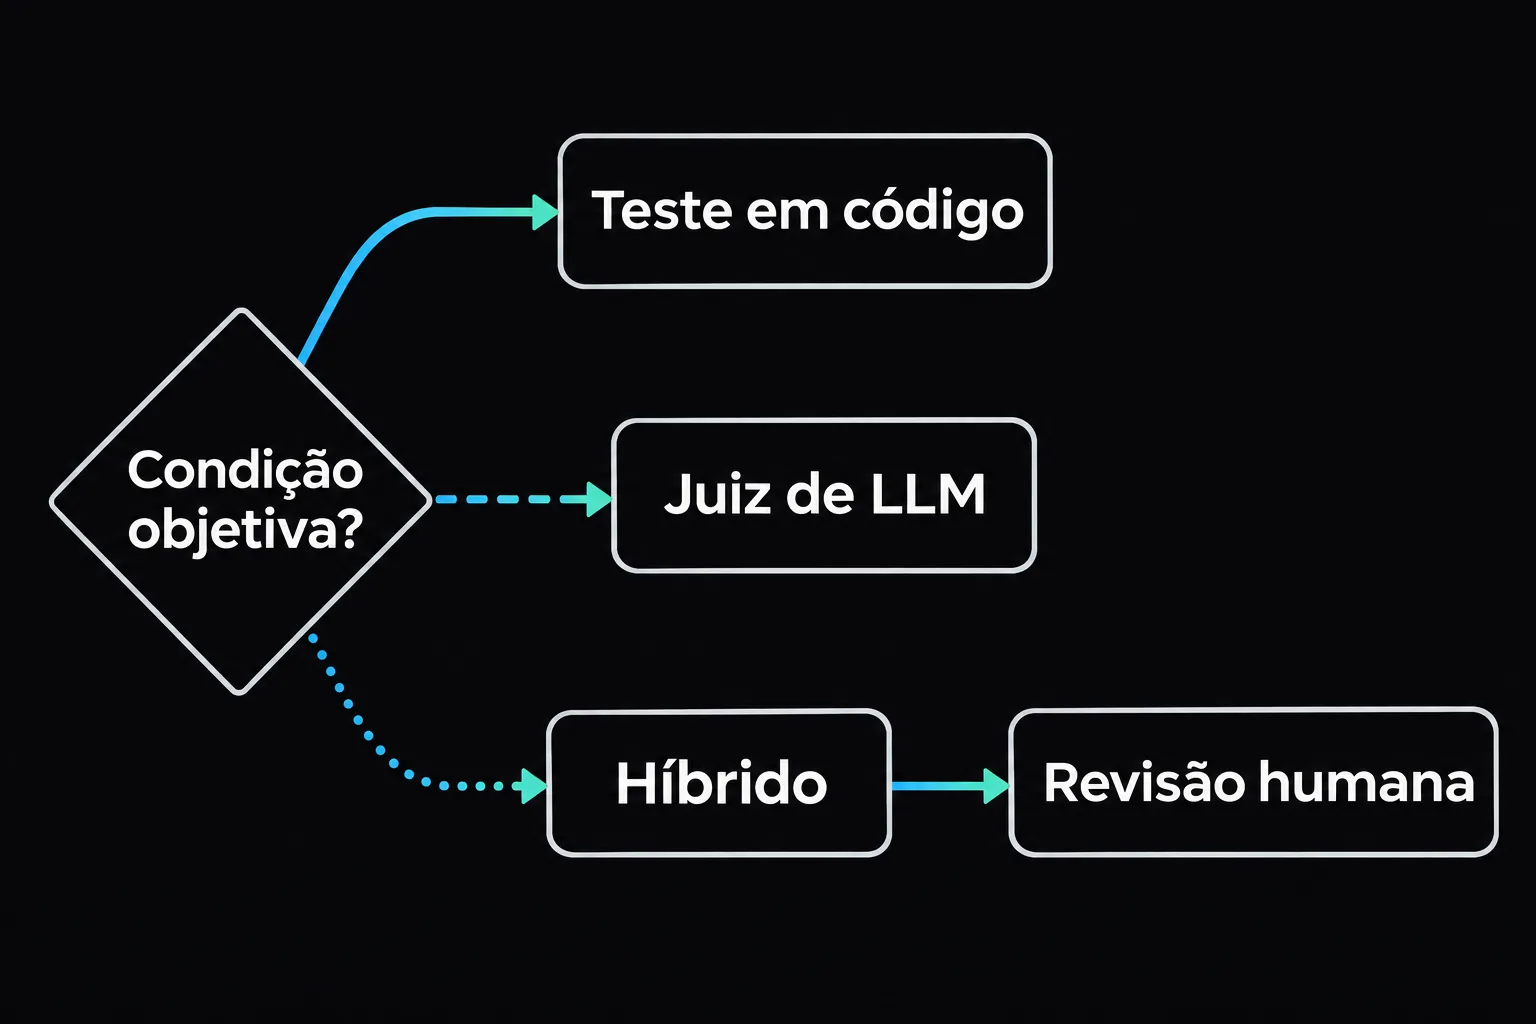
- Existe uma condição objetiva no estado final? Use código, como portão. Verifique o outcome, não o texto exato nem a sequência de ferramentas.
- A qualidade depende de interpretação (tom, completude, fundamentação)? Use juiz de LLM, com rubrica estruturada, uma dimensão por juiz e saída "unknown".
- O critério mistura as duas coisas? Use híbrido: portões determinísticos primeiro, juiz depois, humano para os casos
reviewe para a calibração. - O erro do juiz é caro? Meça
falsePasscontra rótulos humanos antes de confiar, e releia transcripts com frequência. A Anthropic observa que, depois que o sistema está estável, a revisão humana pode ser ocasional, mas é a leitura dos transcripts que mostra se o grader rejeitou uma solução válida.
Juntando tudo, o desenho híbrido divide o trabalho: o código decide o que é verificável, o juiz cobre o que depende de leitura e a revisão humana mede quanto o juiz erra. Se você quer praticar esse desenho com projetos completos, ele faz parte da Formação em Inteligência Artificial.
Referências
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial16 nov 2026 8 min
Context rot: por que mais contexto piora o agente
Context rot: a precisão do LLM cai quando a entrada cresce, mesmo em tarefas simples. Veja como isso foi medido, o que explica o efeito e como curar o contexto.
- Inteligência Artificial15 nov 2026 7 min
README para LLM: o que escrever para o agente
README para LLM e rules: o que escrever para o agente de IA parar de adivinhar comando de teste, porta e padrão de código, sem inflar o custo de tokens.
- Inteligência Artificial14 nov 2026 8 min
Prompt injection indireto em agentes e as defesas
Prompt injection indireto acontece quando o agente lê um texto com instruções do atacante. Veja o ataque, o que os benchmarks mediram e as defesas em camadas.

