Context rot: por que mais contexto piora o agente
Context rot é a queda de precisão de um modelo de linguagem à medida que a entrada cresce, mesmo quando a tarefa continua igual. Um modelo que aceita 1 milhão de tokens e acerta uma pergunta com 1 mil tokens pode errar a mesma pergunta quando ela vem cercada de 100 mil, e o agente que você construiu em cima dele herda esse comportamento.
Este post trata do mecanismo: como o efeito foi medido, o que se sabe (e o que ainda é hipótese) sobre a causa, quais tipos de token pioram mais o resultado e o que fazer no código. O que ocupa a janela de um agente de código está em O que ocupa a janela de contexto de um agente, e como organizar o que entra em cada passo está em Context engineering na prática. Aqui o assunto é por que o excesso dói.
Se o modelo passa no teste de contexto longo, qual é o problema?
O teste mais usado para vender janelas enormes é o needle in a haystack: esconde-se uma frase (a agulha) em um texto longo e irrelevante (o palheiro) e pergunta-se por ela. Os modelos atuais costumam ir muito bem nele. O relatório de context rot da Chroma, de julho de 2025, lembra o que esse teste mede de fato: uma busca lexical, em que a pergunta e a agulha compartilham as mesmas palavras.
Tarefas reais raramente funcionam assim. Em um agente, a pergunta e o trecho útil quase nunca usam o mesmo vocabulário: você pede "por que o checkout falha para clientes de Florianópolis" e a pista está numa linha de log sobre um timeout de CEP. O benchmark NoLiMa, de Modarressi e colegas, foi desenhado para isso: pergunta e agulha quase não têm palavras em comum, então o modelo precisa inferir a associação. Segundo os autores, com 13 modelos que declaram suportar pelo menos 128 mil tokens, o desempenho é bom abaixo de 1 mil tokens e cai bastante depois. Aos 32 mil tokens, 11 dos 13 ficaram abaixo de 50% do próprio resultado em contexto curto. O GPT-4o, uma das exceções, foi de 99,3% para 69,7%.
O número de 32 mil é bem menor que o limite técnico desses modelos. O estudo Same Task, More Tokens, de Levy, Jacoby e Goldberg, chega a uma conclusão parecida em tarefas de raciocínio: a degradação aparece em comprimentos muito menores que o máximo suportado. Com entradas de cerca de 3 mil tokens, a acurácia média dos modelos que eles testaram caiu de 0,92 para 0,68.
Como se mede o efeito sem confundir com tarefa mais difícil?
Quando o contexto cresce, a tarefa costuma ficar mais difícil junto (mais código para navegar, mais documentos para cruzar), e aí não dá para saber se o culpado foi o tamanho ou a dificuldade.
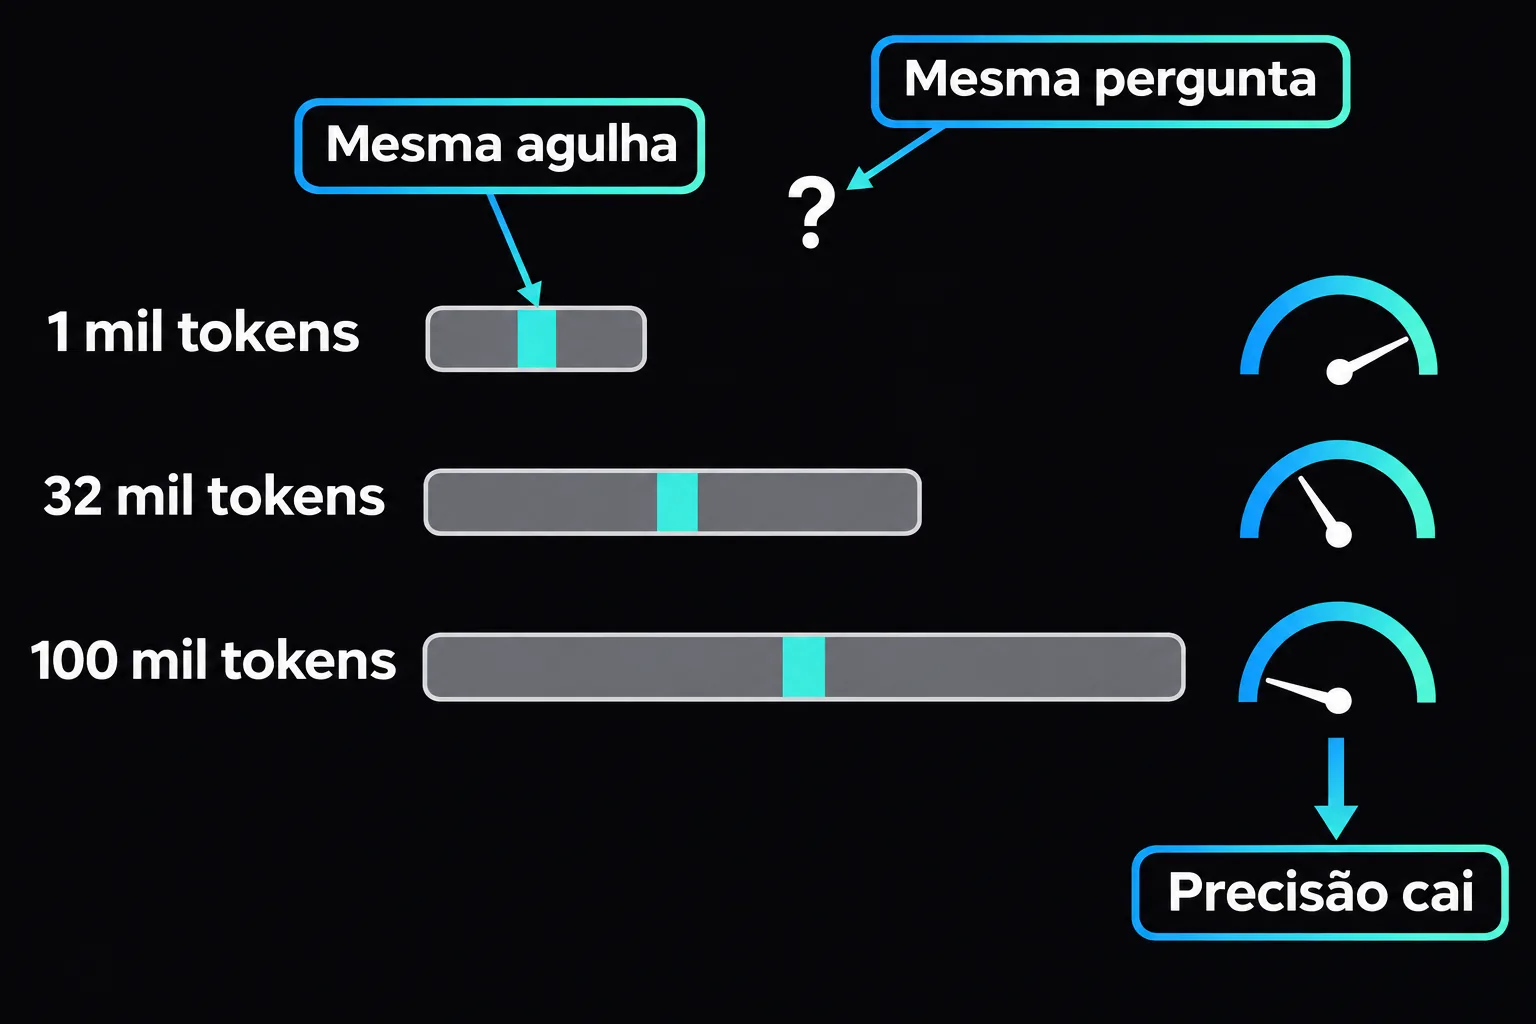
O relatório da Chroma controla isso. Eles mantêm a pergunta e a agulha fixas e variam só a quantidade de texto ao redor, em 18 modelos, incluindo GPT-4.1, Claude 4, Gemini 2.5 e Qwen3. A conclusão dos autores é que o desempenho cai de forma consistente com o comprimento da entrada, em todos os experimentos, e que a queda é mais rápida quando a pergunta e a agulha se parecem menos.
O mesmo desenho está ao seu alcance: a mesma pergunta, com o mesmo trecho útil no meio, cercada de quantidades crescentes de texto sem relação.
type Ask = (prompt: string) => Promise<string>;

type Case = {
  question: string;
  needle: string; // trecho que contém a resposta
  expected: string;
};

// Mesma pergunta, mesma resposta, só muda a quantidade de texto irrelevante.
async function accuracyByLength(
  ask: Ask,
  cases: Case[],
  filler: string[], // parágrafos sem relação com a pergunta
  lengths: number[] // quantidade de parágrafos de enchimento
): Promise<Record<number, number>> {
  const result: Record<number, number> = {};
  for (const n of lengths) {
    let hits = 0;
    for (const c of cases) {
      const padding = filler.slice(0, n);
      const middle = Math.floor(padding.length / 2);
      const context = [...padding.slice(0, middle), c.needle, ...padding.slice(middle)];
      const answer = await ask(`${context.join("\n\n")}\n\nPergunta: ${c.question}`);
      if (answer.includes(c.expected)) hits++;
    }
    result[n] = hits / cases.length;
  }
  return result;
}
Com perguntas do seu domínio e enchimento parecido com o que o agente lê, a curva vale mais que qualquer limiar publicado, porque depende do seu modelo e da sua tarefa.
O que explica o context rot: atenção diluída?
A explicação mais repetida é que a atenção se dilui. A Anthropic, no texto sobre context engineering para agentes, dá a versão mais completa: no transformer, cada token atende a todos os outros, o que resulta em n² relações entre pares para n tokens, e essa capacidade se estica quando o contexto cresce. Acrescenta que os modelos aprendem seus padrões de atenção com dados em que sequências curtas são mais comuns que longas, então têm menos experiência com dependências ao longo de uma janela inteira. Daí a imagem de um "orçamento de atenção" que cada token novo consome.
Vale tratar isso como uma boa hipótese de trabalho, e não como fato demonstrado. Os próprios autores do NoLiMa dizem que sua análise sugere que a queda vem da dificuldade da atenção em contextos longos quando não há correspondência literal. E o relatório da Chroma traz um resultado que não se encaixa em uma intuição simples: com o texto de enchimento embaralhado em frases soltas, sem fluxo lógico, os modelos se saíram melhor do que com o texto coerente, em todos os 18 modelos. Os autores dizem que isso pode indicar influência da estrutura da entrada na atenção e escrevem, na seção de limitações, que o relatório não explica o mecanismo por trás da queda.
O que dá para afirmar com segurança é o lado empírico: o efeito existe, aparece em modelos de fornecedores diferentes e se mantém mesmo quando a tarefa não fica mais difícil.
Que tipo de token faz mais estrago?
Nem todo token extra pesa igual. A Chroma separa dois tipos, e a distinção é útil para quem monta contexto:
- conteúdo irrelevante: sem relação com a pergunta, como um log de outro serviço;
- distrator: relacionado ao tema da agulha, mas que não responde a pergunta, como a versão antiga de uma regra que continua no repositório.
Nos experimentos deles, a pergunta era sobre o melhor conselho de escrita recebido de um colega de faculdade, e os distratores eram frases quase iguais à resposta, trocando quem deu o conselho, a época ou o próprio conteúdo. Um único distrator já reduziu o desempenho em relação a só a agulha, e quatro distratores pioraram mais. O efeito também foi desigual: certos distratores apareciam com muito mais frequência nas respostas erradas que outros, e a diferença aumentava com o comprimento.
Isso muda o que "contexto ruim" quer dizer. Para um agente, os distratores típicos são resultados de busca quase certos, documentação de duas versões da mesma API, testes antigos ao lado dos novos. Drew Breunig, citado no texto da LangChain sobre o tema, dá nomes às falhas que vêm daí: envenenamento (uma alucinação entra no contexto), distração (o contexto pesa mais que o aprendido no treino), confusão (informação supérflua influencia a resposta) e conflito (partes do contexto discordam).
Outro ponto do relatório é o comportamento diante da dúvida. Nos testes com distratores, os modelos Claude foram os mais conservadores e tendiam a dizer que não achavam a resposta, enquanto os modelos GPT tinham as maiores taxas de resposta confiante e errada. Em produção são dois modos de falha: o agente que se abstém trava o fluxo, e o que alucina segue em frente com dado errado.
Quanto custa o ruído em uma tarefa realista?
O experimento mais próximo de um agente é o da LongMemEval, um benchmark de perguntas sobre históricos de conversa. A Chroma usou 306 prompts, com cerca de 113 mil tokens em média, e comparou com uma versão focada contendo só as partes relevantes, com cerca de 300 tokens em média. Todos os modelos se saíram melhor com a versão focada, e a diferença foi maior nos modelos Claude, em boa parte por abstenção.
Esse é o argumento central a favor de curar em vez de ampliar: com 300 tokens o modelo só raciocina, com 113 mil ele precisa recuperar e raciocinar ao mesmo tempo.
Como curar o contexto em código?
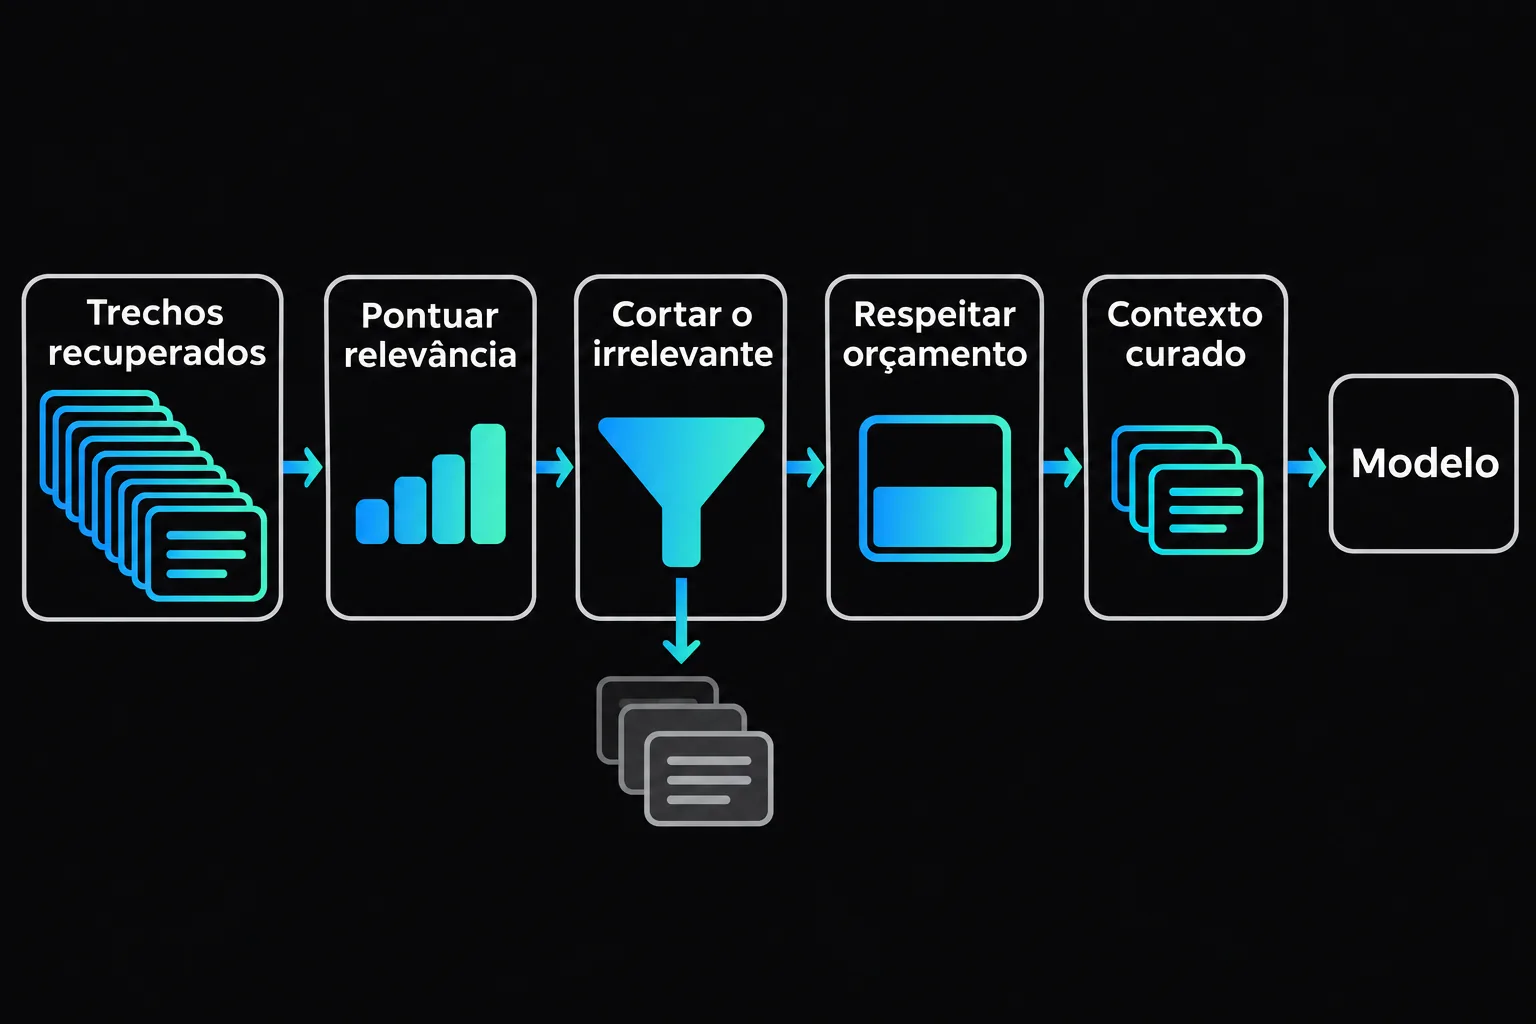
A saída prática é reduzir o que entra antes de chamar o modelo. Uma versão simples recebe trechos já pontuados por relevância (por embedding, BM25 ou outro critério seu) e mantém só os melhores dentro de um orçamento:
type Chunk = { id: string; text: string; tokens: number; score: number };

// Mantém os trechos mais relevantes que cabem no orçamento.
// minScore corta o que nem de longe responde à pergunta; budget limita o total.
function curate(chunks: Chunk[], budget: number, minScore: number): Chunk[] {
  const ranked = chunks.filter(c => c.score >= minScore).sort((a, b) => b.score - a.score);

  const kept: Chunk[] = [];
  let used = 0;
  for (const chunk of ranked) {
    if (used + chunk.tokens > budget) continue;
    kept.push(chunk);
    used += chunk.tokens;
  }
  return kept;
}
Há um custo escondido nessa abordagem. No relatório da Chroma, os pares com baixa similaridade entre pergunta e agulha foram os que degradaram mais rápido com o comprimento. Esses mesmos trechos, pouco parecidos com a pergunta, são os que um filtro por similaridade tende a cortar. Se minScore for agressivo, você troca o risco de diluir a atenção pelo risco de descartar a evidência. Por isso vale rodar accuracyByLength com e sem a curadoria, nas suas perguntas, e começar com um corte generoso.
A orientação da Anthropic para esse equilíbrio é achar o menor conjunto possível de tokens de alto sinal que maximize a chance do resultado desejado. Num pipeline de RAG, uma forma de aplicar isso é comprimir ou filtrar os documentos recuperados antes de injetá-los, em vez de despejar tudo o que a busca devolveu.
Quando um contexto grande continua sendo a resposta certa?
Os resultados acima têm limites. Os experimentos são controlados e deliberadamente simples, os modelos avaliados vão até a geração de meados de 2025, e a própria Chroma diz que aplicações reais, mais complexas, tendem a sentir o efeito com mais força, mas isso é uma expectativa e não uma medida. Não existe um limiar universal: a Anthropic observa que alguns modelos degradam de forma mais suave que outros, o que significa que a curva muda de um modelo para outro.
Há também tarefas em que o volume é o ponto. Resumir um documento inteiro, comparar dois contratos longos ou auditar um módulo de ponta a ponta exigem que o material esteja na janela, e cortar por relevância destrói o que se quer analisar. Nesses casos, a alternativa é dividir o trabalho em partes, cada uma com a sua janela, e juntar os resultados.
A regra que sobra é modesta: trate cada token como algo que precisa justificar a presença, meça a curva do seu modelo e só amplie a janela quando a medição mostrar que ampliar ajuda. Se você quer praticar esse tipo de decisão sobre agentes, a Formação em Inteligência Artificial cobre esse caminho.
Referências
- Kelly Hong, Anton Troynikov e Jeff Huber. Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma, julho de 2025.
- Ali Modarressi et al. NoLiMa: Long-Context Evaluation Beyond Literal Matching. arXiv, 2025.
- Mosh Levy, Alon Jacoby e Yoav Goldberg. Same Task, More Tokens: the Impact of Input Length on the Reasoning Performance of Large Language Models. arXiv, 2024.
- Anthropic. Effective context engineering for AI agents. Anthropic Engineering, 2025.
- LangChain. Context Engineering for Agents. LangChain Blog, 2025.
- Drew Breunig. How Long Contexts Fail. Junho de 2025.
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial15 nov 2026 8 min
Avaliação de LLM: juiz ou teste? Escolha o grader
Avaliação de LLM: quando usar LLM-as-judge ou teste determinístico e como combinar código, modelo e revisão humana num score ponderado, binário ou híbrido.
- Inteligência Artificial15 nov 2026 7 min
README para LLM: o que escrever para o agente
README para LLM e rules: o que escrever para o agente de IA parar de adivinhar comando de teste, porta e padrão de código, sem inflar o custo de tokens.
- Inteligência Artificial14 nov 2026 8 min
Prompt injection indireto em agentes e as defesas
Prompt injection indireto acontece quando o agente lê um texto com instruções do atacante. Veja o ataque, o que os benchmarks mediram e as defesas em camadas.

