README para LLM: o que escrever para o agente
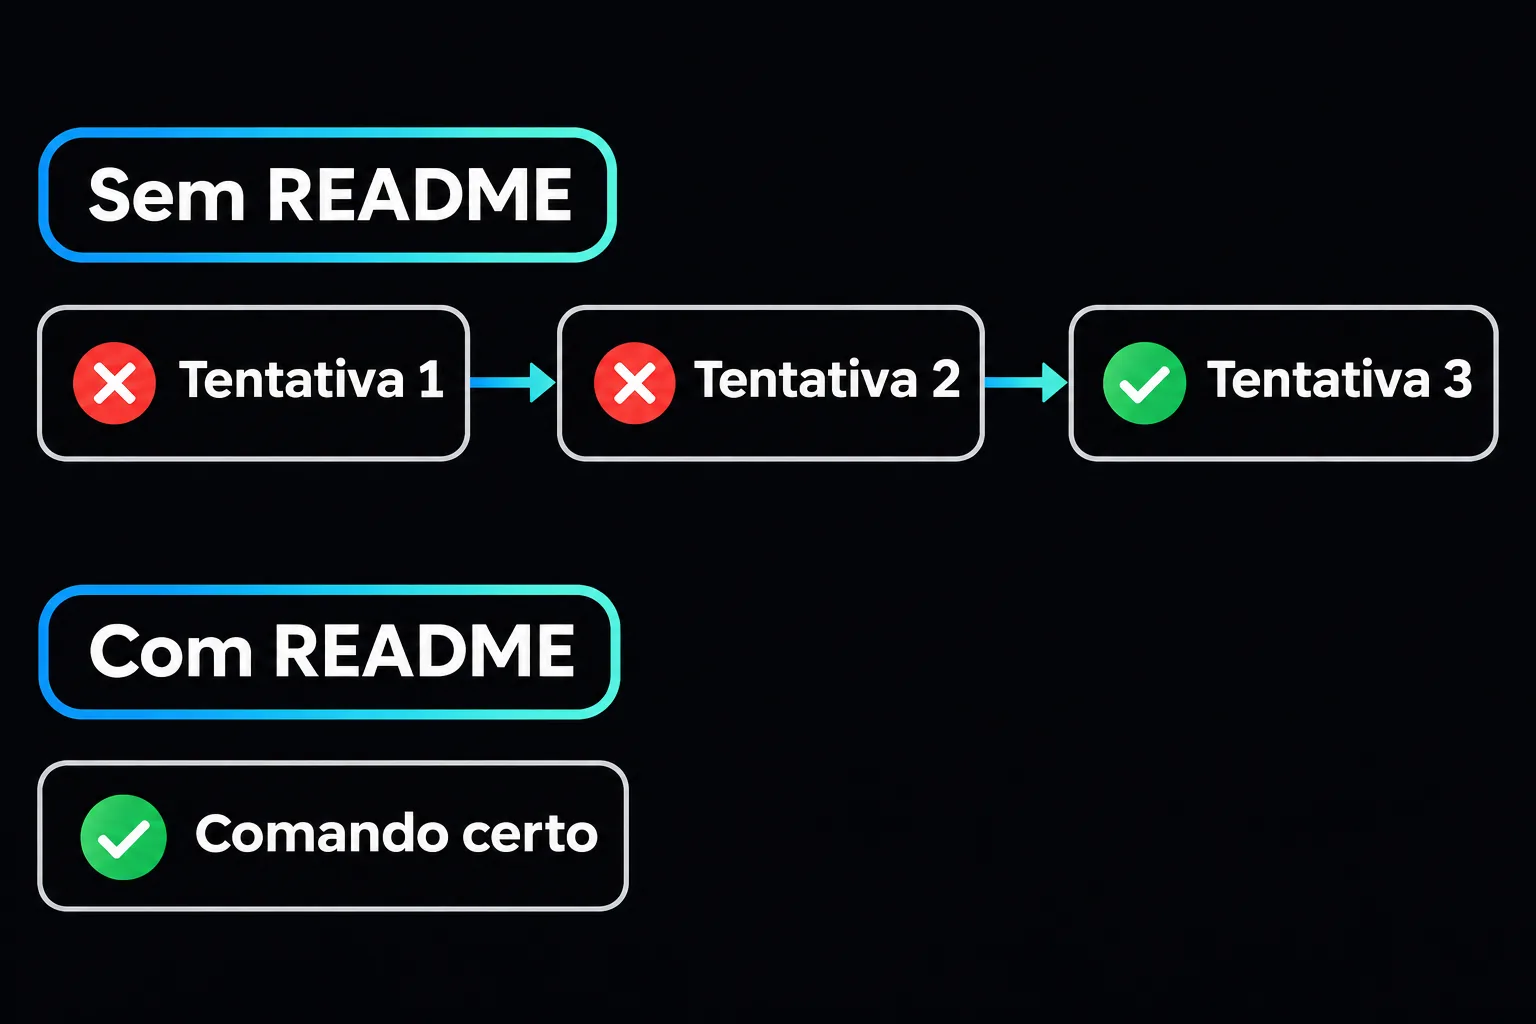
Um README para LLM precisa responder o que nenhum modelo consegue deduzir do código: qual é o comando de teste, em que porta o projeto sobe, como rodar uma migration. Sem essas respostas, o agente sorteia. Quem já pediu uma tarefa a um agente de código e viu o terminal tentar yarn test, depois yarn jest, depois npx jest conhece o problema, e cada volta dessa tentativa e erro é paga em tokens.
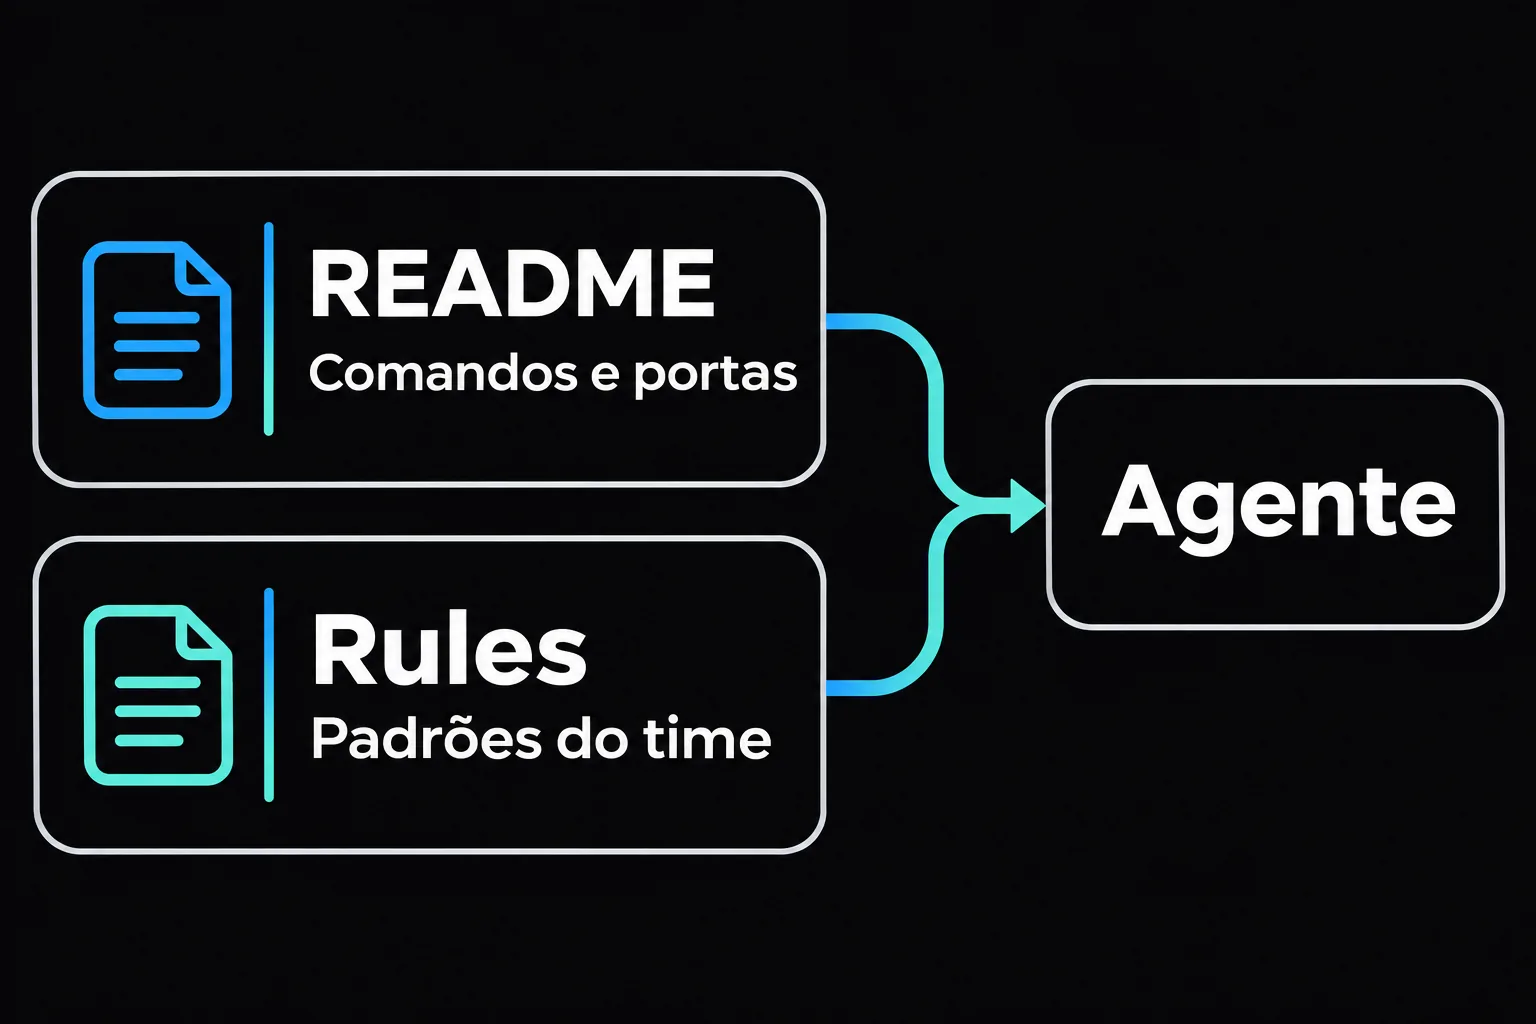
Na palestra que fiz no Dev Na Gringa Summit, usei esse exemplo para separar dois documentos de longo prazo: o README, com os comandos, e as rules, com os padrões do projeto. Este post mostra o que colocar em cada um, como escrever com o time e quanto é o suficiente.
Por que o agente não consegue adivinhar o comando e a porta?
Porque essa informação não está no código de forma confiável. O package.json pode ter um script test, mas o time pode rodar os testes com outro comando, com variáveis de ambiente ou com um banco de teste subindo antes. A porta pode estar num arquivo de configuração, num .env ou num compose. Um modelo que só vê o repositório escolhe o palpite mais provável, e o palpite errado custa uma rodada inteira: o comando falha, a saída volta para o modelo, ele interpreta e tenta de novo.
Esse custo de descoberta aparece em tarefas comuns:
- instalar dependências;
- rodar os testes;
- rodar uma migration de banco, que em projetos com ORM costuma ser um comando longo que ninguém memoriza;
- fazer o build e subir o projeto;
- saber em que porta cada serviço abre.
O README é o lugar para isso porque ele é um documento de longo prazo, que serve para qualquer tarefa e pode ser consultado a qualquer momento. Se ele não existir, a alternativa é a tentativa e erro.
Como é um README para LLM mínimo?
Ele não precisa ser bonito nem completo para humanos. Precisa ter os comandos que o agente vai executar, escritos exatamente como devem ser digitados:
## Comandos

- Instalar dependências: `npm ci`
- Testes unitários: `npm test`
- Testes de integração (precisa do banco): `docker compose up -d db && npm run test:integration`
- Migration: `npm run db:migrate`
- Subir em desenvolvimento: `npm run dev`

## Portas

- API: 3000
- Banco de dados: 5433 (não é a 5432)
A linha sobre a porta do banco é o tipo de detalhe que vale a pena registrar: é justamente o que destoa do padrão e faz o agente abrir a porta errada. Se um comando só funciona com uma condição, como o banco precisar estar no ar, a condição entra na mesma linha.
Existe um risco, porém: o README envelhece, e um comando desatualizado é pior do que nenhum, porque o agente confia nele. Uma checagem simples em CI evita isso. O script abaixo lê o README e o package.json e lista os scripts npm citados no texto que não existem:
import { readFileSync } from "node:fs";

type PackageJson = { scripts?: Record<string, string> };

const NPM_BUILTINS = new Set(["install", "ci", "i"]);

export function missingScripts(readme: string, pkg: PackageJson): string[] {
  const declared = new Set(Object.keys(pkg.scripts ?? {}));
  const cited = [...readme.matchAll(/npm (?:run )?([\w:-]+)/g)].map(match => match[1] ?? "");
  return [...new Set(cited)].filter(
    name => name !== "" && !NPM_BUILTINS.has(name) && !declared.has(name)
  );
}

const readme = readFileSync("README.md", "utf8");
const pkg: PackageJson = JSON.parse(readFileSync("package.json", "utf8"));
const missing = missingScripts(readme, pkg);

if (missing.length > 0) {
  console.error(`README cita scripts que não existem: ${missing.join(", ")}`);
  process.exit(1);
}
Ele não prova que o comando funciona, só pega o caso mais comum de documentação que ficou para trás.
O que entra nas rules, e o que fica de fora?
As rules vão além do README. São informações de longo prazo que valem para praticamente qualquer tarefa, e sem elas o resultado pode ser qualquer coisa: um arquivo numa pasta que não faz sentido, um padrão de nomes que ninguém usa, uma biblioteca de estilo diferente da do projeto.
Os exemplos que mostrei na palestra ajudam a ver o formato. Eles são curtos, imperativos e verificáveis:
- Todo código-fonte é escrito em inglês.
- Use camelCase para métodos, funções e variáveis, PascalCase para classes e interfaces e kebab-case para arquivos e diretórios.
- Nunca use flag param para chavear o comportamento de um método.
- Nunca aninhe mais de dois
if/elseno mesmo método; prefira early returns. - Sempre que possível, evite passar mais de três parâmetros; se precisar, agrupe-os num objeto.
- No Node, prefira
async/awaita callbacks. - No front-end, use os componentes do shadcn e o Tailwind, senão aparece um estilo aleatório.
Repare no critério. Cada regra responde a uma decisão que o modelo teria de tomar sozinho. Se você não disser, o agente precisa ler trechos de código, entender o padrão, devolver isso ao modelo e só então decidir como fazer. Descobrir custa tempo e custa token. Já uma regra como "escreva código limpo" não elimina decisão nenhuma, então só ocupa espaço.
Um bom filtro para cada linha candidata é perguntar se o agente já errou nisso, ou se erraria sem ela.
Por que não copiar rules prontas da internet?
Porque elas descrevem o projeto de outra pessoa. Uma rule de React copiada de um repositório popular pode não bater com o que você usa: outra biblioteca de estado, outra estrutura de pastas, outra convenção de testes. O agente vai obedecer, e você terá código consistente com um padrão que não é o seu.
O caminho que recomendei na palestra é sentar com o time, fazer uma reunião e escrever em português mesmo, discutindo cada regra:
- Faz sentido evitarmos dependência circular?
- Isso tem acontecido no nosso código?
- Se sim, a regra entra.
Depois do acordo, você pode pedir ao modelo que traduza as regras para o inglês e gere exemplos de código. A ordem importa: a decisão é humana e coletiva, a tradução é mecânica. Escrever as rules assim traz um efeito colateral útil, porque o time acaba combinando padrões que antes eram implícitos, e isso também ajuda quem acabou de entrar.
Quanto escrever sem inflar o custo?
O suficiente, e não mais que isso. Na palestra, avisei: não escreva 50 mil tokens de rules, porque você vai gastar mais. As rules que ficam sempre carregadas entram no contexto de toda tarefa, então cada linha desnecessária é cobrada em todas as execuções.
Um estudo da ETH Zurich ajuda a calibrar essa intuição. No paper "Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?", os autores rodaram quatro agentes de código (Claude Code, Codex com dois modelos e Qwen Code) em tarefas Python tiradas de issues e pull requests reais, em três condições: sem arquivo de contexto, com um arquivo gerado por LLM e com o arquivo que os desenvolvedores do projeto tinham commitado no repositório.
Na versão revisada do paper, de setembro de 2026, os arquivos gerados por LLM reduziram a taxa de resolução em 0,5% no SWE-bench Lite e em 2% no CTXbench, o benchmark criado pelos autores, e aumentaram o custo em 20% e 23%. Os arquivos escritos pelos desenvolvedores melhoraram a taxa em 2,4% na média, com custo até 19% maior. Nenhuma dessas diferenças de acerto foi estatisticamente significativa, mas o custo e o número de passos subiram em todos os casos. A primeira versão, de fevereiro, resumia o resultado como queda de 3% e ganho de 4%, e são esses os números que circularam em vídeos sobre o estudo.
Dois achados do paper conversam direto com este post. O primeiro é que os agentes seguem as instruções: ferramentas como uv e pytest quase só aparecem nas execuções quando o arquivo de contexto as menciona, o que é exatamente o efeito que você quer de um README com os comandos certos. O segundo é que visões gerais do repositório, do tipo "a pasta X contém Y", não ajudaram o agente a achar mais rápido os arquivos relevantes. A conclusão dos autores é que o arquivo deve trazer só instruções específicas que não estão disponíveis no código.
Também vale olhar o que o estudo não mediu. A métrica era a taxa de resolução, ou seja, os testes passarem; eficiência e segurança do código ficaram como trabalho futuro, segundo os próprios autores. Waldemar Neto, num vídeo sobre o paper, acrescenta duas ressalvas: o estudo trata todo arquivo já commitado como escrito por humano, o que não dá para garantir, e, na experiência dele, remover os arquivos faz o agente tomar decisões estranhas, até apagar testes ou escrever testes só para passar.
Juntando a palestra e o estudo, dá para tirar uma regra prática de manutenção:
- Comece com o mínimo: comandos, portas e as poucas regras de padrão que o time acordou.
- Adicione uma linha quando o agente errar de um jeito que a linha evitaria, e não antes.
- Mova o que só vale para uma parte do código para arquivos separados, carregados sob demanda. Waldemar descreve manter no arquivo principal só o básico e linkar documentos específicos, como padrões de API, e sugere dividir documentos de especificação que passam de umas 500 linhas.
- Quando uma rule só vale em certo contexto, use o escopo que a ferramenta oferece. Segundo ele, no Cursor uma rule pode ser configurada para carregar só quando um assunto aparece.
Qual é o limite dessa abordagem?
Ela organiza o que o agente sabe de antemão, mas não cobre tudo. O agente tende a seguir as rules, mas pode ignorar uma delas numa tarefa qualquer, e por isso padrões que precisam ser cumpridos sempre devem ter também uma checagem automática, como um linter ou um teste de arquitetura. Os nomes dos arquivos também mudam conforme a ferramenta (AGENTS.md, CLAUDE.md, .cursor/rules), mas o princípio é o mesmo em todas.
README e rules são só uma das camadas do que o agente carrega. Como elas se encaixam com o contexto da tarefa e o da conversa está em context engineering na prática, e o que ocupa a janela de contexto em o que ocupa a janela de contexto de um agente.
Na prática, isso significa um README com os comandos e as portas, algumas rules acordadas com o time e nada além do que já provocou erro. Se você quer trabalhar essa organização de contexto com projetos reais, ela faz parte da Formação em Inteligência Artificial.
Referências
- Palestra "A inteligência artificial não vai roubar seu emprego (ainda)", Rodrigo Branas, Dev Na Gringa Summit: YouTube
- "Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?", Thibaud Gloaguen, Niels Mündler-Sasahara, Mark Niklas Müller, Veselin Raychev e Martin Vechev (ETH Zurich e LogicStar.ai), 2026: arXiv
- "AGENTS.md e CLAUDE.md são Inúteis?", Waldemar Neto: YouTube
- "Refatoração com IA + Skills, Subagentes e Times de Agentes", Waldemar Neto: YouTube
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial16 nov 2026 8 min
Context rot: por que mais contexto piora o agente
Context rot: a precisão do LLM cai quando a entrada cresce, mesmo em tarefas simples. Veja como isso foi medido, o que explica o efeito e como curar o contexto.
- Inteligência Artificial15 nov 2026 8 min
Avaliação de LLM: juiz ou teste? Escolha o grader
Avaliação de LLM: quando usar LLM-as-judge ou teste determinístico e como combinar código, modelo e revisão humana num score ponderado, binário ou híbrido.
- Inteligência Artificial14 nov 2026 8 min
Prompt injection indireto em agentes e as defesas
Prompt injection indireto acontece quando o agente lê um texto com instruções do atacante. Veja o ataque, o que os benchmarks mediram e as defesas em camadas.

