Chave de idempotência em agentes: o retry que duplica
Um agente chama a tool que envia o e-mail de boas-vindas, o timeout estoura e a resposta nunca chega. Um loop de agente que trata a falta de resposta como "falhou" tenta de novo, só que o e-mail pode já ter saído. O resultado é uma ação duplicada causada pelo próprio mecanismo de retry.
O problema tem nome na literatura recente: falha não atômica. A defesa combina duas peças: verificar a pós-condição antes de repetir e mandar uma chave de idempotência em toda tentativa.
Por que o timeout não diz se a ação aconteceu?
Existem dois canais entre o agente e o sistema que ele altera. O canal de efeito é o que de fato mudou no servidor. O canal de resposta é o que o agente consegue ver. Em uma tool atômica, os dois andam juntos: a resposta descreve a transição de estado. Em sistemas reais, eles se separam.
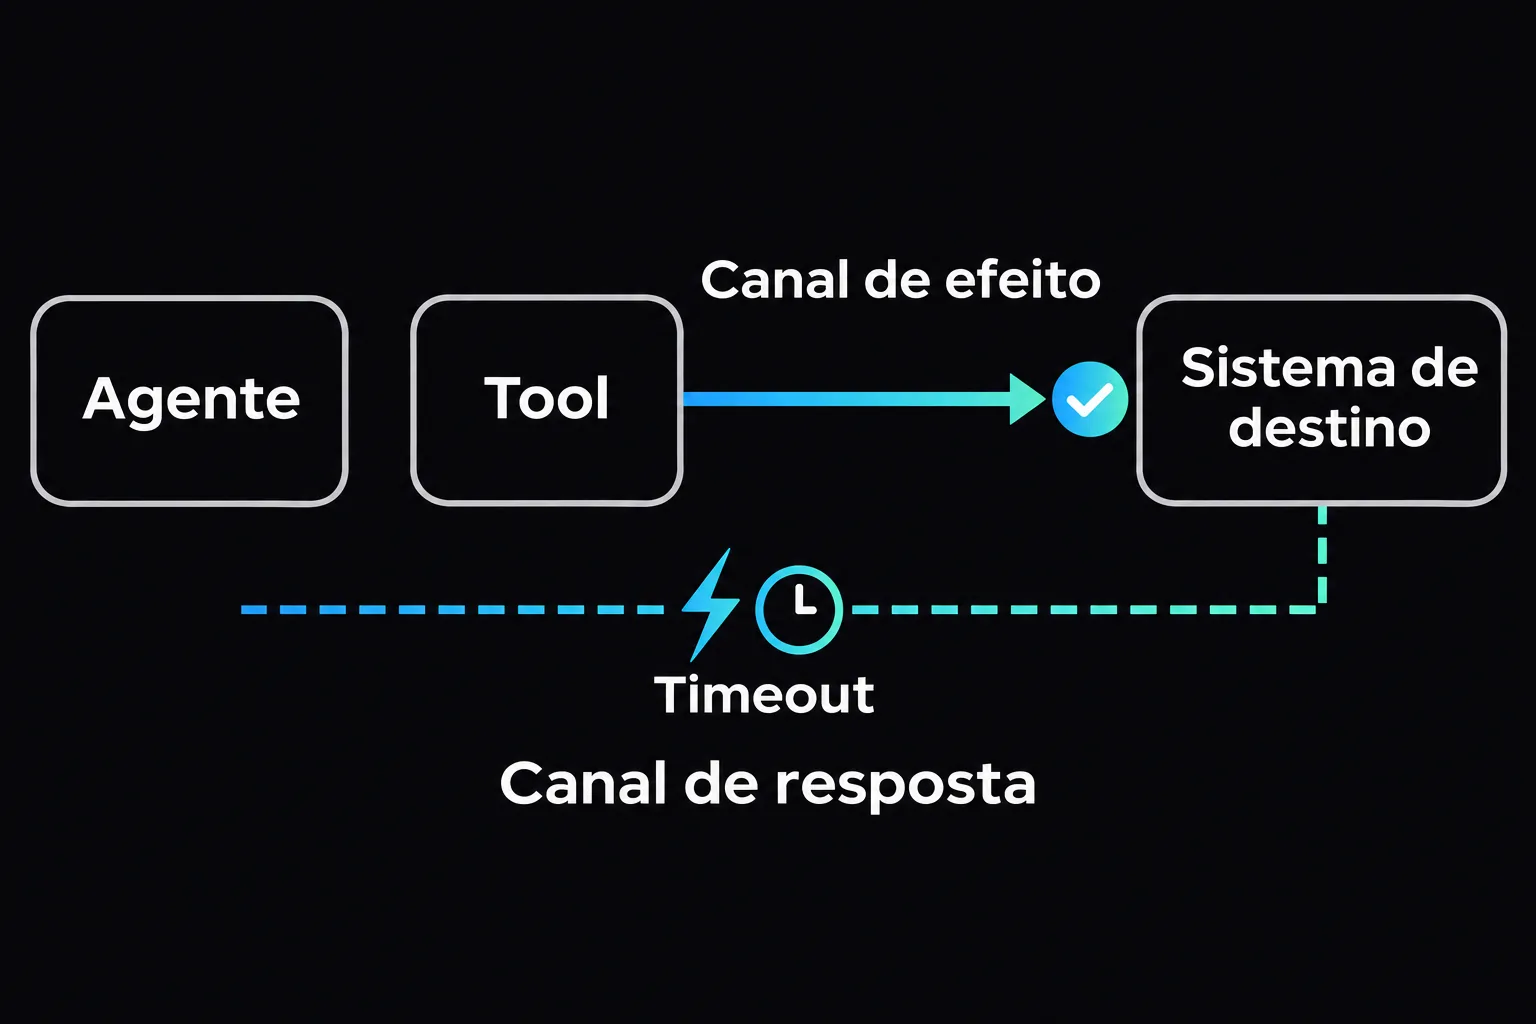
O paper Verified Tool Calls Improve LLM Agent Reliability Under Non-Atomic Failures, de Mansoor, Phadke e Rana (arXiv, julho de 2026), usa essa distinção e lista quatro modos de falha que quebram a suposição de atomicidade:
- timeout depois do despacho: o servidor começou ou terminou o trabalho, mas a resposta não chegou;
- visibilidade atrasada: a ação funcionou, mas uma leitura logo depois ainda devolve o estado antigo, por consistência eventual;
- sucesso parcial: uma operação composta aplica só parte dos efeitos, às vezes com HTTP 200;
- conflito por estado velho: outro processo alterou o dado desde a última observação do agente.
Os dois primeiros são os mais traiçoeiros. O timeout não diz nada sobre o efeito, então a única forma de saber é consultar o sistema de destino. Só que, com visibilidade atrasada, essa consulta pode cair numa réplica defasada e fazer o agente concluir que a ação não ocorreu, quando ocorreu.
O artigo de engenharia da AWS sobre retries seguros com APIs idempotentes descreve o mesmo dilema com um processo de provisionamento que lança uma instância EC2 e não recebe resposta: não está claro se a carga de trabalho está rodando, e repetir a chamada pode criar mais de uma. Para um agente, o erro de rede fala só da conexão; se a ação aconteceu, quem responde é o estado do sistema.
O que o paper mediu?
Os autores montaram um simulador com injeção de falhas e duas tarefas. Em activate_customer, o agente cria o cliente, ativa e envia exatamente uma mensagem de boas-vindas. Em record_invoice, atualiza uma linha, cria um registro e marca o status. Um mesmo modelo (Gemini Flash-Lite, temperatura 0) rodou todas as variantes, e o que mudava era o prompt e o wrapper em volta da tool. A baseline repete a chamada direto, sem chave de idempotência; a variante com verificação consulta o estado externo antes de decidir e manda a mesma chave em toda tentativa. Nas duas, o limite é uma repetição por operação.
Cada configuração teve 25 episódios por método. No nível de falha alto, as probabilidades de falha injetadas foram 0,35 de timeout, 0,25 de visibilidade atrasada, 0,15 de sucesso parcial e 0,10 de conflito. Segundo o paper, a taxa de ações duplicadas ficou assim:
| Tarefa | Baixo / médio / alto, baseline | Baixo / médio / alto, com verificação |
|---|---|---|
activate_customer | 20% / 44% / 72% | 0% / 16% / 20% |
record_invoice | 32% / 52% / 76% | 0% / 16% / 20% |
Na taxa de sucesso, activate_customer caiu na baseline de 92% (falha baixa) para 64% (falha alta), enquanto o agente com verificação ficou em 100% nos três níveis. Em record_invoice, as duas variantes já iam bem: 100%, 96% e 96% na baseline contra 100%, 96% e 100%.
Com 25 episódios por célula, cada episódio vale 4 pontos percentuais, então diferenças pequenas na tabela são um ou dois episódios. Os próprios autores apontam que o ambiente é um simulador, com duas tarefas e verificadores escritos à mão, e não APIs de produção. Leia como evidência do mecanismo, sem levar o tamanho do ganho para a sua produção.
Há ainda um detalhe do experimento de ablação, rodado à parte, só em activate_customer com falha média e com outra configuração, por isso os números não se comparam com os da tabela. Verificar sem tentar de novo chegou a cerca de 80% de sucesso e 20% de duplicados. A versão completa, que verifica e repete quando necessário, ficou em cerca de 72% e 28%, e a baseline em cerca de 58% e 42%. O paper conclui que checar se a ação já aconteceu é a parte que mais pesa, e que retry deve ser usado com critério, não de forma automática.
Como representar "não sei" no código?
O verificador do paper devolve três valores: verdadeiro, falso ou desconhecido. A terceira opção existe por causa da visibilidade atrasada. Se a leitura não consegue provar que o efeito ocorreu, a ausência do registro só significa "não" quando a leitura é consistente. Caso contrário, o estado correto é não verificado, com o motivo anexado.
O verificador também precisa ser somente leitura, para que consultar várias vezes seja seguro, e precisa checar a pós-condição inteira. Checar só se o registro existe aprova um sucesso parcial como se fosse completo.
No algoritmo do paper, um "desconhecido" leva a mais uma volta do laço, e os autores citam pedir intervenção humana ou encerrar com segurança como caminhos a explorar. O exemplo abaixo, em TypeScript, escolhe parar. Erros de rejeição definitiva encerram a execução; erros ambíguos disparam a verificação com backoff; só um "não" confirmado autoriza repetir, e a repetição reusa a mesma chave.
type Verdict = { state: "yes" } | { state: "no" } | { state: "unverified"; reason: string };

class Rejected extends Error {}
class Ambiguous extends Error {}

interface SideEffect<T> {
  key: string;
  execute(key: string): Promise<T>;
  verify(): Promise<Verdict>; // somente leitura
}

type Outcome<T> =
  | { status: "done"; via: "response"; value: T }
  | { status: "done"; via: "verification" }
  | { status: "rejected"; reason: string }
  | { status: "unknown"; reason: string };

const sleep = (ms: number) => new Promise<void>(r => setTimeout(r, ms));

async function runVerified<T>(
  op: SideEffect<T>,
  maxRetries = 1,
  backoffMs = 500,
  maxChecks = 3
): Promise<Outcome<T>> {
  for (let attempt = 0; attempt <= maxRetries; attempt++) {
    try {
      const value = await op.execute(op.key);
      return { status: "done", via: "response", value };
    } catch (err) {
      if (err instanceof Rejected) {
        return { status: "rejected", reason: err.message };
      }
      if (!(err instanceof Ambiguous)) throw err;
    }

    let verdict: Verdict = { state: "unverified", reason: "not checked" };
    for (let check = 0; check < maxChecks; check++) {
      await sleep(backoffMs * 2 ** check);
      verdict = await op.verify();
      if (verdict.state !== "unverified") break;
    }

    if (verdict.state === "yes") return { status: "done", via: "verification" };
    if (verdict.state === "unverified") {
      return { status: "unknown", reason: verdict.reason };
    }
  }
  return { status: "unknown", reason: "retry budget exhausted" };
}
O retorno unknown não deve virar sucesso para fechar a tarefa nem falha para tentar outra vez. O agente sai do laço, registra o que sabe e devolve a decisão a uma pessoa ou a uma rotina de conciliação.
Como a verificação se encaixa numa tool real?
Para o envio de e-mail, a pós-condição é "existe uma mensagem com esta chave para este destinatário". A chave é gerada uma vez, antes da primeira tentativa, e acompanha todas as seguintes:
interface Mailbox {
  readsAreConsistent: boolean;
  send(key: string, to: string, body: string): Promise<{ id: string }>;
  findByKey(key: string): Promise<{ id: string; to: string } | undefined>;
}

function welcomeEmail(mail: Mailbox, to: string): SideEffect<{ id: string }> {
  return {
    key: crypto.randomUUID(),
    execute(key) {
      return mail.send(key, to, "Bem-vindo!").catch(() => {
        throw new Ambiguous("timeout");
      });
    },
    async verify() {
      try {
        const found = await mail.findByKey(this.key);
        if (found && found.to === to) return { state: "yes" };
        if (mail.readsAreConsistent) return { state: "no" };
        return { state: "unverified", reason: "leitura pode estar defasada" };
      } catch {
        return { state: "unverified", reason: "leitura falhou" };
      }
    },
  };
}
Por simplicidade, o catch trata qualquer erro como ambíguo. Numa tool de verdade, erro de validação é rejeição definitiva, e só erro de rede justifica o caminho de verificação.
O que a chave de idempotência garante?
A verificação reduz repetições desnecessárias, mas existe uma janela: a ação pode concluir depois da leitura que disse "não". Para cobri-la, o paper manda a mesma chave em toda tentativa da mesma operação lógica, e o servidor deduplica. Sem suporte a chave no servidor, dizem os autores, a verificação é proteção de melhor esforço e ainda sobra risco de corrida.
A garantia, porém, é um contrato do serviço, e cada serviço define o seu. A documentação da Stripe sobre requisições idempotentes descreve o da API v1: o cliente gera a chave, e o servidor guarda o status e o corpo da primeira resposta depois que o endpoint começa a executar. Repetições com a mesma chave devolvem essa resposta salva, inclusive um erro 500, e a camada de idempotência compara os parâmetros e devolve erro se eles mudaram. Se a requisição falhou na validação ou conflitou com outra em execução simultânea, nada é salvo e dá pra repetir. As chaves podem ser removidas depois de pelo menos 24 horas, e reusar uma chave já removida gera uma requisição nova. Na API v2 a regra muda: a Stripe tenta concluir o trabalho que falhou ou ficou parcial e devolve a resposta atualizada.
Para o agente, a consequência prática é que a chave impede a duplicata, mas não garante que repetir resolva: na v1, repetir depois de um 500 devolve o mesmo 500. A AWS acrescenta que um contrato rigoroso de no máximo uma execução tem custo e complexidade no serviço, e que nem toda solução precisa dele.
O lado servidor mínimo desse contrato cabe em poucas linhas:
interface Stored {
  fingerprint: string;
  response: { id: string };
}

class IdempotentStore {
  private seen = new Map<string, Stored>();

  handle(
    key: string,
    params: { to: string; body: string },
    run: () => { id: string }
  ): { id: string } {
    const fingerprint = JSON.stringify([params.to, params.body]);
    const prior = this.seen.get(key);
    if (prior) {
      if (prior.fingerprint !== fingerprint) {
        throw new Rejected("mesma chave com parâmetros diferentes");
      }
      return prior.response;
    }
    const response = run();
    this.seen.set(key, { fingerprint, response });
    return response;
  }
}
Esta versão guarda tudo em memória, só salva respostas de sucesso (diferente da Stripe v1, que salva até o 500) e não resolve requisições concorrentes com a mesma chave. A AWS lembra que, num serviço real, gravar a chave e aplicar o efeito precisam ser uma operação atômica, por exemplo na mesma transação do banco, com restrição de unicidade na chave. O que o exemplo mostra é a regra principal: a chave só vale para a mesma intenção. A AWS trata a mesma chave com parâmetros diferentes como outra intenção e devolve erro de validação. Se destinatário, valor ou alvo mudaram, é outra operação e precisa de outra chave.
Quando repetir, quando parar?
Juntando a verificação e a chave, uma resposta ambígua tem quatro saídas possíveis:
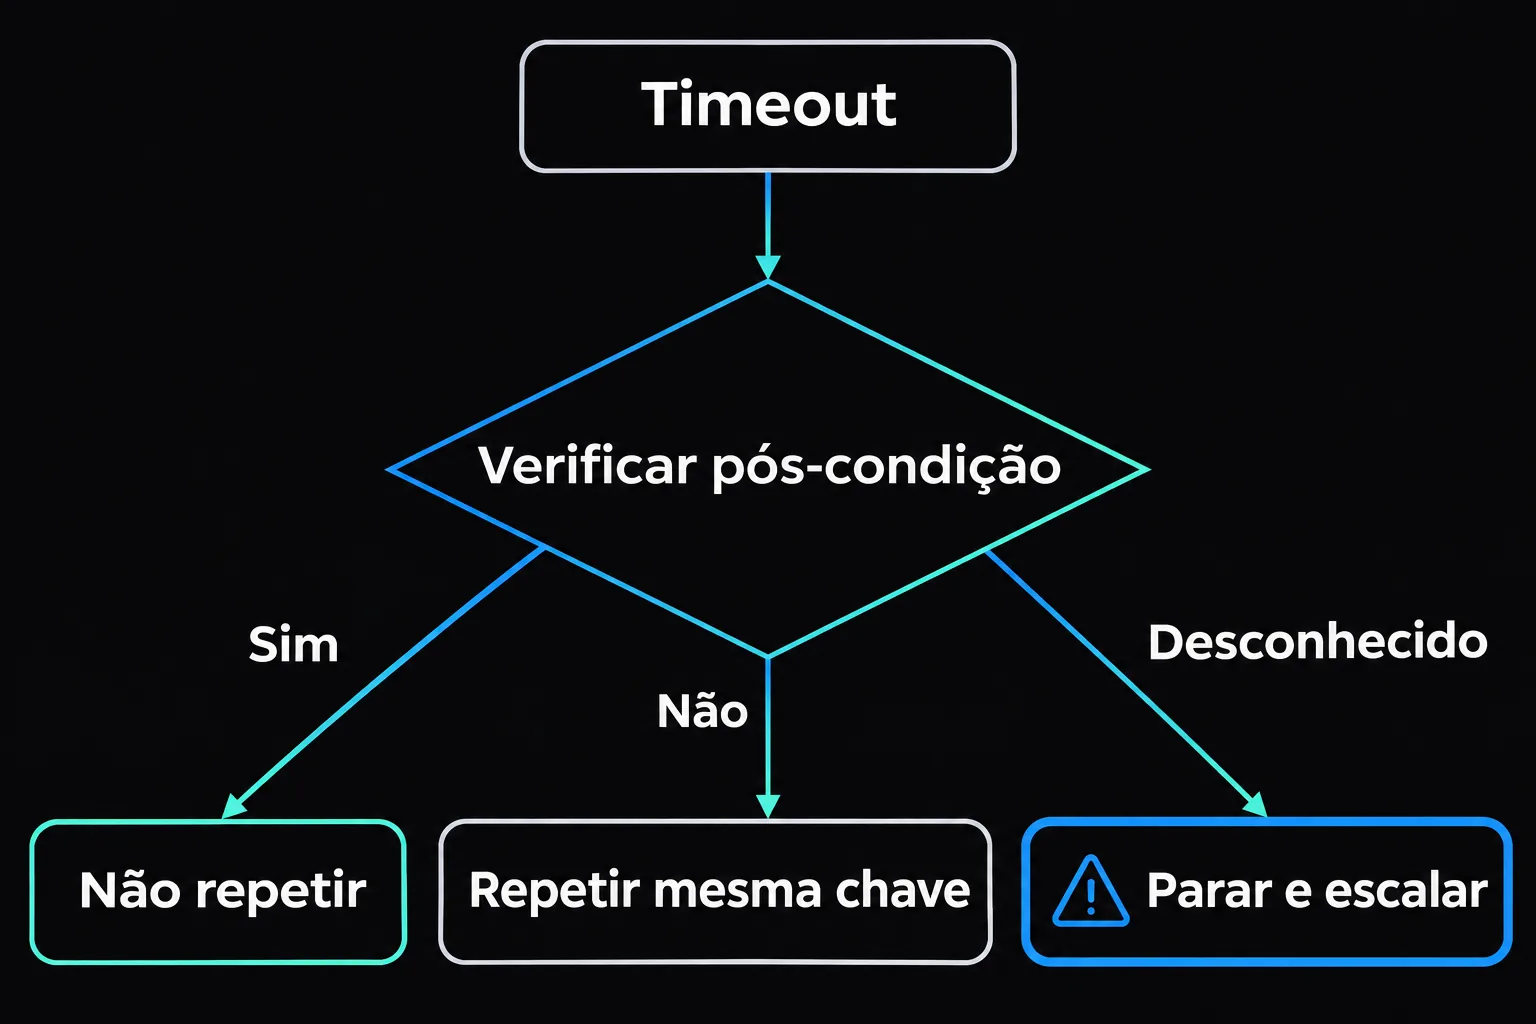
- a leitura mostra a pós-condição completa: a ação aconteceu, então não repita e devolva o que foi lido como prova (
yes); - uma leitura consistente mostra que o efeito não existe: repita com a mesma chave e os mesmos parâmetros (
no); - a leitura não decide, mas o serviço tem contrato de idempotência: repetir com a mesma chave, dentro da janela de retenção, não cria um segundo efeito, mas ainda vale verificar depois, porque a resposta guardada pode ser um erro;
- a leitura não decide e não há contrato: pare em
unknowne passe o caso para quem pode reconciliar.
O runVerified trata a terceira saída de forma conservadora e para também. Com um contrato que você conhece bem, dá pra trocar esse return por uma repetição com a mesma chave. Em todas as saídas, a decisão usa a leitura do sistema de destino. O que o modelo afirma ter feito fica de fora.
Nem toda tool precisa disso. Leituras e operações idempotentes por natureza, como definir um campo para um valor fixo, podem ser repetidas sem verificar. O custo aparece em ações que criam, enviam, cobram ou disparam, e para elas cada verificação adiciona latência, uma leitura a mais e a obrigação de escrever uma pós-condição por tool, já que o sistema não consegue inferi-la sozinho.
Essa disciplina também muda a forma de avaliar agentes. O paper lembra que olhar só o estado final esconde caminhos inseguros: em record_invoice, um agente pode terminar com o estado certo depois de ter feito escritas duplicadas no caminho. Se você já mede tentativas em trials, como no post sobre avaliação de agentes com tarefa, trial e grader, inclua uma checagem de efeitos duplicados no grader. E o laço acima é uma peça concreta do loop de agente: ele define o que o agente faz quando a observação não permite decidir.
Idempotência e consistência eventual são assuntos antigos de sistemas distribuídos que agora valem para qualquer agente com acesso a APIs. Esse tipo de base é tratado em mais profundidade na formação em Inteligência Artificial.
Referências
- Mansoor, I. K.; Phadke, A.; Rana, P. Verified Tool Calls Improve LLM Agent Reliability Under Non-Atomic Failures. arXiv:2608.02645, 31 de julho de 2026.
- Featonby, M. Making retries safe with idempotent APIs. Amazon Builders' Library.
- Stripe. Idempotent requests. Stripe API Reference.
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial22 nov 2026 7 min
Git worktree para agentes em paralelo, sem colisão
Como usar git worktree para rodar agentes de código em paralelo sem colisão: comandos reais, best-of-N e as pegadinhas de porta, node_modules, .env e banco.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.

