LLM-as-judge: vieses de posição e como calibrar
Um LLM-as-judge pode concordar com humanos em mais de 80% dos casos e mesmo assim mudar de veredito quando você apenas troca a ordem das duas respostas. As duas coisas são verdade ao mesmo tempo, e a primeira esconde a segunda. Este post mostra o que a pesquisa mediu sobre os vieses do juiz, como transformar isso num teste que roda no seu CI e como calibrar o juiz antes de confiar nele. A decisão de usar um juiz, em vez de um teste determinístico, está em LLM-as-judge ou teste determinístico. Aqui o juiz já foi escolhido, e a pergunta é o quanto a nota dele merece crédito.
O que o paper do MT-Bench realmente mediu?
O artigo "Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena" (Zheng et al., NeurIPS 2023) é a origem da frase "o GPT-4 concorda com humanos". O número vem com condições. Na comparação em pares do MT-Bench, sem contar empates, o GPT-4 concordou com especialistas humanos em 85% dos casos, contra 81% de concordância entre os próprios humanos. Contando os empates, a concordância caiu para 66% (GPT-4) e 63% (humanos).
Dois cuidados antes de repetir esse resultado em outro contexto. O primeiro é que são 80 perguntas de chat em oito categorias, avaliadas por um modelo de 2023. O segundo é que os 85% contam só os votos em que juiz e humano escolheram um lado. No cenário com empates, quando o GPT-4 mudava de voto ao trocar a ordem das respostas, o paper contava esse caso como empate. A média também esconde a distribuição: no mesmo paper, a concordância sem empates entre GPT-4 e humanos sobe de 70% para quase 100% conforme cresce a diferença de desempenho entre os dois modelos comparados. Quando os dois modelos têm desempenho parecido, o juiz concorda menos com os humanos, e é nesses pares que o viés aparece.
Quais vieses o juiz tem e quão grandes são?
O mesmo paper testou três vieses, e outros estudos refinaram o quadro.
Viés de posição
Os autores geraram duas respostas parecidas para cada pergunta (duas chamadas ao GPT-3.5 com temperatura 0,7) e pediram ao juiz que escolhesse, nas duas ordens. Com o prompt padrão, o Claude-v1 foi consistente em 23,8% dos casos e preferiu a primeira posição em 75%. O GPT-3.5 foi consistente em 46,2%. O GPT-4, o melhor do grupo, em 65%. Os autores avisam que o teste é difícil, porque as respostas são muito parecidas e às vezes indistinguíveis até para humanos, mas é justamente esse tipo de par que aparece quando você compara duas versões de um prompt.
Viés de verbosidade
No ataque "repetitive list", os autores pegaram 23 respostas com lista numerada e inseriram no começo uma paráfrase da própria lista, sem informação nova. Se o juiz achasse a versão inflada melhor, o ataque tinha funcionado. Funcionou em 91,3% dos casos com Claude-v1 e com GPT-3.5, e em 8,7% com o GPT-4. Como controle, os autores verificaram que os juízes sempre davam empate quando as duas respostas eram idênticas, então o problema aparece quando uma das versões fica mais longa sem ganhar conteúdo.
Autopreferência
Aqui o paper é mais cauteloso do que costuma ser citado. Comparado aos humanos, o GPT-4 deu a si mesmo uma taxa de vitória 10% maior, e o Claude-v1, 25% maior. Só que esses juízes também favoreceram outros modelos, o GPT-3.5 não se favoreceu, e os próprios autores escrevem que, com poucos dados e diferenças pequenas, o estudo não consegue determinar se existe viés de autopreferência (self-enhancement bias). Dá para tratar a autopreferência como suspeita razoável e barata de evitar, mas esse paper não a estabelece como fato.
O que outros estudos acrescentam
Dois outros trabalhos ampliam o quadro. Zhou et al. (2024), em "Mitigating the Bias of Large Language Model Evaluation", argumentam que juízes premiam qualidade superficial, como verbosidade e fluência, e deixam passar respostas que não seguem a instrução. O CALM, em "Justice or Prejudice?", automatiza a medição de 12 tipos de viés por perturbações guiadas por princípios e conclui que os modelos avançados têm bom desempenho geral, mas que vieses significativos persistem em tarefas específicas.
O viés de posição é ruído ou é sistemático?
A pergunta importa porque ruído se resolve com média, e viés sistemático não. O estudo "Judging the Judges" (2024) mediu isso com 15 juízes, 22 tarefas e cerca de 40 modelos geradores, em mais de 150 mil instâncias de avaliação. Ele separa três métricas:
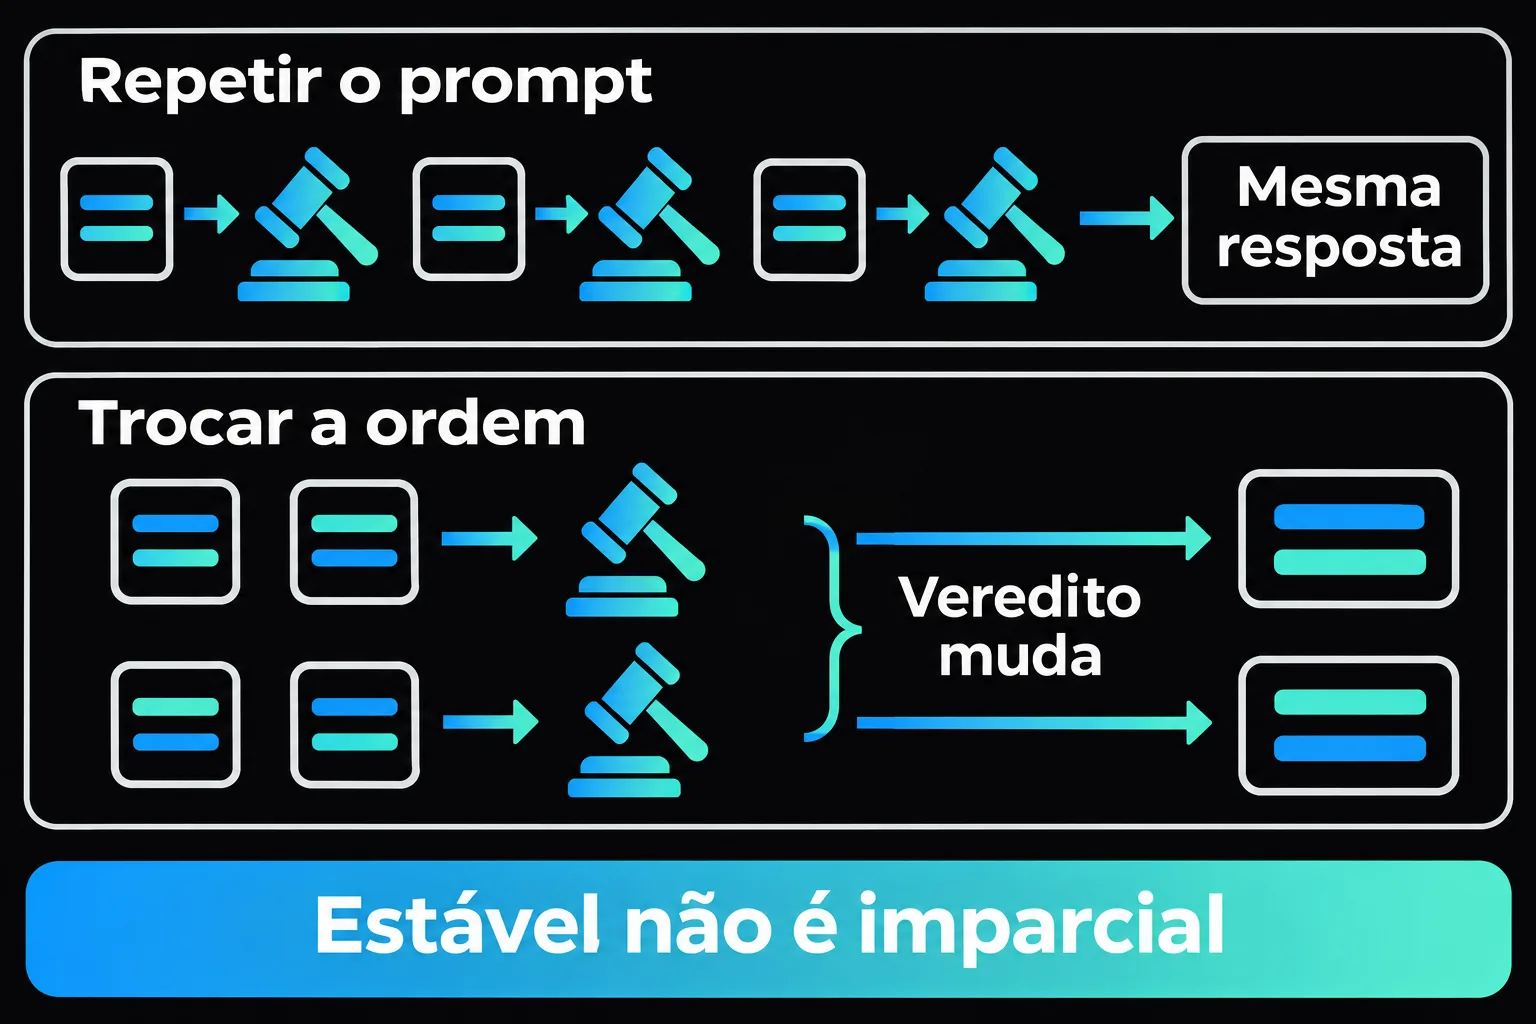
- Estabilidade por repetição: o juiz dá a mesma resposta ao mesmo prompt repetido? Os juízes capazes ficaram acima de 0,85, e os melhores (Claude-3.5-Sonnet, GPT-4, Llama-3.3-70B) acima de 0,95.
- Consistência de posição: o juiz prefere a mesma resposta depois que a ordem é permutada?
- Justiça de preferência: quando ele é inconsistente, tende ao primeiro ou ao segundo?
O resultado central é que o juiz é quase determinístico na repetição e ainda assim enviesado na posição. Ou seja, rodar o mesmo prompt três vezes e ver a mesma resposta não prova nada sobre posição. O viés também varia por juiz e por tarefa, e depende fortemente da diferença de qualidade entre as respostas: quanto mais parecidas, menor a consistência. O tamanho dos componentes do prompt teve relação fraca com o viés.
A consequência prática é que a concordância média com humanos pode estar alta porque a maioria dos pares tem uma resposta claramente melhor. O viés mora nos pares próximos, que são os que você usa para decidir se o prompt B superou o A.
Como testar o juiz com transformações controladas?
Tratando o juiz como um instrumento de medida e sujeitando-o a testes de invariância. A ideia é aplicar transformações em que o veredito não deveria mudar, ou só deveria mudar numa direção, e contar as violações:
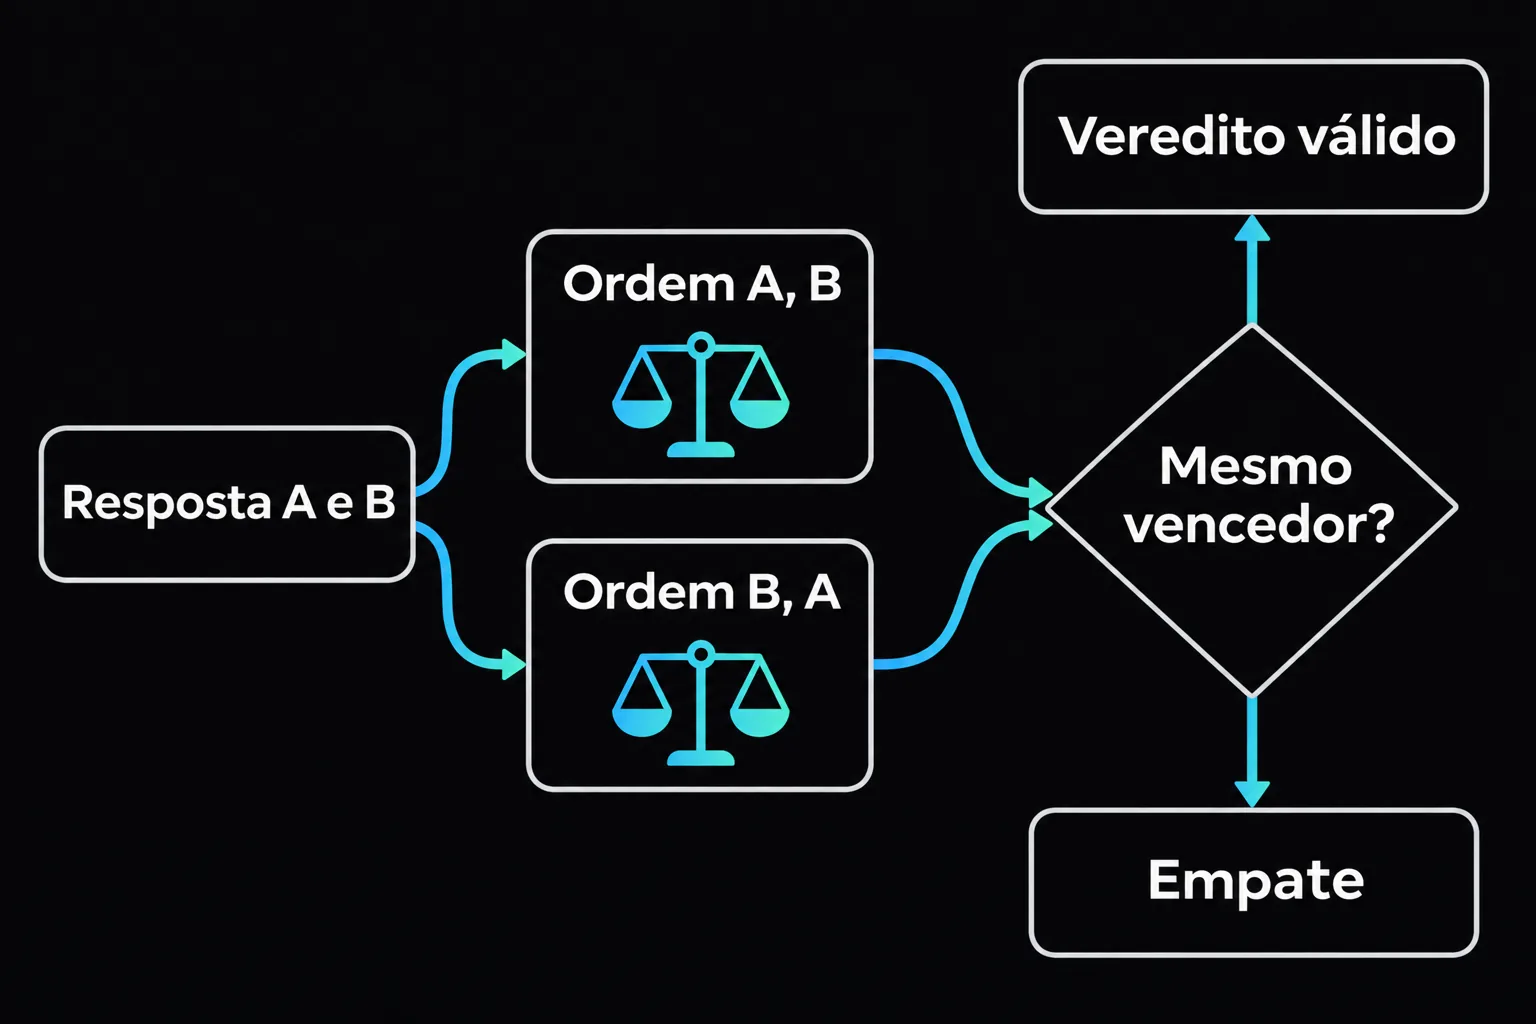
- Trocar a ordem das respostas. O vencedor não pode depender de quem veio primeiro.
- Mudar formatação irrelevante. Lista, negrito ou parágrafo não alteram o conteúdo.
- Parafrasear sem mudar o sentido.
- Anexar conteúdo sem suporte. A resposta com a afirmação inventada não pode passar a ganhar.
Veja um harness mínimo. O juiz é uma função que recebe a pergunta e duas respostas e devolve "A", "B" ou "tie". Toda comparação roda nas duas ordens, e o veredito só vale quando as duas concordam:
type Choice = "A" | "B" | "tie";
type Side = "x" | "y" | "tie";
type PairJudge = (question: string, a: string, b: string) => Promise<Choice>;
type Pair = { question: string; x: string; y: string };

const toSide = (pick: Choice, firstIsX: boolean): Side =>
  pick === "tie" ? "tie" : (pick === "A") === firstIsX ? "x" : "y";

async function bothOrders(judge: PairJudge, p: Pair) {
  const [f, s] = await Promise.all([judge(p.question, p.x, p.y), judge(p.question, p.y, p.x)]);
  const forward = toSide(f, true);
  const swapped = toSide(s, false);
  const verdict: Side = forward === swapped ? forward : "tie";
  return { forward, swapped, verdict };
}

async function positionReport(judge: PairJudge, pairs: Pair[]) {
  let consistent = 0;
  let primacy = 0; // a resposta em primeiro lugar venceu nas duas ordens
  let recency = 0; // a resposta em segundo lugar venceu nas duas ordens
  for (const p of pairs) {
    const { forward, swapped } = await bothOrders(judge, p);
    if (forward === swapped) consistent++;
    else if (forward === "x" && swapped === "y") primacy++;
    else if (forward === "y" && swapped === "x") recency++;
  }
  const n = pairs.length;
  return { consistency: consistent / n, primacy: primacy / n, recency: recency / n };
}
A consistência diz quanto do seu resultado sobrevive à troca. Primacy e recency dizem para onde o juiz erra: se primacy for muito maior que recency, ele puxa para a primeira posição, como o Claude-v1 do MT-Bench. Os casos restantes são os de empate numa ordem e vitória na outra. Esta é uma versão simplificada da métrica de justiça do paper, que combina as contagens de outra forma.
As outras transformações seguem o mesmo molde. Cada uma declara o que espera do veredito:
type Transform = {
  name: string;
  apply: (answer: string) => Promise<string>;
  expect: "same" | "not-better"; // o veredito fica igual, ou x não pode melhorar
};

const rank: Record<Side, number> = { y: 0, tie: 1, x: 2 };
const transforms: Transform[] = [
  {
    name: "formatacao",
    expect: "same",
    apply: async a =>
      a
        .split(/(?<=\.)\s+/)
        .map(s => `- ${s}`)
        .join("\n"),
  },
  {
    name: "conteudo-sem-suporte",
    expect: "not-better",
    apply: async a => `${a}\n\nSegundo estudos recentes, isso vale em 97% dos casos.`,
  },
];

async function invariance(judge: PairJudge, pairs: Pair[], t: Transform) {
  let violations = 0;
  for (const p of pairs) {
    const before = (await bothOrders(judge, p)).verdict;
    const after = (await bothOrders(judge, { ...p, x: await t.apply(p.x) })).verdict;
    const broke = t.expect === "same" ? after !== before : rank[after] > rank[before];
    if (broke) violations++;
  }
  return { transform: t.name, violationRate: violations / pairs.length };
}
Uma paráfrase entra como mais uma Transform, com apply chamando um modelo. Um violationRate alto na formatação ou no conteúdo sem suporte é um problema de medida mesmo que a concordância média com humanos pareça boa. E como o harness é código, ele roda a cada mudança de modelo ou de prompt do juiz.
Como calibrar o LLM-as-judge depois de medir o viés?
Cada mitigação ataca um viés específico, e nenhuma é grátis.
Trocar a ordem e exigir as duas vitórias
O MT-Bench descreve a versão conservadora: chamar o juiz duas vezes, trocando a ordem, e declarar vitória só quando a mesma resposta ganha nas duas. Se divergir, é empate. É o que verdict faz acima. O custo é dobrar as chamadas. A alternativa mais agressiva dos autores é sortear a posição, que, segundo eles, só funciona em grande escala e com as expectativas certas.
Usar um juiz de outra família
Para a autopreferência, a recomendação comum é não usar como juiz o mesmo modelo que gerou a resposta. Como visto, a evidência do MT-Bench é inconclusiva, então trate isso como higiene de baixo custo e não como correção comprovada.
Passar a referência quando existe resposta certa
Em 10 perguntas de matemática, com um par de modelos nas duas ordens (20 julgamentos), o GPT-4 aprovou uma resposta errada em 14 de 20 com o prompt padrão, 6 de 20 com cadeia de raciocínio e 3 de 20 com uma resposta de referência no prompt. Amostra pequena, mas a direção é clara: se existe gabarito, passe-o ao juiz, ou nem use juiz, como discutido no post anterior.
Combinar vários juízes e revisar a divergência
Uma síntese sobre avaliação de agentes propõe juízes de famílias diferentes, mediana das notas e a divergência como sinal. Combinando com a ideia do juiz de outra família, dá para filtrar o juiz que gerou a resposta:
type ScoreJudge = {
  family: string;
  score: (question: string, answer: string) => Promise<number>;
};

async function ensemble(
  judges: ScoreJudge[],
  generatorFamily: string,
  question: string,
  answer: string,
  maxSpread = 2
) {
  const eligible = judges.filter(j => j.family !== generatorFamily);
  if (eligible.length === 0) throw new Error("nenhum juiz de outra família");
  const scores = (await Promise.all(eligible.map(j => j.score(question, answer)))).sort(
    (a, b) => a - b
  );
  const mid = Math.floor(scores.length / 2);
  const median = scores.length % 2 ? scores[mid] : (scores[mid - 1] + scores[mid]) / 2;
  const spread = scores[scores.length - 1] - scores[0];
  return { median, spread, needsHuman: spread >= maxSpread };
}
O maxSpread é um parâmetro seu, calibrado com dados. No estudo de posição, mais da metade das instâncias do MT-Bench foi fácil, com mais de 80% dos 15 juízes de acordo, e menos de 2% foram difíceis a ponto de a maioria dos juízes não chegar a consenso. Isso sugere que a divergência concentra a revisão humana em poucos casos, mas o percentual vale para aquele benchmark, não para o seu.
Calibrar com um conjunto que tenha pares difíceis
Por fim, meça o acordo do juiz contra rótulos humanos, como no post sobre escolher o grader. O acréscimo deste post é estratificar: reporte concordância e consistência de posição separadas por pares fáceis e pares próximos, porque os resultados de posição dependem da diferença de qualidade. Um conjunto só de pares fáceis dá concordância alta e nenhuma informação sobre o viés. E, como o juiz muda com a versão do modelo, rode o harness de novo a cada troca, com o conjunto congelado.
Quando isso não vale a pena?
Se o seu critério é verificável por código, o juiz e todo esse aparato são desnecessários. Se você usa nota absoluta por rubrica em vez de comparação em pares, o viés de posição some, mas a verbosidade e a calibração da escala continuam. Se o juiz decide pouca coisa e um humano revisa tudo, medir a invariância é custo sem retorno.
E atenção aos números: os do GPT-4 são de 2023, e os de 2024 vêm de uma geração de modelos que já mudou. Por isso, meça o seu juiz no seu domínio e com as suas respostas, em vez de herdar a taxa de concordância de um paper.
Esse tipo de medição, com harness, conjunto calibrado e regras de decisão, é parte do que praticamos na Formação em Inteligência Artificial.
Referências
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial22 nov 2026 7 min
Git worktree para agentes em paralelo, sem colisão
Como usar git worktree para rodar agentes de código em paralelo sem colisão: comandos reais, best-of-N e as pegadinhas de porta, node_modules, .env e banco.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.

