Held-out vira treino: overfitting ao iterar prompts
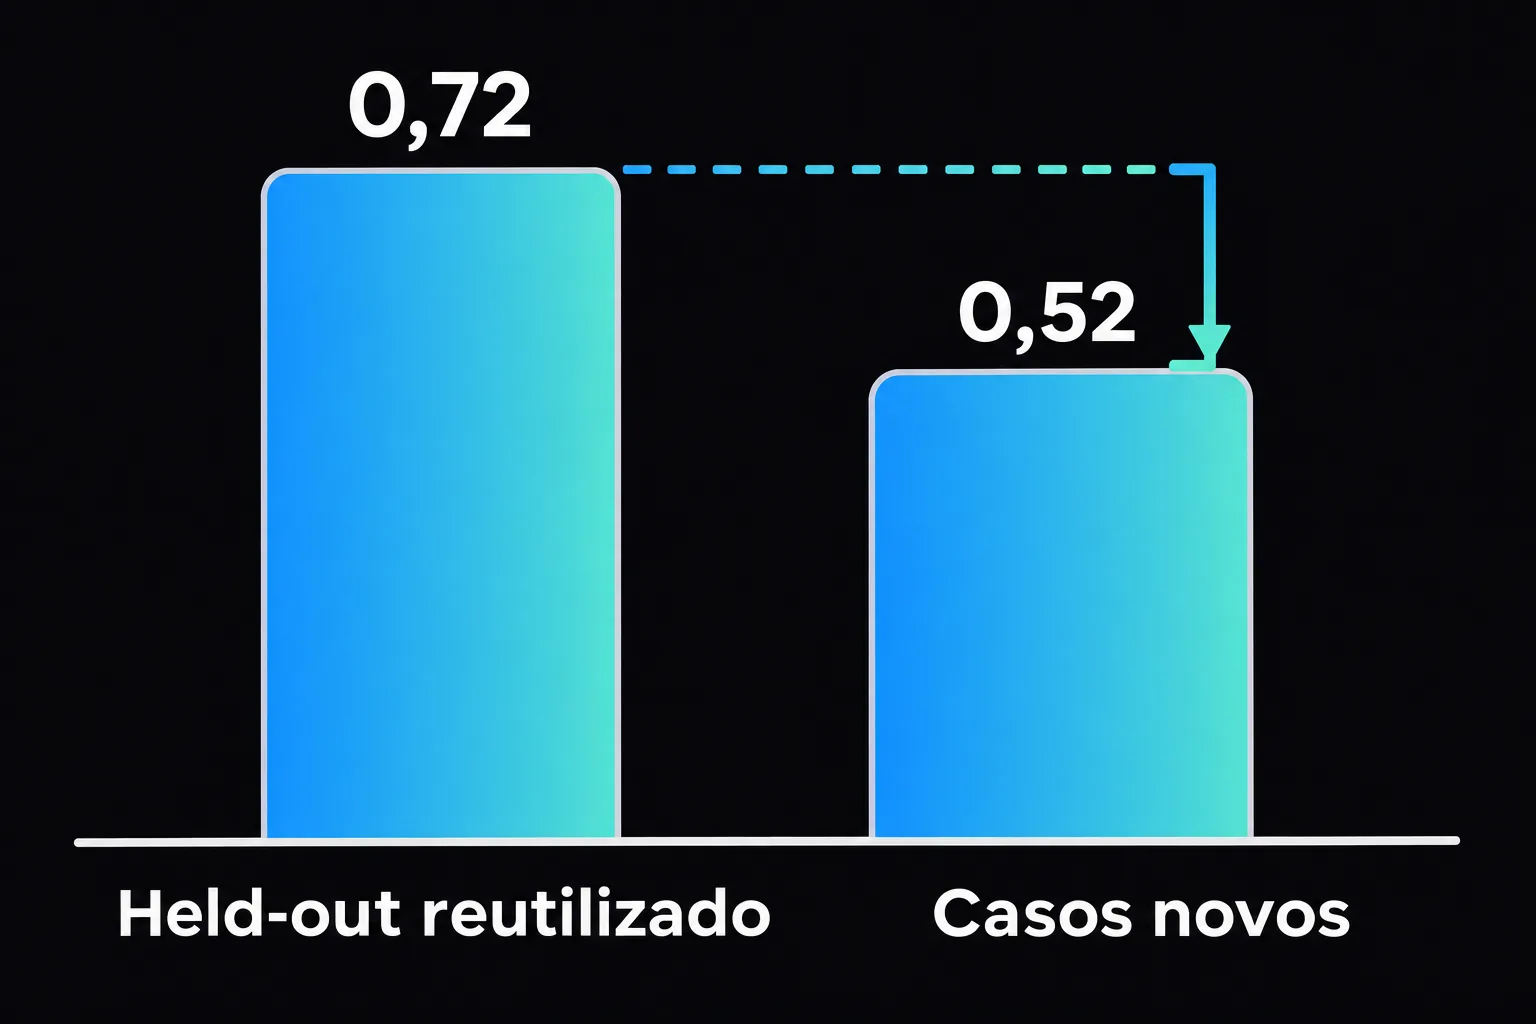
Você separou 200 casos, rodou o prompt, olhou as falhas, ajustou a instrução e rodou de novo. Na quinta rodada o held-out marcava 0,72, e a nota parecia a prova de que o prompt melhorou. O problema é que esses 200 casos deixaram de ser um teste na primeira vez que uma falha deles decidiu o que você iria mudar.
O que é overfitting adaptativo?
Overfitting costuma ser explicado com um modelo que decora o conjunto de treino. No ciclo de prompts não existe treino no sentido clássico, mas o mecanismo é o mesmo, e a causa está em quem toma as decisões: você. Cada vez que olha o resultado do held-out e escolhe a próxima alteração com base nele, a informação daqueles casos entra no prompt, mesmo sem nenhum exemplo ter sido copiado para ele.
O artigo "Generalization in Adaptive Data Analysis and Holdout Reuse", de Cynthia Dwork, Vitaly Feldman, Moritz Hardt, Toniann Pitassi, Omer Reingold e Aaron Roth, publicado no arXiv em 2015, trata exatamente disso. O resumo abre dizendo que overfitting é o grande problema de quem analisa dados, mesmo quando os dados são abundantes. Em seguida descreve a prática de análise como um processo interativo e adaptativo: novas análises e hipóteses são propostas depois de ver os resultados das anteriores, parâmetros são ajustados com base no que se obteve e conjuntos de dados são compartilhados e reutilizados. Os autores afirmam que reutilizar um conjunto de teste de forma adaptativa, várias vezes, pode facilmente levar a overfitting ao próprio conjunto de teste.
Isso contraria a intuição de que "mais casos resolvem". A estatística clássica garante que a nota de um conjunto de teste estima bem o desempenho real se a hipótese foi escolhida antes de ver o conjunto. Quando a escolha depende do resultado anterior, essa garantia deixa de valer, e aumentar a amostra não a devolve por si só.
Como a nota do held-out sobe sem o prompt melhorar?
Dá para ver o efeito sem nenhum modelo de linguagem. A simulação abaixo foi escrita para este post. Ela cria 200 casos de desenvolvimento e 200 casos novos, e cada resposta do sistema começa certa ou errada por sorteio, ou seja, com acerto esperado de 50%. Cada "ajuste de prompt" não tem efeito real: ele só inverte o acerto de cerca de 10% dos casos, de forma arbitrária. A regra do loop é a que muita gente segue na prática: se o ajuste melhora a nota do held-out, fica; senão, descarta.
// Cada "ajuste de prompt" não tem efeito real: vira ou não a correção de cada caso por acaso.
function hash(a: number, b: number): number {
  let h = (a * 374761393 + b * 668265263) | 0;
  h = Math.imul(h ^ (h >>> 13), 1274126177);
  return (h ^ (h >>> 16)) >>> 0;
}

const N = 200;
const flips = (tweak: number, caseId: number) => hash(tweak, caseId) % 100 < 10;

function simulate(seed: number, tweaks: number) {
  const base = (id: number) => hash(seed, id + 1_000_000) % 2 === 0;
  const accepted: number[] = [];
  const correct = (id: number) => accepted.reduce((ok, t) => (flips(t, id) ? !ok : ok), base(id));
  const score = (ids: number[]) => ids.filter(correct).length / ids.length;

  const dev = Array.from({ length: N }, (_, i) => i);
  const fresh = Array.from({ length: N }, (_, i) => N + i);

  for (let t = 0; t < tweaks; t++) {
    const before = score(dev);
    accepted.push(t);
    if (score(dev) <= before) accepted.pop(); // só mantém o ajuste que melhora o held-out
  }
  return { held: score(dev), fresh: score(fresh), kept: accepted.length };
}

const runs = Array.from({ length: 20 }, (_, seed) => simulate(seed, 300));
const mean = (xs: number[]) => xs.reduce((a, b) => a + b, 0) / xs.length;
console.log("held-out reutilizado:", mean(runs.map(r => r.held)).toFixed(2));
console.log("casos novos:", mean(runs.map(r => r.fresh)).toFixed(2));
console.log("ajustes mantidos:", mean(runs.map(r => r.kept)).toFixed(0));
A simulação faz 300 tentativas de ajuste e repete o processo com 20 sementes diferentes. Em média, o held-out reutilizado foi de cerca de 0,50 para 0,72, com 16 ajustes mantidos por execução, enquanto os 200 casos novos ficaram em 0,52. Nenhum dos ajustes tinha efeito real, então toda a diferença entre 0,72 e 0,52 é seleção: o loop guardou as alterações que, por acaso, acertaram os casos que ele podia ver.
Num prompt de verdade o ajuste não é aleatório, e parte da melhora é genuína. A conta mostra que a nota do held-out reutilizado mistura as duas coisas, e nada nela diz qual parte é qual.
O que aconteceu num revisor de código com LLM?
Um experimento interno com um revisor de código baseado em LLM mostra o mesmo padrão fora da simulação. O revisor fazia uma série de perguntas sobre cada arquivo e apontava os trechos com problema. O conjunto de desenvolvimento tinha 40 arquivos com 26 defeitos esperados, e o catálogo de perguntas foi reescrito em várias rodadas olhando as falhas desses mesmos casos, com contra-exemplos e uma opção de resposta a mais para separar o risco teórico do defeito presente. Entre reescritas e ajustes de limiar, os falsos positivos caíram de 98 para 1, e a versão final chegou a 0,96 de precisão e 0,96 de recall nesse conjunto.
Em 130 arquivos reais que não tinham sido usados na calibração, a precisão estrita, com cada apontamento classificado à mão, ficou em 0,40 (20 apontamentos distintos). Seis critérios foram reescritos a partir desses apontamentos, e a nova rodada nos mesmos arquivos marcou 0,46 (13 apontamentos), o que já transforma esses 130 arquivos em dado de desenvolvimento. Por fim, em 60 commits reais de correção (fix), as linhas que o revisor apontava coincidiram com as linhas depois consertadas na mesma taxa que um sorteio de linhas. Os números vêm dos relatórios do experimento, que não são públicos.
Duas ressalvas para ler isso direito. A primeira é que a queda tem mais de uma causa: o conjunto de desenvolvimento era pequeno e os arquivos reais vêm de outra distribuição; nos commits de correção, os bugs eram invariantes de comportamento entre arquivos, que nenhuma pergunta do catálogo, feita arquivo a arquivo, descrevia. A segunda é que um experimento assim não isola o efeito adaptativo. Ele ilustra o ponto central: o 0,96 media a capacidade de passar nos casos que moldaram o catálogo, e quem lê só essa nota espera um comportamento que não se repete em dado novo.
Como evitar o problema ao iterar prompts?
A saída prática é separar os papéis dos conjuntos e tratar cada um deles conforme o que já viu.
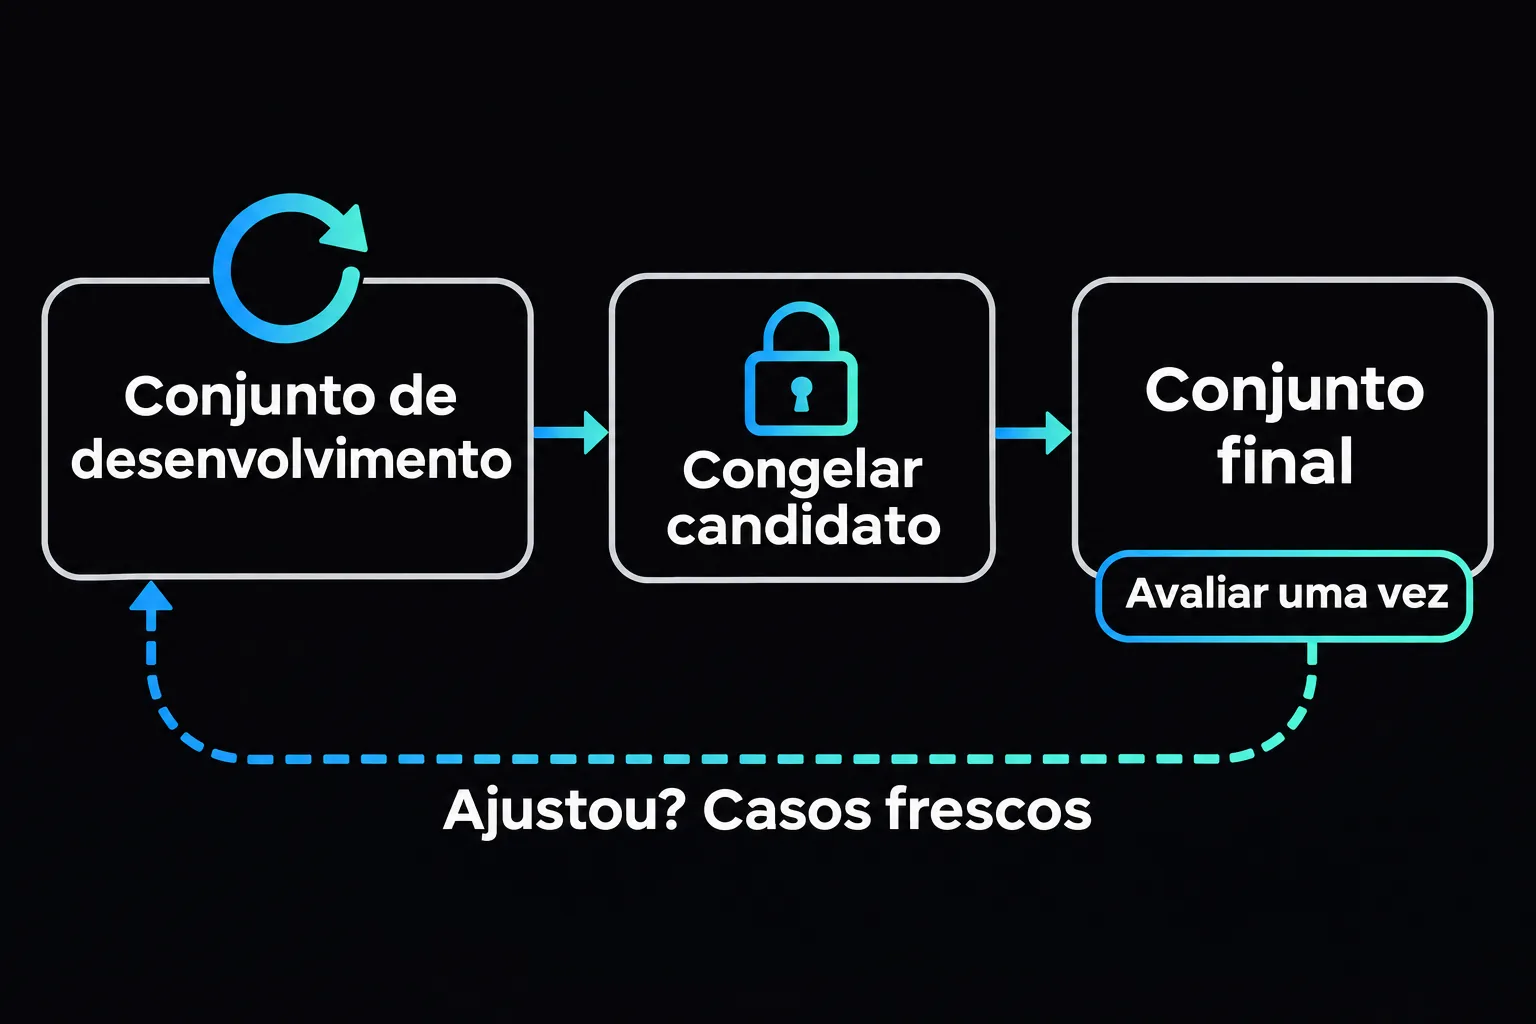
- O conjunto de desenvolvimento pode ser consultado quantas vezes você quiser. É nele que você lê falhas, escreve contra-exemplos e ajusta perguntas.
- Quando a versão parece boa, congele o candidato: fixe o prompt, as perguntas, o modelo, os parâmetros e a política de decisão. Qualquer mudança depois disso gera um novo candidato.
- O conjunto final tem casos que ninguém inspecionou, avaliados uma vez contra o candidato congelado. O resultado entra no relatório com o tamanho da amostra.
- Se uma falha do conjunto final levar a qualquer ajuste, os casos dela passam a ser de desenvolvimento, e a próxima avaliação final precisa de casos frescos.
Isso vale também para os ajustes que parecem inocentes: trocar o modelo, o provedor, o idioma do prompt, o texto de uma pergunta ou a lista de candidatos. Se mudou, o candidato é outro, e a nota antiga não se transfere.
É possível ajudar a disciplina com código. O exemplo abaixo, também escrito para este post, amarra o conjunto final ao candidato congelado e impede uma segunda consulta.
type Case = { id: string; input: string; expected: string };

class FrozenHoldout {
  private used = false;
  constructor(
    readonly cases: readonly Case[],
    readonly candidateHash: string
  ) {}

  evaluate(candidateHash: string, run: (c: Case) => boolean): { score: number; n: number } {
    if (candidateHash !== this.candidateHash) {
      throw new Error("o candidato mudou depois de congelado");
    }
    if (this.used) {
      throw new Error("este held-out já foi consultado; reserve casos novos");
    }
    this.used = true;
    const hits = this.cases.filter(run).length;
    return { score: hits / this.cases.length, n: this.cases.length };
  }
}
O código não impede ninguém de ler os casos e ajustar o prompt por fora, e nenhuma classe consegue impedir isso. O que ele faz é deixar o custo visível: para repetir a avaliação, alguém precisa criar um novo conjunto, e essa fricção é o que lembra de reservar casos frescos.
Quando essa disciplina compensa e quando é exagero?
O rigor tem custo, porque casos frescos precisam de rótulos, e rotular dá trabalho. Alguns critérios ajudam a calibrar.
- Compensa quando a nota vai justificar uma decisão, como ligar o sistema em produção, comparar dois modelos ou comunicar uma métrica a quem não vê os casos. Nesses cenários, um 0,72 inflado leva a uma decisão errada.
- Compensa menos em exploração inicial, quando você ainda procura o que perguntar. Ali o conjunto de desenvolvimento cumpre o seu papel, desde que ninguém apresente a nota como medida final.
- Não resolve sozinha o caso em que o conjunto, mesmo intocado, não representa o uso real. Um held-out limpo com arquivos que não têm os bugs de produção continua enganando, só que de outro jeito. Por isso vale comparar o candidato congelado com o comportamento observado em tráfego real, por exemplo rodando-o em modo sombra ao lado do sistema atual.
Os próprios autores do artigo mostram que há saída técnica para reutilizar um conjunto de teste: o resumo descreve um algoritmo que permite validar um grande número de hipóteses escolhidas adaptativamente evitando overfitting de forma comprovada. Esse caminho muda a forma de consultar o conjunto, e não substitui a regra simples de tratar como desenvolvimento tudo o que já guiou uma decisão.
O que levar para o seu fluxo de avaliação?
Na prática, conte quantas decisões já foram tomadas olhando cada conjunto. Se o held-out guiou três ajustes, ele já não é mais independente, e a nota dele é uma estimativa otimista. Congele o candidato, reserve casos que ninguém viu e registre o tamanho da amostra junto com a nota.
Se a sua dúvida for quais medidas usar depois do congelamento, o post sobre avaliar um agente com task, trial e grader organiza o vocabulário, e o de LLM-as-judge ou teste determinístico ajuda a escolher o grader. A mesma lógica de confiar só no que foi verificado antes de mudar o código aparece em por que os testes automatizados são tão importantes. Se você quer praticar esse ciclo de avaliação com projetos guiados, a Formação em Inteligência Artificial trabalha o tema.
Referências
- Dwork, C.; Feldman, V.; Hardt, M.; Pitassi, T.; Reingold, O.; Roth, A. "Generalization in Adaptive Data Analysis and Holdout Reuse". arXiv:1506.02629, 2015. https://arxiv.org/abs/1506.02629
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial22 nov 2026 7 min
Git worktree para agentes em paralelo, sem colisão
Como usar git worktree para rodar agentes de código em paralelo sem colisão: comandos reais, best-of-N e as pegadinhas de porta, node_modules, .env e banco.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.

