Memória de agente: como tratar fatos que mudam
Um dos jeitos mais difíceis de notar numa falha da memória de agente é lembrar do fato e devolver a versão antiga. O usuário disse em janeiro que trabalhava na Acme, disse em março que mudou para outra empresa, e meses depois o agente responde com a Acme com toda a confiança. Nenhuma das duas informações foi perdida. O que faltou foi dizer qual delas ainda vale.
Abaixo, os números do benchmark LongMemEval, o que o paper propõe para melhorar e uma estrutura pequena em TypeScript para guardar fatos que mudam sem apagar o histórico.
O que o LongMemEval mede?
O LongMemEval, publicado no ICLR 2025, tem 500 perguntas escondidas dentro de históricos de conversa entre usuário e assistente. Ele testa cinco habilidades: extração de informação, raciocínio entre sessões, raciocínio temporal, atualização de conhecimento e abstenção, quando o assistente deve admitir que não sabe. Na versão chamada S, o histórico tem cerca de 115 mil tokens, algo perto de 50 sessões. Existe também uma versão M, com histórico bem maior.
O resultado que ficou famoso é a queda de cerca de 30% de acurácia. Vale ver de onde ela vem, porque o resumo esconde duas medições diferentes. Segundo o paper (Wu et al., 2024), o GPT-4o respondendo com só as sessões que continham a evidência acertou 87,0%, e com o histórico completo da versão S caiu para 60,6%, uma perda de 30,3%. Os outros modelos testados perderam entre 36% e 66%, dependendo do modelo e de usar ou não Chain-of-Note.
A segunda medição é de sistemas comerciais. Anotadores humanos conversaram com o ChatGPT e o Coze, sessão por sessão, em históricos de 3 a 6 sessões, cerca de dez vezes mais curtos que a versão S, usando 97 perguntas. Com o GPT-4o, o ChatGPT teve queda de 37% e o Coze de 64% em relação a ler o histórico inteiro. Esses testes são de agosto de 2024, então trate esses números como retrato daquele momento e não como ranking atual. O que dura é a observação qualitativa dos autores: o ChatGPT tendia a sobrescrever informação importante conforme a conversa avançava, e o Coze muitas vezes não registrava o que o usuário dizia de forma indireta.
Por que a memória de agente erra e o fato antigo vence?
O LongMemEval mede quedas, mas não atribui a elas uma causa única nem mede quanto cada uma pesa. A divisão em três causas abaixo é uma interpretação deste texto, montada sobre três achados diferentes do paper. Em cada uma, o que é achado e o que é interpretação está separado.
A primeira é volume. O achado: os modelos de contexto longo perderam de 30% a 66% de acurácia ao trocar só as sessões com a evidência pelo histórico completo, e a resposta continuava no histórico. Como a única diferença entre os dois cenários é o material irrelevante ao redor, ler isso como efeito de volume é uma interpretação direta. É o mesmo efeito discutido em context rot e em o que ocupa a janela de contexto.
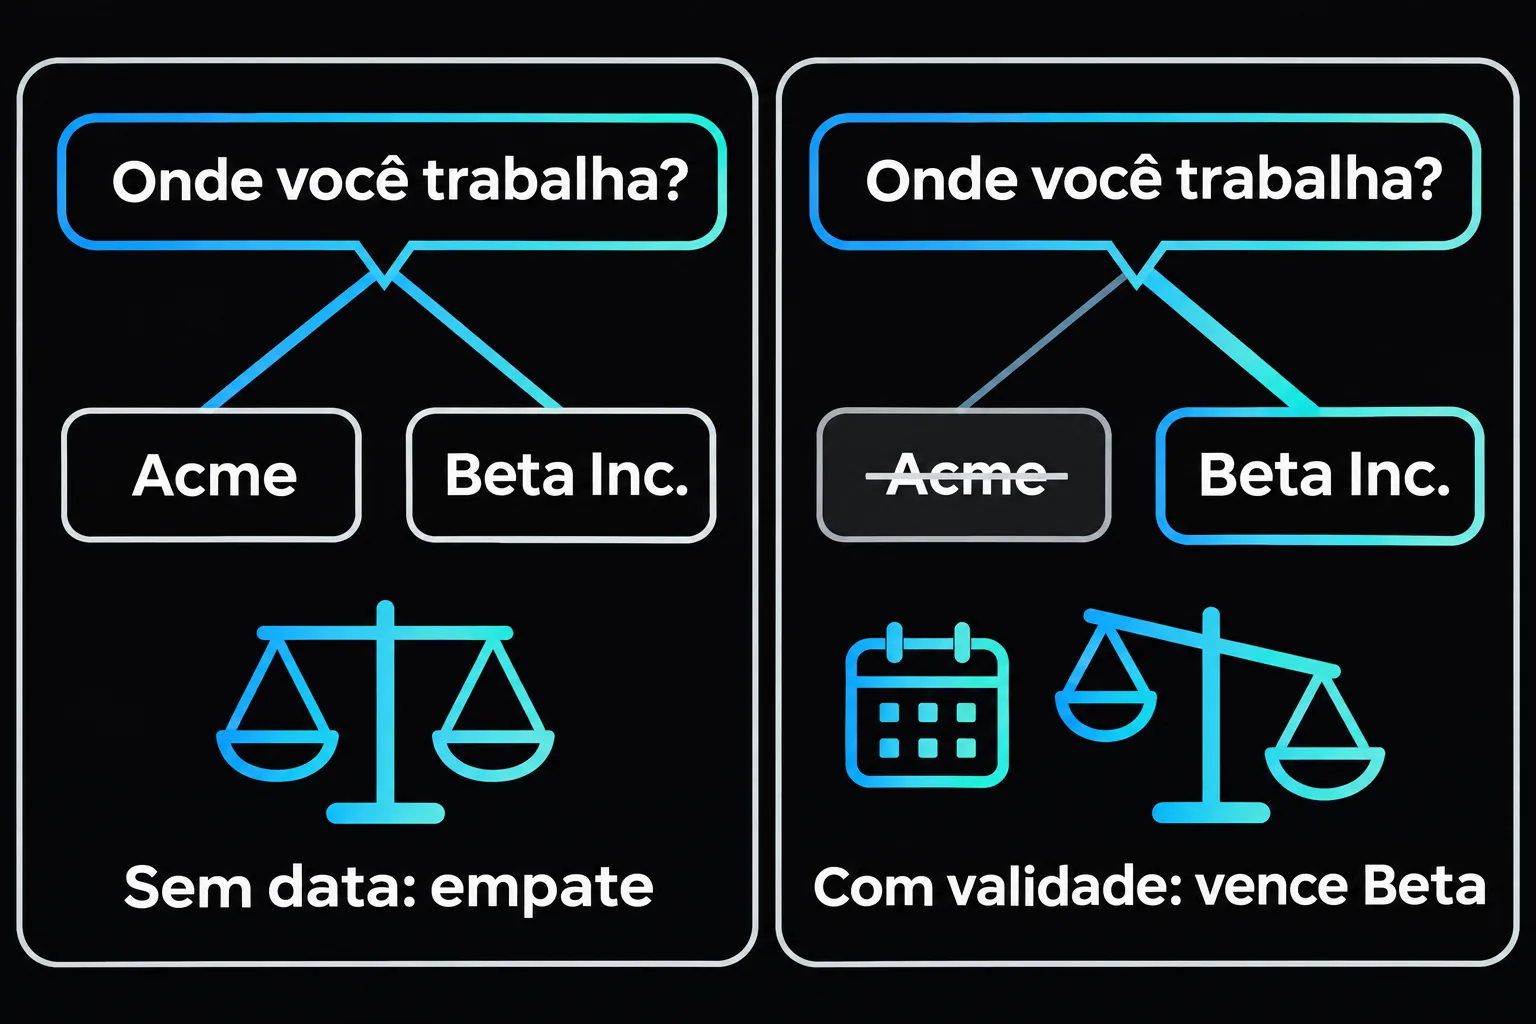
A segunda é tempo, e é ela que explica o fato antigo vencendo. O achado: os autores relatam que desenhos de memória que ignoram o tempo vão mal nas perguntas de raciocínio temporal. O mecanismo a seguir é interpretação deste texto. Uma busca por similaridade pergunta "qual texto parece mais com a pergunta?", e a frase "trabalho na Acme" é tão parecida com "onde você trabalha?" quanto a frase mais nova. Quem decide qual vale é a data, e a similaridade não enxerga data.
Quem mostra esse mecanismo num caso concreto é outro paper, o do Synapse, sobre o LoCoMo, outro benchmark de memória conversacional. Na busca só semântica do A-Mem, sistema usado como comparação, o trecho "mudou da Suécia há 4 anos" teve similaridade de 0,92 com a pergunta sobre onde a personagem mora, venceu a busca, e a resposta foi "mora na Suécia". Com o decaimento temporal do Synapse, o peso desse trecho caiu e o que dizia que ela mora nos EUA subiu.
A terceira é agregação. O achado: no teste com ChatGPT e Coze, os dois sistemas foram razoáveis em perguntas de uma sessão só e caíram bastante nos tipos que exigem juntar informação de várias sessões. O paper também mostra que trocar as sessões por fatos de usuário extraídos piora o resultado geral por perda de informação, mas melhora o raciocínio entre sessões. Isso combina com o que ele vê na chave de busca, logo adiante, onde o fato funciona melhor junto do texto original do que no lugar dele.
O que o paper propõe para melhorar?
Os autores organizam a memória em três estágios, indexação, recuperação e leitura, e testam uma otimização em cada um.
No índice, a unidade de armazenamento. Guardar a rodada (uma mensagem do usuário e a resposta do assistente) funcionou melhor que guardar a sessão inteira com o GPT-4o como leitor. Com o Llama 3.1 8B, as duas opções ficaram parecidas.
Na chave de busca, a expansão com fatos. Em vez de indexar só o texto da rodada, concatena-se a ele os fatos extraídos, e a busca usa as duas coisas. Segundo o paper, isso trouxe 9,4% a mais de recall@k e 5,4% a mais de acurácia nas respostas. Usar só o fato como chave não melhorou o recall.
Na consulta, a expansão temporal. Os valores são indexados também pela data dos eventos, e um LLM extrai da pergunta uma janela de tempo que filtra os candidatos. O recall nas perguntas temporais subiu em média 11,3% com rodadas e 6,8% com sessões, desde que o modelo que extrai a janela seja forte. Com o Llama 8B, os autores observaram datas alucinadas ou pistas temporais perdidas.
Um quarto achado vale para a leitura: mesmo com a recuperação perfeita, a estratégia de leitura pode custar até 10 pontos absolutos de acurácia no GPT-4o. O paper comparou memórias em JSON ou em texto corrido, com ou sem Chain-of-Note (pedir ao modelo que anote cada memória antes de responder), e a combinação de JSON com Chain-of-Note foi a melhor.
O filtro temporal da consulta cabe em poucas linhas:
type Chunk = { text: string; eventDate: Date; embedding: number[] };
type TimeRange = { from: Date; to: Date };

declare function similarity(a: number[], b: number[]): number;

function retrieve(query: number[], chunks: Chunk[], range: TimeRange | null, k: number): Chunk[] {
  const pool = range
    ? chunks.filter(c => c.eventDate >= range.from && c.eventDate <= range.to)
    : chunks;
  return pool
    .map(c => ({ c, score: similarity(query, c.embedding) }))
    .sort((a, b) => b.score - a.score)
    .slice(0, k)
    .map(x => x.c);
}
Repare que o filtro roda antes do ranking. O candidato fora da janela nem chega a competir por similaridade.
Como guardar fatos que mudam sem apagar?
As otimizações do LongMemEval melhoram a busca, mas nenhuma delas decide entre dois valores do mesmo atributo. Quando a empresa do usuário aparece como Acme e como Beta Inc., quem escolhe a atual? Sobrescrever também tem custo, e o próprio paper mostra: o ChatGPT gravava o fato logo depois de ouvi-lo, mas alterava a informação ao comprimir o histórico e acabava perdendo dado. Uma saída usada em produtos de memória temporal é registrar uma janela de validade por fato. A Zep descreve o motor de memória dela, o Graphiti, nesses termos: cada fato tem um período de validade, e o fato antigo fica marcado como substituído em vez de apagado. É uma descrição de produto, sem números medidos, então use como padrão de projeto e não como evidência de ganho.
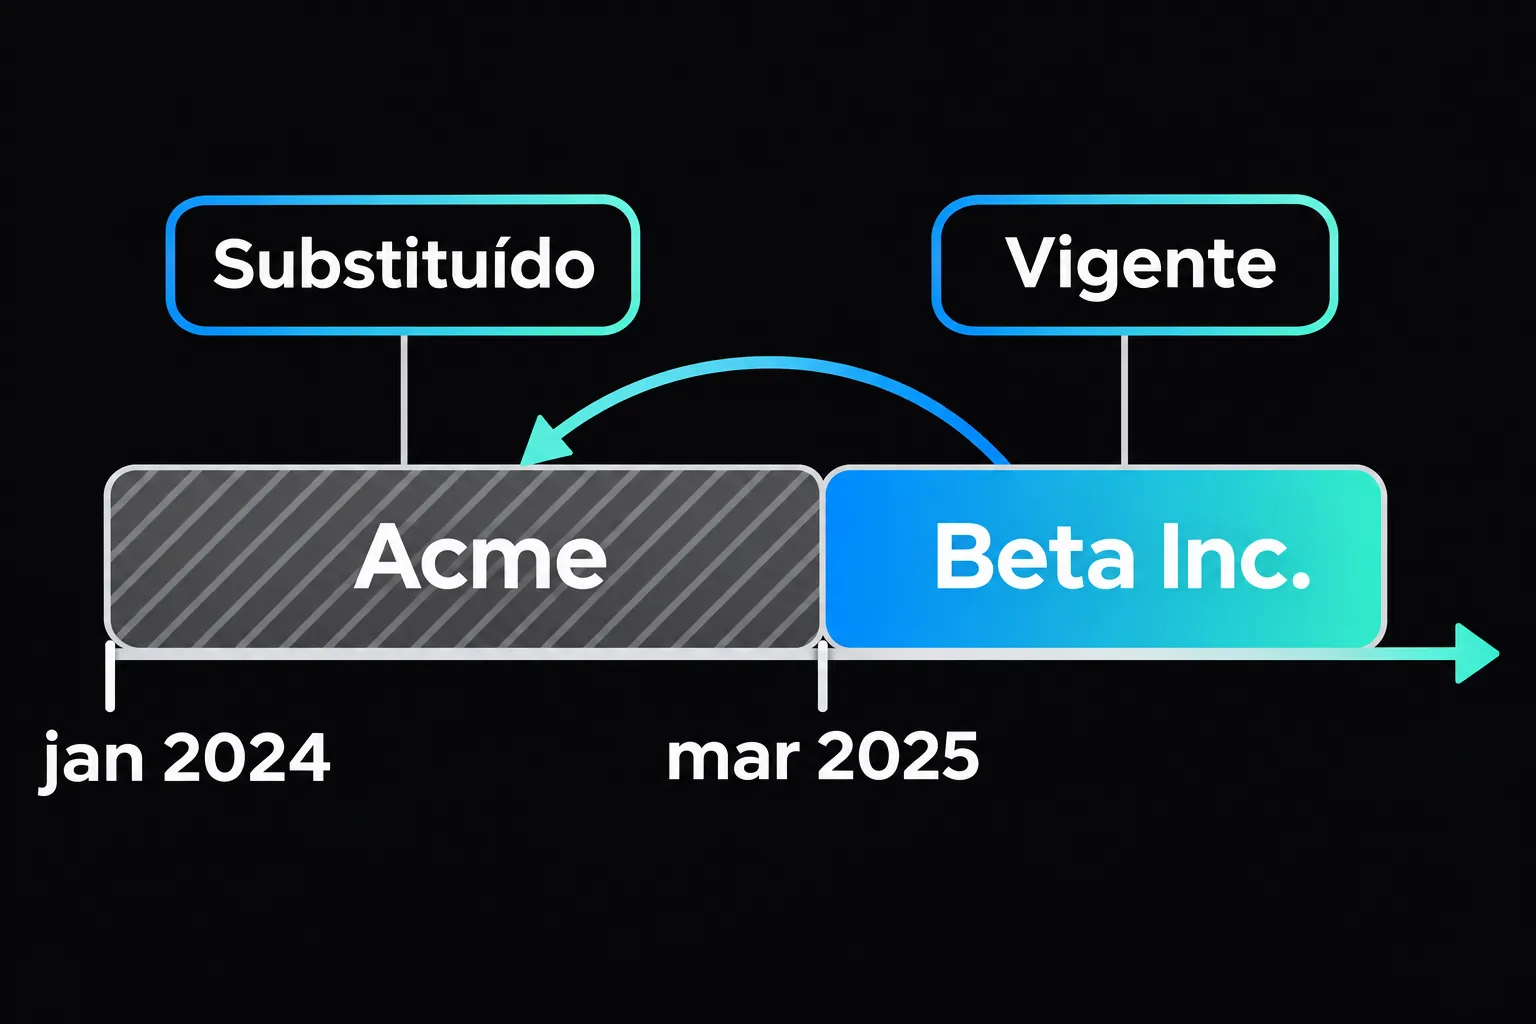
Uma implementação mínima separa dois tempos: quando o fato passou a valer no mundo e quando o agente ficou sabendo. O fim da validade não é gravado. Ele é derivado do próximo fato do mesmo atributo, o que dá ordem correta até quando a correção chega atrasada.
type Fact = {
  subject: string;
  attribute: string;
  value: string;
  validFrom: Date; // quando passou a ser verdade no mundo
  recordedAt: Date; // quando o agente ficou sabendo
  source: string; // sessão ou mensagem de origem
};

type Interval = Fact & { validTo: Date | null };

class FactStore {
  private facts: Fact[] = [];

  assert(fact: Fact): "added" | "noop" {
    const current = this.at(fact.subject, fact.attribute, fact.validFrom);
    if (current?.value === fact.value) return "noop";
    this.facts.push(fact);
    return "added";
  }

  history(subject: string, attribute: string): Interval[] {
    const sorted = this.facts
      .filter(f => f.subject === subject && f.attribute === attribute)
      .sort((a, b) => a.validFrom.getTime() - b.validFrom.getTime());
    return sorted.map((f, i) => ({ ...f, validTo: sorted[i + 1]?.validFrom ?? null }));
  }

  at(subject: string, attribute: string, when: Date): Interval | undefined {
    return this.history(subject, attribute).find(
      h => h.validFrom <= when && (h.validTo === null || when < h.validTo)
    );
  }
}

const day = (d: Date) => d.toISOString().slice(0, 10);

function renderForPrompt(history: Interval[]): string {
  const current = history.find(h => h.validTo === null);
  if (!current) return "";
  const past = history
    .filter(h => h !== current)
    .map(h => `${h.value} (${day(h.validFrom)} a ${day(h.validTo as Date)})`);
  const head = `Atual: ${current.value}, desde ${day(current.validFrom)}.`;
  return past.length ? `${head} Substitui: ${past.join("; ")}.` : head;
}
Para usar, o agente registra os fatos e injeta no prompt o histórico já resolvido:
const store = new FactStore();
store.assert({
  subject: "user",
  attribute: "empresa",
  value: "Acme",
  validFrom: new Date("2024-01-10"),
  recordedAt: new Date("2024-01-10"),
  source: "sessao-3",
});
store.assert({
  subject: "user",
  attribute: "empresa",
  value: "Beta Inc.",
  validFrom: new Date("2025-03-01"),
  recordedAt: new Date("2025-03-04"),
  source: "sessao-41",
});
console.log(renderForPrompt(store.history("user", "empresa")));
A saída é Atual: Beta Inc., desde 2025-03-01. Substitui: Acme (2024-01-10 a 2025-03-01). O modelo recebe o fato vigente e o marcador explícito de que ele substitui o anterior, sem precisar adivinhar pela ordem das mensagens.
A ideia é tirar do modelo uma decisão que dá para tomar em código. Se o prompt traz dois fatos conflitantes sem data, o modelo precisa adivinhar qual vale pela ordem ou pelo tom das mensagens. Com o histórico já resolvido, ele só lê.
O assert retorna noop quando o valor já vale na data informada. Isso evita que a mesma frase dita em dez sessões vire dez registros, e deixa o histórico com uma linha por mudança real.
Decay ou supersede?
Dá para atacar o mesmo problema por outro lado: em vez de marcar o fato como substituído, reduzir o peso das memórias antigas conforme o tempo passa. É o que o Synapse faz. Na ablação do próprio artigo, no LoCoMo com GPT-4o-mini, desligar o decaimento dos nós derrubou o F1 de raciocínio temporal de 50,1 para 14,2, enquanto as outras categorias quase não se mexeram. É um número dos próprios autores do método, em um benchmark só, sem reprodução independente nas fontes deste texto. Na mesma tabela, a versão só com vetores marcou 14,7 nessa categoria, praticamente o mesmo valor do Synapse sem decaimento.
No exemplo do próprio Synapse, o decaimento resolveu uma mudança de país, então ele dá conta de muita mudança de estado na prática. O que ele não guarda é a fronteira. O peso diz que o trecho é velho, mas não diz que ele foi substituído nem quando deixou de valer, e um peso que decai devagar ainda deixa a Acme competir com a Beta. Para perguntar o que valia em março de 2024, ou para auditar por que o agente respondeu Beta, a janela de validade é explícita e o peso é uma estimativa. A divisão que este texto recomenda, sem resultado medido por trás: supersede com janela de validade para estado discreto, como emprego ou cidade, e decay para relevância que esmaece, como o assunto da semana. Muitos sistemas vão precisar dos dois.
Quando isso não compensa?
Fatos extraídos vêm de um modelo, e o modelo erra. Um fato mal extraído com validade bem registrada continua errado, só que agora com cara de verdade auditada. Guarde sempre a origem (o campo source do exemplo) para poder voltar ao texto da conversa.
O esquema também pede um vocabulário de atributos. empresa e trabalha_em precisam cair na mesma chave, senão o supersede nunca dispara. Para históricos curtos, de poucas sessões, colocar tudo no contexto e deixar o modelo ler costuma ser mais simples. No teste do paper com históricos curtos, o GPT-4o lendo o histórico inteiro acertou 91,8%, contra 57,7% do ChatGPT com a memória dele, os dois com o GPT-4o. A estrutura começa a valer quando o histórico passa do que cabe com folga na janela e quando a mesma informação muda ao longo do tempo.
Nos dois papers, boa parte do ganho veio de decisões de indexação, filtro e tempo, que ficam no seu código. Se esse tipo de projeto de agente com memória, avaliação e contexto faz parte do que você quer construir, a Formação em Inteligência Artificial trabalha esses temas em sequência.
Referências
- Wu, D. et al. LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. ICLR 2025. https://arxiv.org/abs/2410.10813
- Jiang, H. et al. Synapse: Empowering LLM Agents with Episodic-Semantic Memory via Spreading Activation. https://arxiv.org/html/2601.02744v3
- Zep: Temporal Knowledge Graph Memory for Production AI Agents (site do produto). https://www.getzep.com/
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial22 nov 2026 7 min
Git worktree para agentes em paralelo, sem colisão
Como usar git worktree para rodar agentes de código em paralelo sem colisão: comandos reais, best-of-N e as pegadinhas de porta, node_modules, .env e banco.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.

