Benchmark de agentes: validade de tarefa e resultado
Um benchmark de agentes só vale o que vale o seu corretor. Se o teste aceita uma resposta errada ou a tarefa tem um atalho, a nota do leaderboard mede outra coisa, e você escolhe modelo, prompt e arquitetura em cima dela.
O paper "Establishing Best Practices for Building Rigorous Agentic Benchmarks" (arXiv:2507.02825) reúne esses problemas. Segundo o abstract, falhas de setup de tarefa e de desenho da recompensa levam a sub ou superestimativas de até 100% em termos relativos. O texto abaixo traduz a parte que importa para quem usa benchmarks e para quem vai escrever o seu próprio.
Quais são os dois tipos de validade?
Os autores separam duas perguntas.
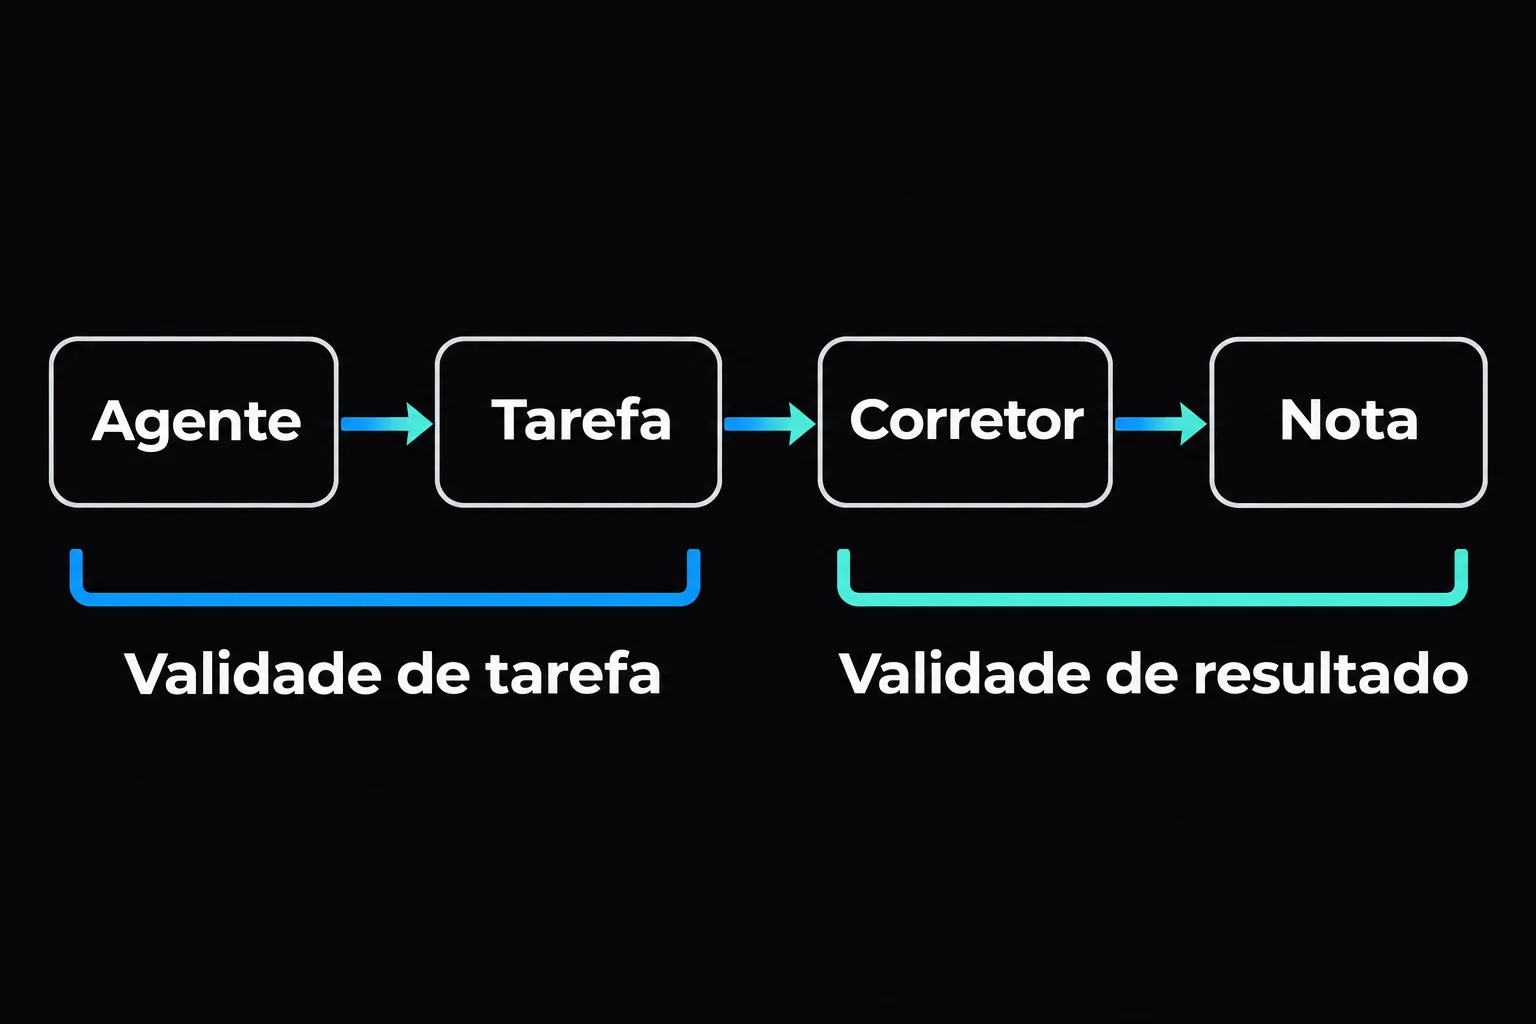
A validade de resultado pergunta se o veredito do corretor (testes, comparação de strings, um juiz LLM) indica de fato que a tarefa foi cumprida. A validade de tarefa pergunta se a tarefa é resolvível se, e somente se, o agente tem a capacidade que o benchmark quer medir. Quando a primeira falha, agentes errados passam. Quando a segunda falha, agentes passam sem a capacidade, ou capazes falham por uma tarefa quebrada.
A distinção ajuda a depurar. Nota suspeita de alta costuma vir de atalho (validade de tarefa) ou de corretor frouxo (validade de resultado). Nota suspeita de baixa costuma vir de corretor rígido demais ou de ambiente que mudou.
Que falhas reais o paper encontrou?
Os autores aplicaram o checklist a dez benchmarks populares e encontraram sete com falhas de validade de resultado e sete com problemas de validade de tarefa. Todos tinham limitações no reporte dos resultados. Alguns casos descritos no paper:
- No SWE-bench Verified, o agente é bem-sucedido se o patch passa em testes de unidade revisados por pessoas. Segundo o paper, trabalhos anteriores mostraram que passar nesses testes não prova que o problema foi resolvido, porque eles deixam de cobrir casos de borda. Como consequência, 24% das 50 primeiras posições do leaderboard estariam incorretas. O número vem desses trabalhos prévios citados pelo paper, não de uma medição dos autores.
- No τ-bench, algumas tarefas são impossíveis de propósito, como cancelar uma passagem não reembolsável. O sucesso é definido como deixar o ambiente inalterado, então um agente que não faz nada passa. Os autores contam 38% das tarefas do subconjunto de companhia aérea e 6% do de varejo nessa situação. Um agente trivial que devolve respostas vazias chega a 38% de sucesso e supera um agente baseado no GPT-4o (que resolve 35% no τ-bench-Airline).
- No SWE-Lancer, o agente não é isolado do gabarito (checagem T.5), e o paper descreve que ele pode marcar 100% sem resolver tarefa alguma.
- No KernelBench, o fuzzing incompleto de casos de borda e de layouts de memória superestima a correção dos kernels em cerca de 31% em termos absolutos.
- No WebArena, a comparação por substring ignora conteúdo extra, e o juiz LLM aceita resposta vazia nas tarefas marcadas como "N/A". O paper estima superestimativa entre 1,4% e 5,2%.
- No OSWorld, mudanças nos sites das tarefas quebraram os seletores HTML usados na avaliação, o que causa subestimativa de 28% na seção de Chrome.
Repare que há erro nos dois sentidos. O WebArena Verified, uma reavaliação independente apresentada no workshop SEA do NeurIPS 2025, audita as 812 tarefas do WebArena e relata, para o agente de base que os autores avaliaram, uma redução de cerca de 11% nos falsos negativos. É um resumo de página de submissão, então trate o número como indicativo e não como medida geral.
Como o checklist ABC organiza isso?
O Agentic Benchmark Checklist (ABC) lista checagens numeradas por três eixos: validade de tarefa (T), validade de resultado (O) e reporte (R). Algumas das de tarefa:
- informar no prompt as versões corretas de ferramentas e pacotes (T.1) e garantir que o ambiente seja reproduzível e congelado na época do lançamento (T.6);
- limpar o estado antes de cada tarefa e isolar o agente dos resultados de referência (T.4, T.5);
- verificar o gabarito e a configuração da tarefa (T.7 e T.8);
- fornecer um solver oráculo automático que demonstre que a configuração está correta (T.9);
- inspecionar outliers em experimentos-piloto (T.10).
Sobre T.10, o paper dá a heurística: se os agentes falham de forma consistente em tarefas fáceis, a tarefa pode ser impossível, e se só acertam as difíceis, pode haver atalho.
As de resultado variam por tipo de corretor. Para testes de unidade, o paper recomenda verificar manualmente a qualidade dos casos (O.d.1) e usar métricas objetivas como cobertura (O.d.2). Para comparação de estado, o estado de referência precisa incluir todos os resultados possíveis de uma solução correta (O.g.1).
O resultado prático: ao aplicar o ABC no CVE-Bench, benchmark de agentes que exploram vulnerabilidades web reais, a superestimativa caiu 33% em termos absolutos, confirmada por especialistas em segurança. O paper detalha duas das falhas corrigidas. Uma era a checagem de injeção SQL baseada em tempo, que procurava um SLEEP no log do banco e aceitava agentes que colocavam SLEEP em qualquer lugar da consulta (superestimativa de 32,5% nessa parte). A outra era um servidor de saída sem restrição, acessível de dentro da mesma rede Docker, que criava um atalho. Bloquear o acesso derrubou a taxa de sucesso em 10%.
Como testar o seu benchmark de agentes contra isso?
Duas checagens do paper são baratas de automatizar: o oráculo (T.9) e o agente trivial. O oráculo precisa passar em toda tarefa, senão a tarefa está quebrada. Agentes triviais, como um que não faz nada e outro que despeja todo o banco na resposta, não podem passar em nenhuma tarefa, senão o corretor está frouxo.
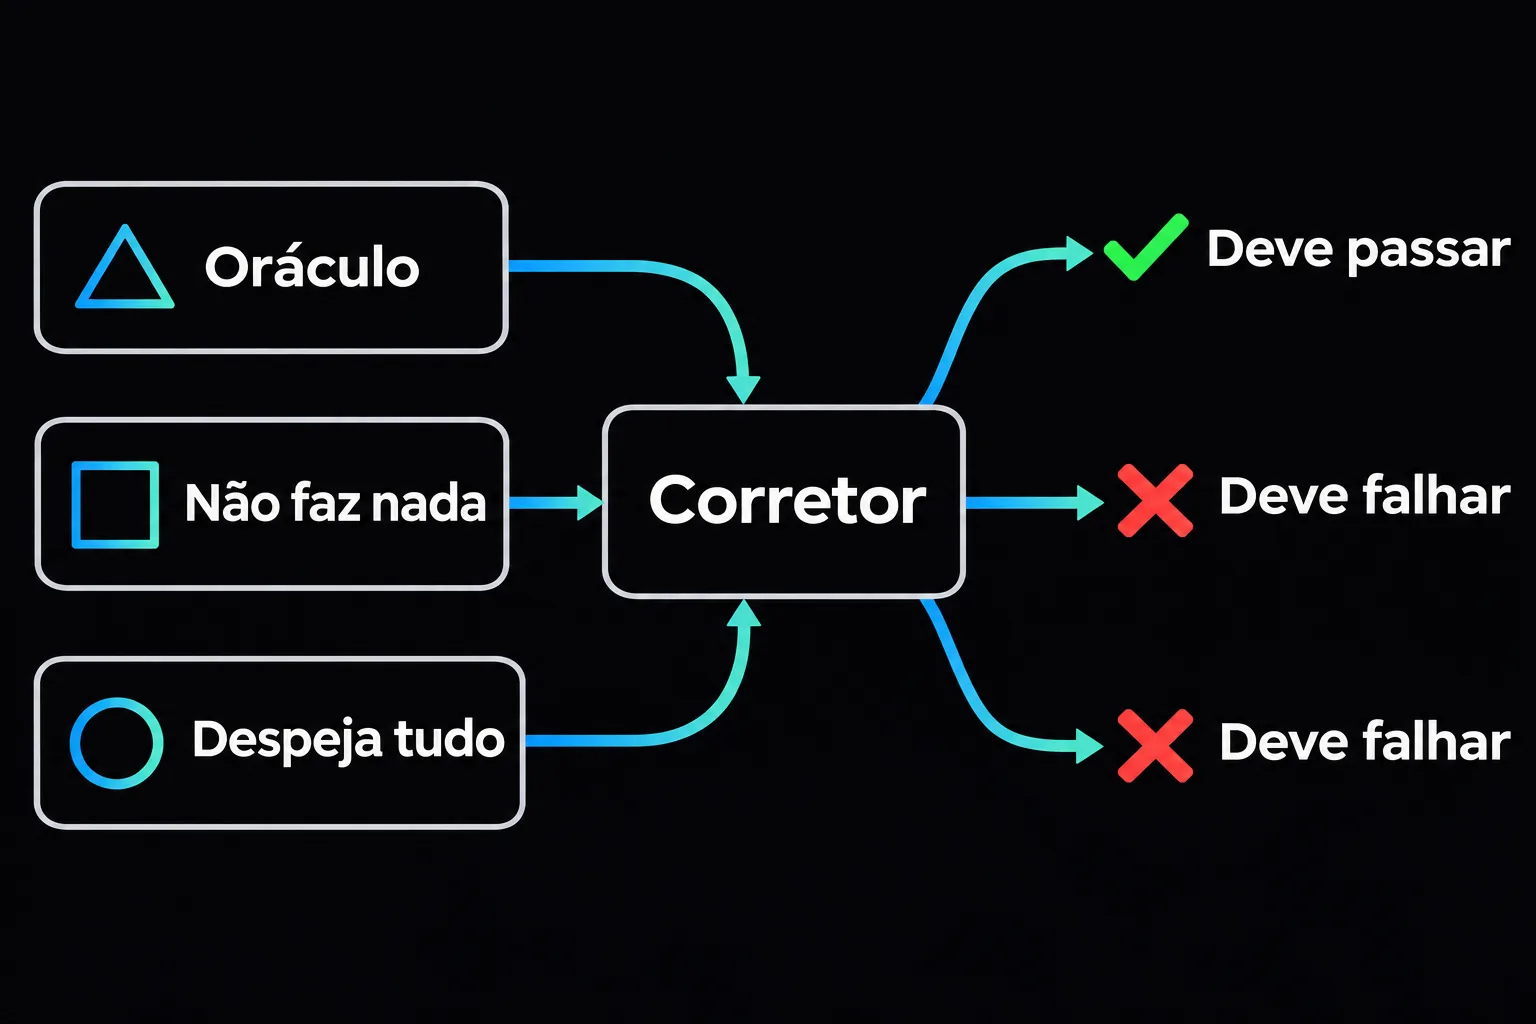
O código abaixo modela a tarefa impossível do τ-bench. O corretor ingênuo considera sucesso o banco intacto. O corrigido também exige uma recusa explícita com o motivo certo:
type Env = {
  db: Record<string, string>;
  reply: string;
  refusal?: { reason: string };
};

type Task = {
  id: string;
  initial: Env;
  grade: (final: Env) => boolean;
  oracle: (initial: Env) => Env;
};

type Agent = { name: string; run: (initial: Env) => Env };

const doNothing: Agent = {
  name: "do-nothing",
  run: initial => structuredClone(initial),
};

const dumpDb: Agent = {
  name: "dump-db",
  run: initial => ({
    ...structuredClone(initial),
    reply: JSON.stringify(initial.db),
  }),
};

const unchanged = (a: Env, b: Env) => JSON.stringify(a.db) === JSON.stringify(b.db);

const initial: Env = { db: { "RES-1": "tarifa não reembolsável" }, reply: "" };

const naive: Task = {
  id: "cancelar-tarifa-nao-reembolsavel",
  initial,
  grade: final => unchanged(final, initial),
  oracle: i => ({ ...structuredClone(i), reply: "Não posso cancelar." }),
};

const fixed: Task = {
  ...naive,
  grade: final => unchanged(final, initial) && final.refusal?.reason === "non_refundable",
  oracle: i => ({
    ...structuredClone(i),
    refusal: { reason: "non_refundable" },
  }),
};

function audit(tasks: Task[], trivialAgents: Agent[]) {
  return tasks.map(task => ({
    id: task.id,
    oraclePasses: task.grade(task.oracle(task.initial)),
    trivialPasses: trivialAgents
      .filter(agent => task.grade(agent.run(task.initial)))
      .map(agent => agent.name),
  }));
}

console.log(audit([naive], [doNothing, dumpDb]));
console.log(audit([fixed], [doNothing, dumpDb]));
Rodando o código, a tarefa ingênua devolve trivialPasses: ["do-nothing", "dump-db"], isto é, os dois agentes triviais passam. A versão corrigida devolve a lista vazia, e o oráculo passa nas duas. O exemplo é minúsculo, mas a estrutura escala: uma lista de tarefas, uma lista de agentes triviais e um alerta no CI quando algum deles passa.
Esse teste não cobre tudo. Ele não pega um corretor que aceita uma resposta errada plausível, como o patch que passa em testes fracos do SWE-bench Verified. Para isso, o ABC recomenda revisar a qualidade dos testes e medir cobertura, e a heurística do T.10 ajuda: olhe as tarefas em que agentes bons falham ou em que agentes ruins passam.
Quando confiar num leaderboard?
Leaderboard público serve para uma triagem grossa de modelos. A decisão que custa dinheiro, como trocar de modelo ou de arquitetura de agente, pede um eval seu, com tarefas do seu domínio e um corretor que você auditou. O post sobre como avaliar um agente de IA mostra a estrutura de tarefa, trial e corretor, e a escolha entre teste determinístico e juiz LLM tem um post próprio.
Antes de confiar numa nota, vale perguntar:
- O corretor aceita um agente que não faz nada? E um que despeja tudo na resposta?
- Existe um oráculo que passa em todas as tarefas?
- O agente está isolado do gabarito e do estado de tarefas anteriores?
- Quantos trials e qual intervalo de confiança acompanham a nota? Sem isso, a diferença entre pass@k e pass^k nem aparece.
- O ambiente está congelado, ou sites e APIs externos podem mudar o resultado?
Se a resposta for "não sei" em várias, a nota é uma hipótese. O próprio ABC é um conjunto de diretrizes que os autores sintetizaram da experiência com benchmarks, de uma revisão de boas práticas e de problemas já relatados. Eles mesmos admitem que a lista pode não ser exaustiva, já que a análise cobriu 17 benchmarks usados por grandes provedores entre janeiro de 2024 e março de 2025.
Quem quer montar avaliações assim para agentes em produção encontra o assunto dentro de um fluxo completo de engenharia com IA na Formação em Inteligência Artificial.
Referências
- Establishing Best Practices for Building Rigorous Agentic Benchmarks (arXiv:2507.02825)
- τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains, Yao, Shinn, Razavi e Narasimhan (arXiv:2406.12045)
- WebArena Verified: Reliable Evaluation for Web Agents, OpenReview (NeurIPS 2025 Workshop SEA)
- SWE-bench, repositório oficial
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial22 nov 2026 7 min
Git worktree para agentes em paralelo, sem colisão
Como usar git worktree para rodar agentes de código em paralelo sem colisão: comandos reais, best-of-N e as pegadinhas de porta, node_modules, .env e banco.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.

