Compactação de contexto em agentes: o que cortar
A compactação de contexto de um agente costuma começar pelo lugar errado: resumir a conversa, quando boa parte dos tokens veio de resultados de ferramentas que o modelo já leu e não precisa ver de novo. Resumir custa uma chamada ao modelo e pode apagar uma decisão importante. Descartar um resultado antigo de busca não custa chamada nenhuma.
O post Por que mais contexto pode piorar o agente explica por que uma janela cheia degrada o resultado. Aqui o assunto é o que cortar, em que ordem e com que orçamento.
Por que começar pelos resultados de tool?
Cada volta do laço do agente devolve para a janela a saída da ferramenta que acabou de rodar: um arquivo inteiro, uma lista de resultados de busca, a resposta de uma API. O post da LangChain sobre context engineering, de julho de 2025, descreve o efeito: tarefas longas e o feedback acumulado das ferramentas fazem o agente usar muitos tokens, com risco de estourar a janela, encarecer, ficar lento ou errar mais.
Em produção, a Dropbox notou que a precisão do Dash piorava em tarefas mais longas porque as chamadas de ferramenta acrescentavam muito contexto, um padrão que ela associou ao context rot. A engenharia do Slack conta que uma investigação de segurança feita por agentes pode chegar a centenas de requisições ao modelo e gerar megabytes de saída.
Nenhuma dessas fontes mede quanto da janela os resultados de tool ocupam. O argumento para começar por eles vem de uma pergunta da Anthropic, no texto sobre context engineering: se a ferramenta foi chamada lá atrás no histórico, por que o agente precisaria ver o resultado bruto de novo? Para ela, limpar resultados de ferramentas é uma das formas mais seguras e leves de compactação.
Como compactar resultados de ferramentas?
Há três técnicas, e elas se combinam.
A primeira é limpar o que ficou velho. A API da Anthropic tem a estratégia clear_tool_uses_20250919, em beta, ativada pelo header context-management-2025-06-27. Passado um limiar, ela troca os resultados mais antigos por um texto avisando o modelo da remoção. A edição acontece no servidor, e o seu cliente continua com o histórico completo. Sem configuração, o padrão é disparar em 100 mil tokens de entrada e manter as 3 chamadas mais recentes; o exemplo avançado da documentação dispara em 30 mil e usa clear_at_least de 5 mil. Esse último parâmetro existe porque limpar invalida o cache do prompt: se a API não consegue liberar ao menos aquela quantidade, ela não limpa. A documentação avisa que, na maioria dos casos, a compactação no servidor é a estratégia principal, e a limpeza serve a quem quer controle fino.
A segunda é tirar o resultado da janela sem perdê-lo. A biblioteca ctx-zip, para o AI SDK, grava saídas grandes num sandbox, troca o conteúdo na conversa por uma referência curta e dá ao agente ferramentas para explorar esse sandbox (sandbox_ls, sandbox_cat, sandbox_grep). O README fala em redução de 60% a 90% dos tokens em conversas pesadas em ferramentas. É a alegação do autor, não uma medição independente.
A versão mínima cabe em poucas linhas. O texto que fica na conversa precisa dizer o que foi guardado e como ler, senão o agente não sabe que existe algo para buscar:
type ToolResult = { callId: string; tool: string; content: string };

// Heurística grosseira, cerca de 4 caracteres por token. Em produção, use o contador do provedor.
const estimateTokens = (text: string) => Math.ceil(text.length / 4);

const store = new Map<string, string>(); // troque por disco ou sandbox

function offloadIfLarge(result: ToolResult, maxTokens = 2_000): ToolResult {
  const size = estimateTokens(result.content);
  if (size <= maxTokens) return result;

  const key = `${result.tool}/${result.callId}`;
  store.set(key, result.content);
  return {
    ...result,
    content: [
      `Resultado de ${result.tool} guardado em "${key}" (~${size} tokens).`,
      `Início: ${result.content.slice(0, 400)}`,
      `Use read_stored_result(key, offset) para ler outros trechos.`,
    ].join("\n"),
  };
}

// Implementação da ferramenta read_stored_result exposta ao agente.
function readStoredResult(key: string, offset = 0, length = 8_000): string {
  return store.get(key)?.slice(offset, offset + length) ?? `Nada guardado em "${key}".`;
}
A terceira é resumir na borda da ferramenta, antes de o resultado entrar na conversa. A LangChain cita o open_deep_research, que passa as chamadas de busca, as mais pesadas, por um passo de sumarização. O resumo roda sobre um documento só, e não sobre a conversa inteira.
Cada uma cobra um preço diferente. Limpar não gasta chamada ao modelo, mas o agente deixa de ver o conteúdo e, com cache ativo, cada limpeza paga a reescrita do prefixo. Guardar fora preserva tudo, mas cada leitura é mais uma volta do laço, e o agente precisa decidir buscar. Resumir na borda gasta uma chamada por resultado e perde o que o resumo não captou.
Compactação de contexto: quando resumir o histórico?
Depois dos resultados, sobra o histórico. A Anthropic define compactação como pegar uma conversa perto do limite da janela, resumir o conteúdo e recomeçar com o resumo. No Claude Code, segundo o mesmo texto, o modelo preserva decisões de arquitetura, bugs não resolvidos e detalhes de implementação, descarta saídas de ferramenta redundantes e segue com o resumo mais os cinco arquivos acessados mais recentemente.
O risco é compactar demais e perder um detalhe cuja importância só aparece depois. Por isso a Anthropic recomenda ajustar o prompt de compactação em traces reais: primeiro maximizar a revocação, para nada relevante ficar de fora, e depois melhorar a precisão, tirando o que sobra. Acertar esse passo dá trabalho: a LangChain lembra que a Cognition usa um modelo ajustado só para resumir. O mesmo post diz que o auto-compact do Claude Code disparava acima de 95% da janela, um retrato de 2025 de um produto, não um limiar para copiar.
Uma regra que não vem das fontes: no resumo, identificadores exatos sobrevivem e a narrativa pode encolher. Um caminho de arquivo, um id ou uma mensagem de erro reescritos com outras palavras deixam de funcionar quando o agente tenta usá-los.
Há também a saída radical. O Slack não carrega histórico de mensagens entre as invocações dos agentes, que recebem canais curados: o diário do orquestrador, a revisão do crítico e uma linha do tempo consolidada. Segundo a equipe, mesmo com janelas infinitas o histórico acumulado poderia atrapalhar a reação a informação nova. Isso cabe num pipeline em fases com papéis fixos, não num assistente em que o usuário espera ser lembrado.
E a janela deslizante?
A janela deslizante é a compactação mais simples: manter as N unidades mais recentes e descartar o resto. Serve quando só o recente importa, como na edição interativa de código, e perde o que um resumo teria preservado.
Duas armadilhas aparecem na implementação. Se o primeiro pedido do usuário sai da janela, o agente segue executando sem saber o que está construindo, então fixe essa mensagem. E se o corte separa uma chamada de ferramenta do seu resultado, a conversa fica inválida nas APIs de tool calling, que exigem o par. Tratar chamada e resultado como uma unidade só resolve isso por construção.
O código abaixo vai do mais barato ao mais caro: limpa resultados antigos e, se o orçamento ainda estourar, resume o miolo, mantendo a tarefa fixa e as unidades recentes. O summarize é injetado, então você escolhe o modelo:
type Unit =
  | { kind: "message"; role: "user" | "assistant"; text: string }
  | { kind: "tool"; name: string; args: string; result: string };

const total = (units: Unit[]) =>
  units.reduce(
    (sum, u) => sum + estimateTokens(u.kind === "message" ? u.text : u.args + u.result),
    0
  );

function clearOldToolResults(units: Unit[], keepLast = 3): Unit[] {
  let seen = 0;
  return units
    .slice()
    .reverse()
    .map(u =>
      u.kind === "tool" && ++seen > keepLast ? { ...u, result: "[resultado removido]" } : u
    )
    .reverse();
}

const SUMMARY_INSTRUCTION = `Resuma o trabalho abaixo. Copie literalmente caminhos, nomes de funções,
ids e mensagens de erro. Liste decisões, bugs em aberto e próximos passos.`;

type Summarize = (instruction: string, units: Unit[]) => Promise<string>;

async function compact(units: Unit[], budget: number, summarize: Summarize, keepRecent = 6) {
  const cleared = clearOldToolResults(units);
  if (total(cleared) <= budget) return cleared;

  const [task, ...rest] = cleared;
  const older = rest.slice(0, Math.max(0, rest.length - keepRecent));
  if (older.length === 0) return cleared;

  const summary = await summarize(SUMMARY_INSTRUCTION, older);
  const summaryUnit: Unit = {
    kind: "message",
    role: "assistant",
    text: `Resumo até aqui:\n${summary}`,
  };
  return [task, summaryUnit, ...rest.slice(older.length)];
}
Como montar o orçamento por camada?
Um limite único para a janela inteira esconde quem está estourando. É mais útil dar um orçamento a cada camada: instruções do sistema, definições de ferramentas, regras do projeto, histórico e resultados de ferramentas. Camadas fixas e dinâmicas pedem tratamento diferente, e a Dropbox mostra por quê: as definições de ferramentas consomem muitos tokens, e dar ao modelo uma ferramenta de busca por app conectado levou a decisões mais lentas e menos precisas. A saída foi trocar todas por uma única ferramenta sobre o índice unificado do Dash.
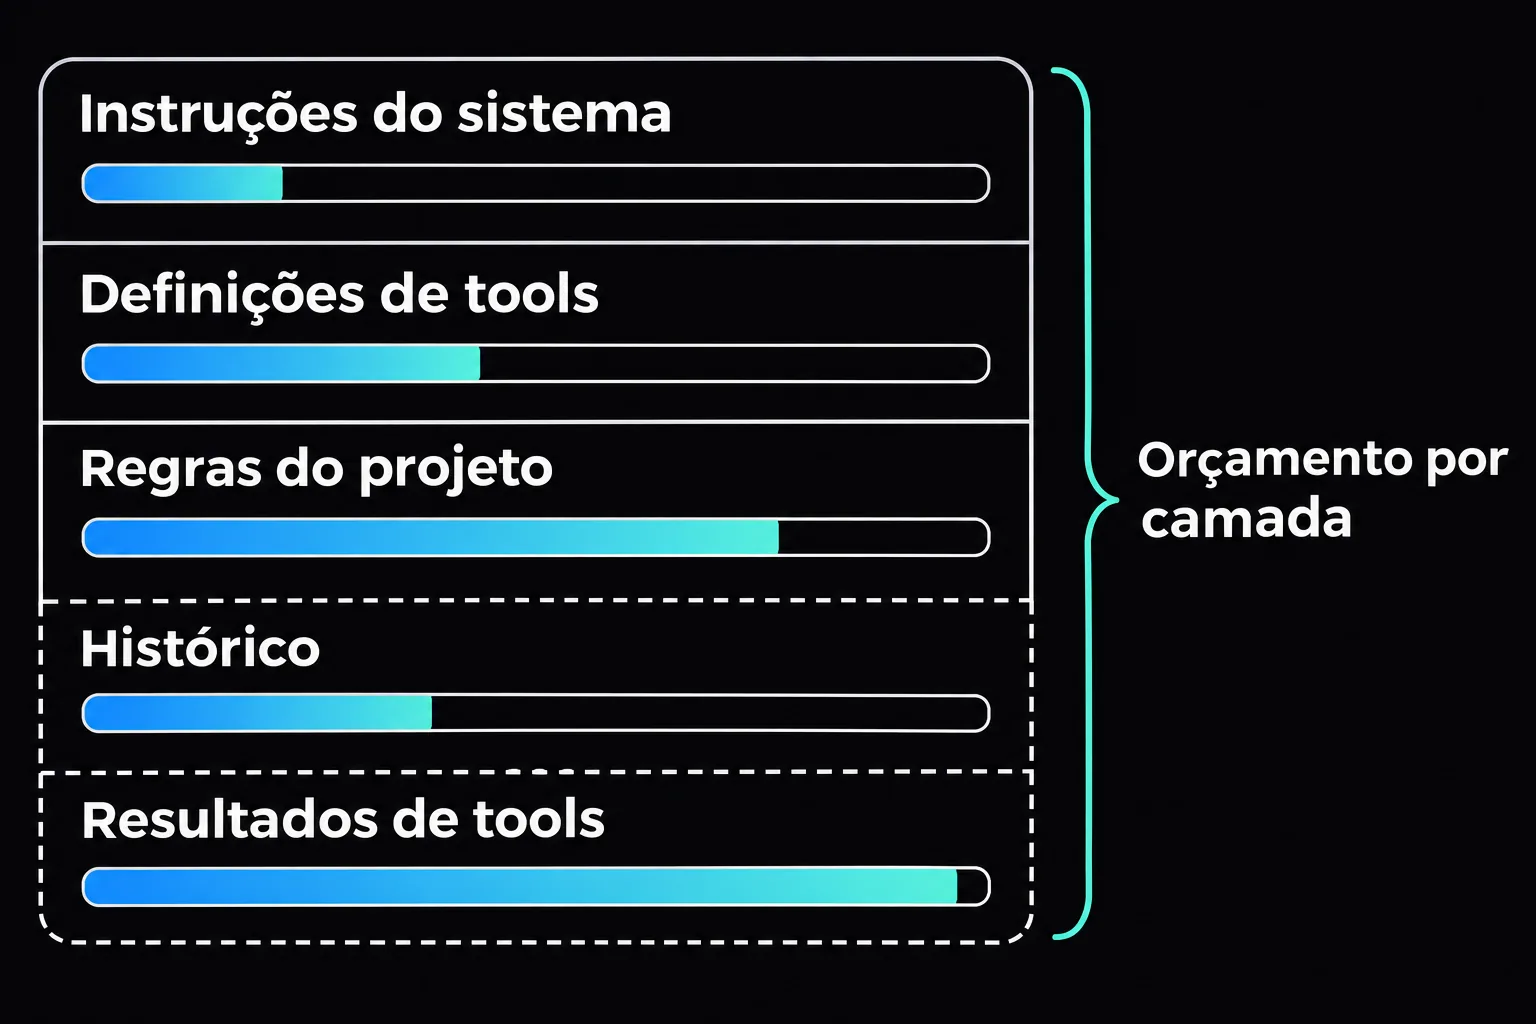
Esse corte não se resolve com um resumo: alguém precisa remover um servidor ou enxugar descrições. O código separa o que o sistema compacta sozinho do que precisa de uma pessoa. Os números são ilustrativos:
type Layer = "system" | "toolDefinitions" | "rules" | "history" | "toolResults";
type Budget = Record<Layer, number>;

const budget: Budget = {
  system: 4_000,
  toolDefinitions: 6_000,
  rules: 3_000,
  history: 25_000,
  toolResults: 20_000,
};

// Do corte mais barato ao mais arriscado.
const COMPACTION_ORDER: Layer[] = ["toolResults", "history"];

function plan(usage: Budget, limits: Budget) {
  const over = (Object.keys(limits) as Layer[]).filter(layer => usage[layer] > limits[layer]);
  return {
    compact: COMPACTION_ORDER.filter(layer => over.includes(layer)),
    needsHumanDecision: over.filter(layer => !COMPACTION_ORDER.includes(layer)),
  };
}

plan(
  { system: 3_800, toolDefinitions: 9_000, rules: 2_000, history: 31_000, toolResults: 24_000 },
  budget
);
// { compact: ["toolResults", "history"], needsHumanDecision: ["toolDefinitions"] }
Para saber se os cortes ajudam, a LangChain recomenda acompanhar o uso de tokens do agente e ter um jeito simples de testar se a engenharia de contexto melhora ou piora o desempenho. O que foi cortado só faz falta em alguma tarefa específica, e o post sobre como avaliar um agente de IA mostra como montar esse teste.
Quando não compactar?
Em tarefas que terminam muito antes de a janela encher, a compactação só adiciona código e risco. Quando o agente precisa de um valor exato de um resultado antigo, limpar ou resumir o trecho cria o erro que você queria evitar; guardar fora com leitura sob demanda é mais seguro.
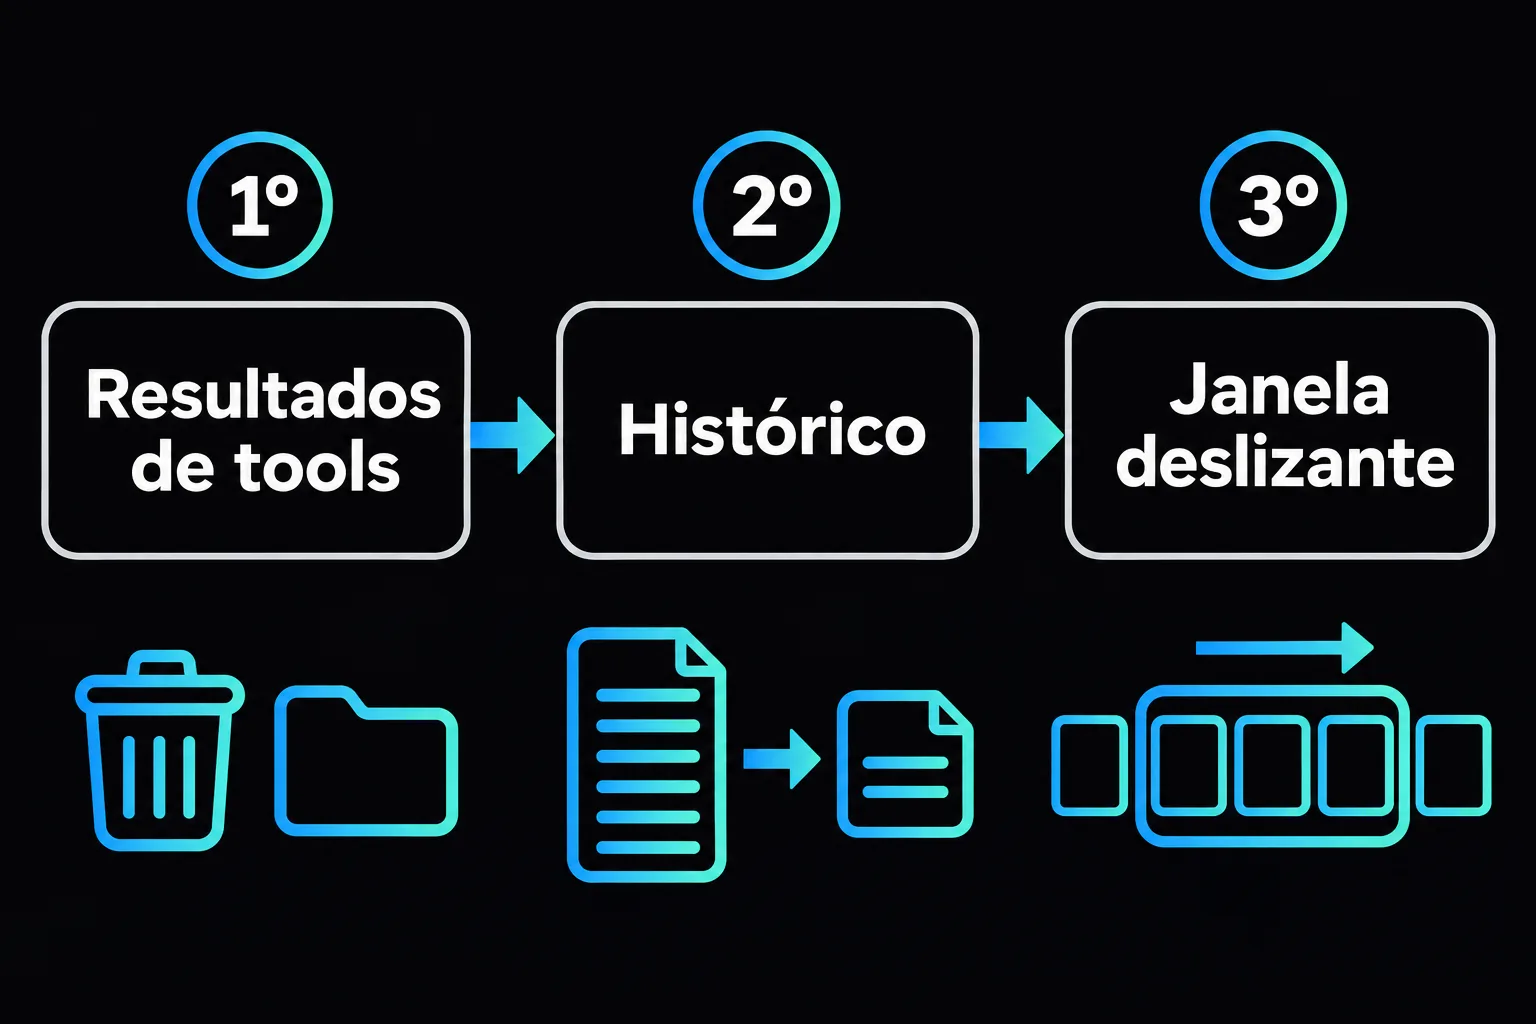
Fora desses casos, a ordem é limpar ou guardar fora os resultados de ferramentas, depois resumir o histórico preservando identificadores e, por último, cortar por janela. O que já ocupa a janela antes do primeiro pedido está em O que ocupa a janela de contexto de um agente. Para praticar essas decisões, a Formação em Inteligência Artificial trabalha esse caminho.
Referências
- Anthropic. Effective context engineering for AI agents. Set. 2025.
- Anthropic. Context editing. Documentação da Claude Developer Platform.
- LangChain. Context Engineering for Agents. Jul. 2025.
- Dropbox Tech. How Dash uses context engineering for smarter AI. Nov. 2025.
- Slack Engineering. Managing context in long-run agentic applications. Abr. 2026.
- karthikscale3. ctx-zip. Repositório no GitHub.
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.
- Inteligência Artificial20 nov 2026 7 min
Clustering de texto: embedding e LLM na zona cinzenta
Clustering de texto com embedding e cosseno, mandando só os pares ambíguos a um classificador LLM, e por que o centróide cria grupos gigantes.

