Zero falhas em 20 testes: o limite da amostra pequena
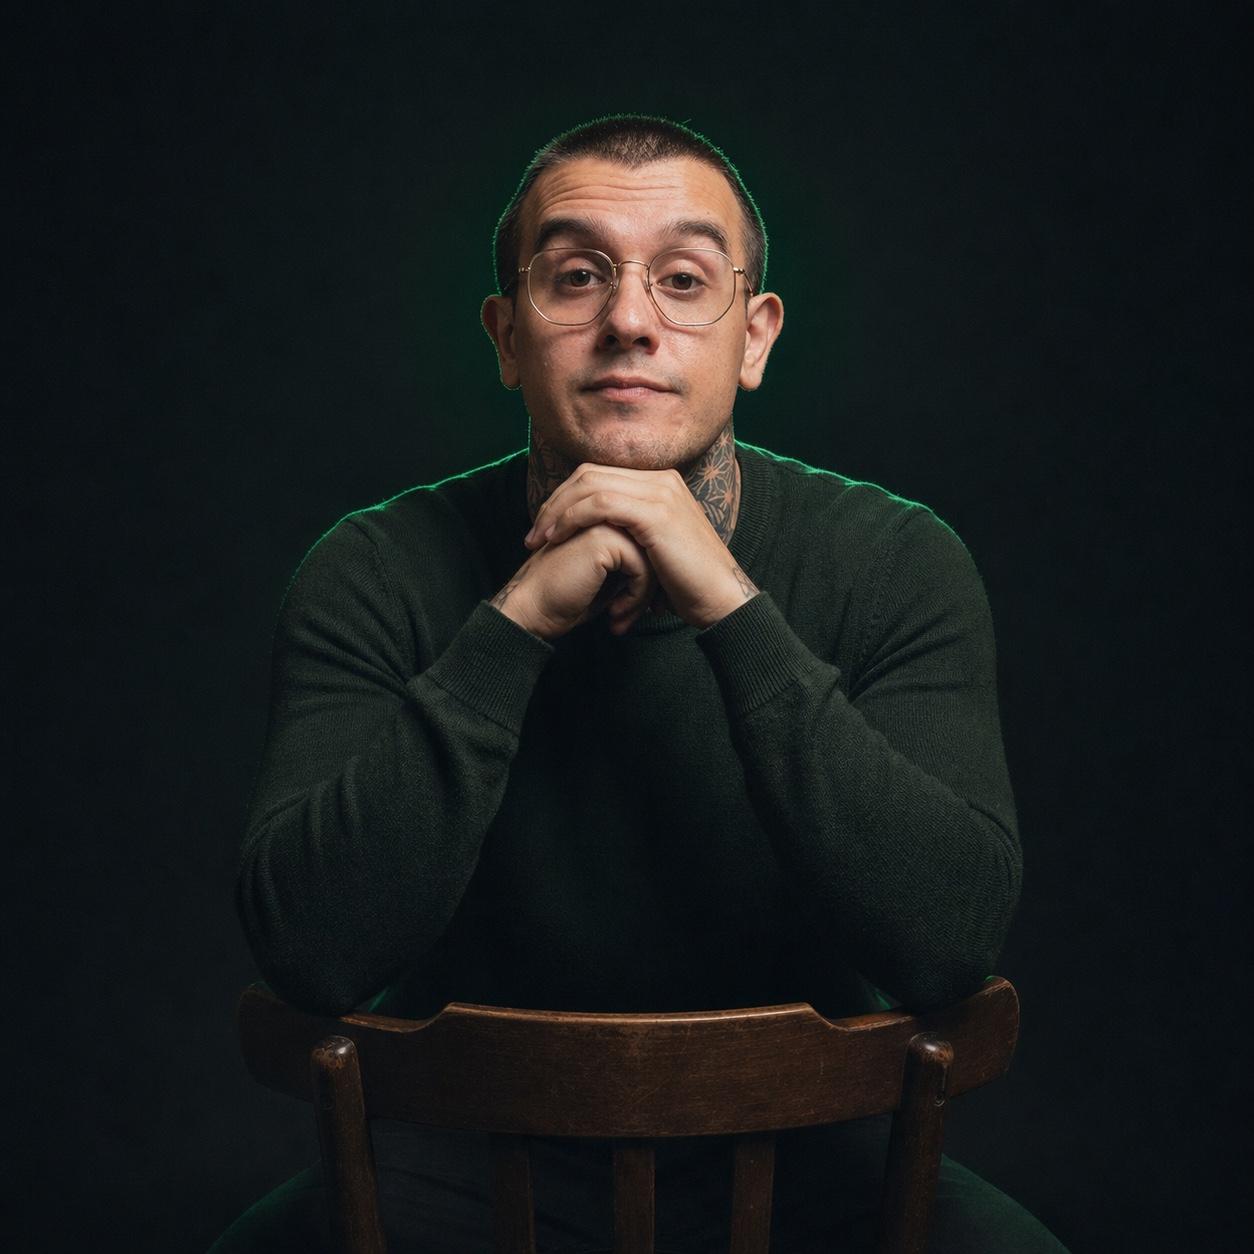
Zero falhas em 20 testes parece um resultado limpo, mas diz pouco sobre a taxa de erro real. Um agente, um prompt ou um filtro de segurança que passa em todos os 20 casos de um conjunto de avaliação ainda pode falhar em mais de 1 a cada 8 usos em produção. A conta que mostra isso cabe em uma linha, e vale a pena entender de onde ela vem antes de escrever "sem falhas" em um relatório.
O que zero falhas em 20 testes realmente prova?
Parta de uma suposição: cada caso é uma tentativa independente, e o sistema falha com probabilidade p em cada uma. Se p fosse 10%, a chance de passar nos 20 casos sem nenhuma falha seria 0,9 elevado a 20, cerca de 12%. Não é um evento raro: acontece uma vez a cada oito rodadas de avaliação.
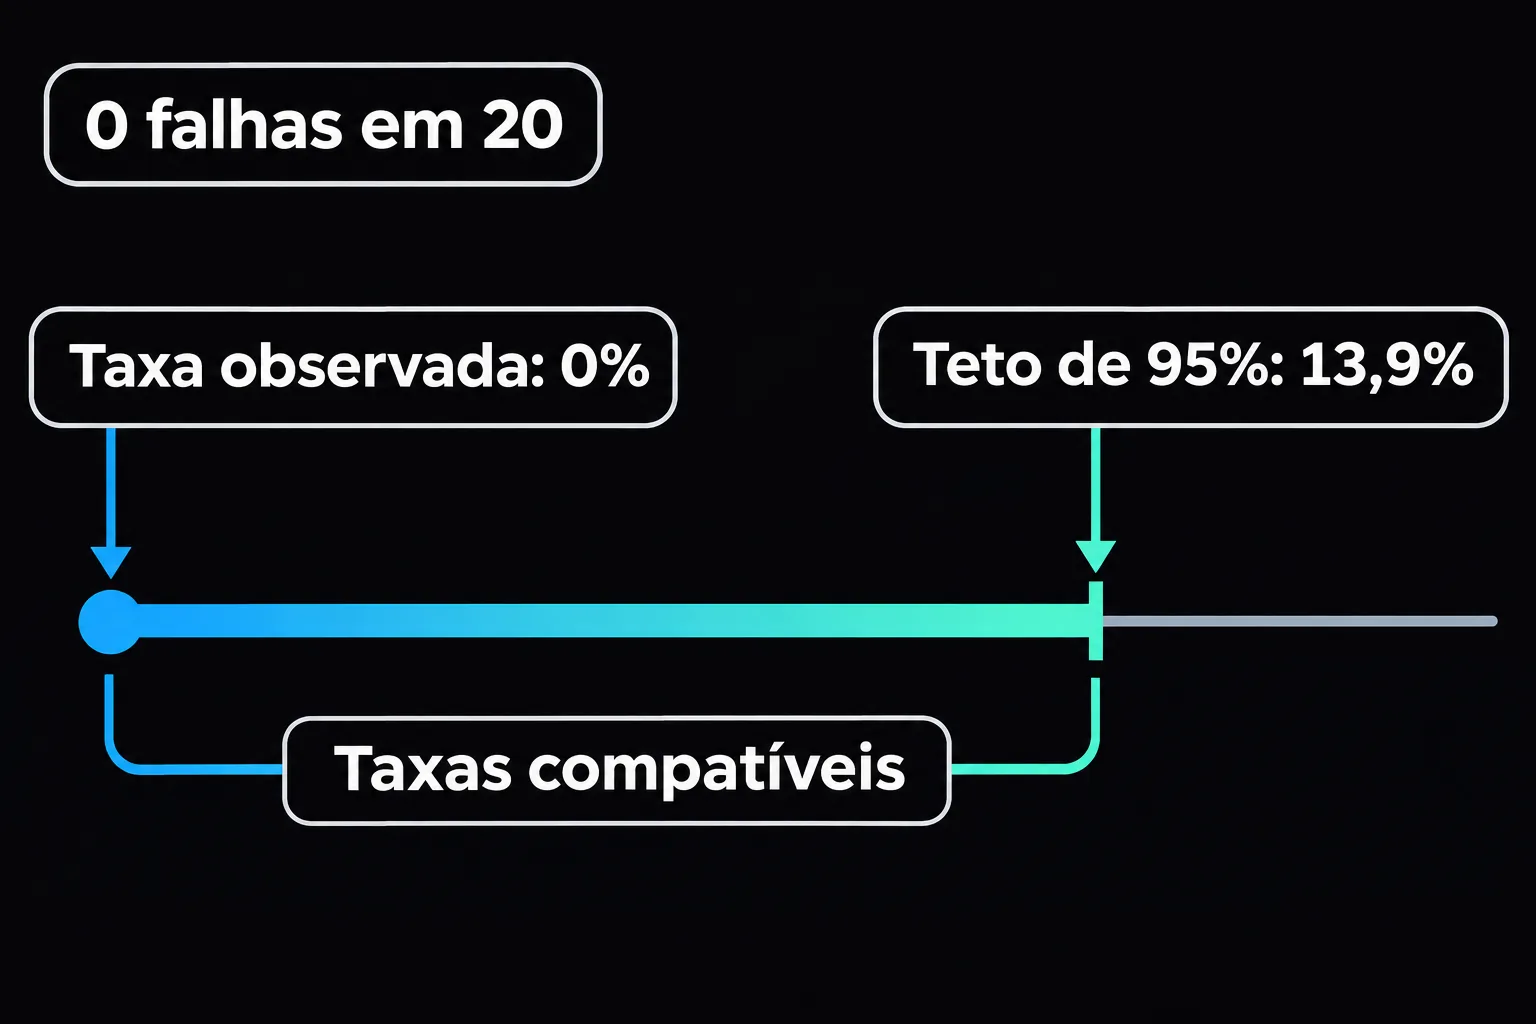
Isso inverte a pergunta. Em vez de perguntar "qual é a taxa de erro do sistema?", pergunte "qual a maior taxa de erro que ainda torna esse resultado plausível?". Esse é o raciocínio do artigo de Hanley e Lippman-Hand, publicado no JAMA em 1983 sob o título "If Nothing Goes Wrong, Is Everything All Right?". Os autores defendem três pontos: um numerador zero não significa risco zero, ele não impede inferir o tamanho do risco, e os princípios de inferência valem tanto para zero quanto para qualquer outro numerador.
O critério de "plausível" é a convenção de 5%: se o resultado observado tinha pelo menos 5% de chance de acontecer sob um dado valor de p, esse valor não é descartado. O maior p que passa nesse teste é o limite superior unilateral de 95%.
Como calcular o limite superior exato?
Com zero falhas em n tentativas, a probabilidade do resultado observado é (1 − p)^n. O limite superior é o p que faz essa probabilidade cair exatamente a 5%:
(1 - p)^n = 0,05
p = 1 - 0,05^(1/n)
Para n = 20, dá 13,9%. A página "Evaluation and Calibrated Judges", da base de pesquisa usada neste post, registra a mesma conta com o rótulo completo: limite superior exato unilateral de 95%, sob a hipótese de tentativas Bernoulli independentes. Segundo Jovanovic e Levy, num artigo de 1997 na The American Statistician, esse é o caso particular com x = 0 do limite de Clopper-Pearson. O limite geral para x falhas é o p que resolve a soma das probabilidades binomiais de 0 até x falhas igualada a 5%.
Hanley e Lippman-Hand chamam a faixa de zero até esse teto de intervalo de confiança de 95%, e a cobertura é mesmo de 95%, porque o piso está fixo em zero e os 5% de erro ficam todos do lado de cima. O intervalo bilateral de Clopper-Pearson, que divide os 5% em 2,5% de cada lado, tem teto maior: para 20 casos sem falha, 16,8%. Na hora de comparar números entre relatórios, confira qual dos dois rótulos cada um usa.
O código abaixo calcula as duas versões. A primeira soma a distribuição binomial e encontra o limite por bisseção, funcionando para qualquer número de falhas. A segunda usa a forma fechada do caso x = 0.
function binomialCdf(x: number, n: number, p: number): number {
  // P(X <= x) para X ~ Binomial(n, p), somando termo a termo
  let soma = 0;
  let termo = Math.pow(1 - p, n); // P(X = 0)
  for (let k = 0; k <= x; k++) {
    soma += termo;
    termo *= ((n - k) / (k + 1)) * (p / (1 - p));
  }
  return soma;
}

/** Maior p ainda compatível com x falhas em n: P(X <= x | p) = alpha. */
export function limiteSuperior(x: number, n: number, alpha = 0.05): number {
  let baixo = 0;
  let alto = 1 - 1e-12;
  for (let i = 0; i < 200; i++) {
    const meio = (baixo + alto) / 2;
    if (binomialCdf(x, n, meio) > alpha) baixo = meio;
    else alto = meio;
  }
  return (baixo + alto) / 2;
}

/** Caso x = 0: a equação (1 - p)^n = alpha tem solução fechada. */
export function limiteZeroFalhas(n: number, alpha = 0.05): number {
  return 1 - Math.pow(alpha, 1 / n);
}
A função binomialCdf é decrescente em p, então a bisseção converge: se a probabilidade ainda está acima de 5%, o limite está mais à direita. Rodando limiteSuperior(0, 20) e limiteZeroFalhas(20), as duas devolvem o mesmo valor. Para uma falha em 20 casos, limiteSuperior(1, 20) dá 21,6%, e para duas falhas, 28,3%.
O que é a regra de três?
Fazer essa conta de cabeça é inviável, então existe um atalho. Hanley e Lippman-Hand descrevem a regra de três, de origem desconhecida segundo os próprios autores: se nenhum de n casos mostra o evento, o limite superior de 95% da taxa é aproximadamente 3/n. Jovanovic e Levy explicam por que o 3 aparece. Expandindo 0,05^(1/n) em série de Taylor e ficando só com o termo linear, o limite exato vira −ln(0,05)/n, e −ln(0,05) vale cerca de 2,996.
/** Regra de três: aproximação de 1 - 0,05^(1/n). */
export function regraDeTres(n: number): number {
  return 3 / n;
}

/** Menor n para garantir, com zero falhas, que a taxa fique abaixo de p0. */
export function amostraNecessaria(p0: number, alpha = 0.05): number {
  return Math.ceil(Math.log(alpha) / Math.log(1 - p0));
}

const pct = (v: number) => `${(v * 100).toFixed(1)}%`;

for (const n of [5, 10, 20, 30, 50, 100, 300]) {
  console.log(
    `n=${n}`.padEnd(7),
    "exato",
    pct(limiteZeroFalhas(n)).padStart(6),
    "| bisseção",
    pct(limiteSuperior(0, n)).padStart(6),
    "| 3/n",
    pct(regraDeTres(n)).padStart(6)
  );
}
Resumindo a saída desse laço, rodado com Bun (as colunas do cálculo exato e da bisseção saem iguais em todas as linhas):
| n | limite exato | regra de três (3/n) |
|---|---|---|
| 5 | 45,1% | 60,0% |
| 10 | 25,9% | 30,0% |
| 20 | 13,9% | 15,0% |
| 30 | 9,5% | 10,0% |
| 50 | 5,8% | 6,0% |
| 100 | 3,0% | 3,0% |
| 300 | 1,0% | 1,0% |
A regra superestima o risco em amostras pequenas e converge para o valor exato conforme n cresce. Hanley e Lippman-Hand observam o mesmo: abaixo de 30 casos ela exagera um pouco, mas nesse ponto o risco máximo já é tão alto (26% para n = 10, contra 30% da regra) que a diferença não costuma importar. Como a regra é conservadora, errar para o lado dela é seguro.
Quantos testes são necessários para provar uma meta?
Inverta a fórmula para planejar a avaliação. Para afirmar, com 95% de confiança e zero falhas, que a taxa de erro está abaixo de p0, o menor n satisfaz (1 − p0)^n ≤ 0,05. A função amostraNecessaria resolve isso, e os valores impressos são:
- meta de 10%: 29 casos sem nenhuma falha;
- meta de 5%: 59 casos;
- meta de 1%: 299 casos.
Jovanovic e Levy apontam o mesmo uso da regra: com p0 como meta, o menor tamanho de amostra é o primeiro inteiro acima de 3/p0. Para 1%, a regra pede 301 casos, e o cálculo exato, 299.
Repare no custo. Cada redução de uma ordem de grandeza na taxa que você quer garantir exige cerca de dez vezes mais casos. E essa conta vale para o resultado ideal, zero falhas. Se aparecer uma falha em 20, a proporção observada é de 5%, mas o teto vai para 21,6%.
Quando essa conta não vale?
A matemática só sustenta o número se as tentativas forem independentes e tiverem a mesma probabilidade de falha. A página da base de pesquisa que registra a conta faz essa ressalva: o cálculo é ilustrativo, e parágrafos correlacionados de uma mesma petição não satisfazem a hipótese de independência.
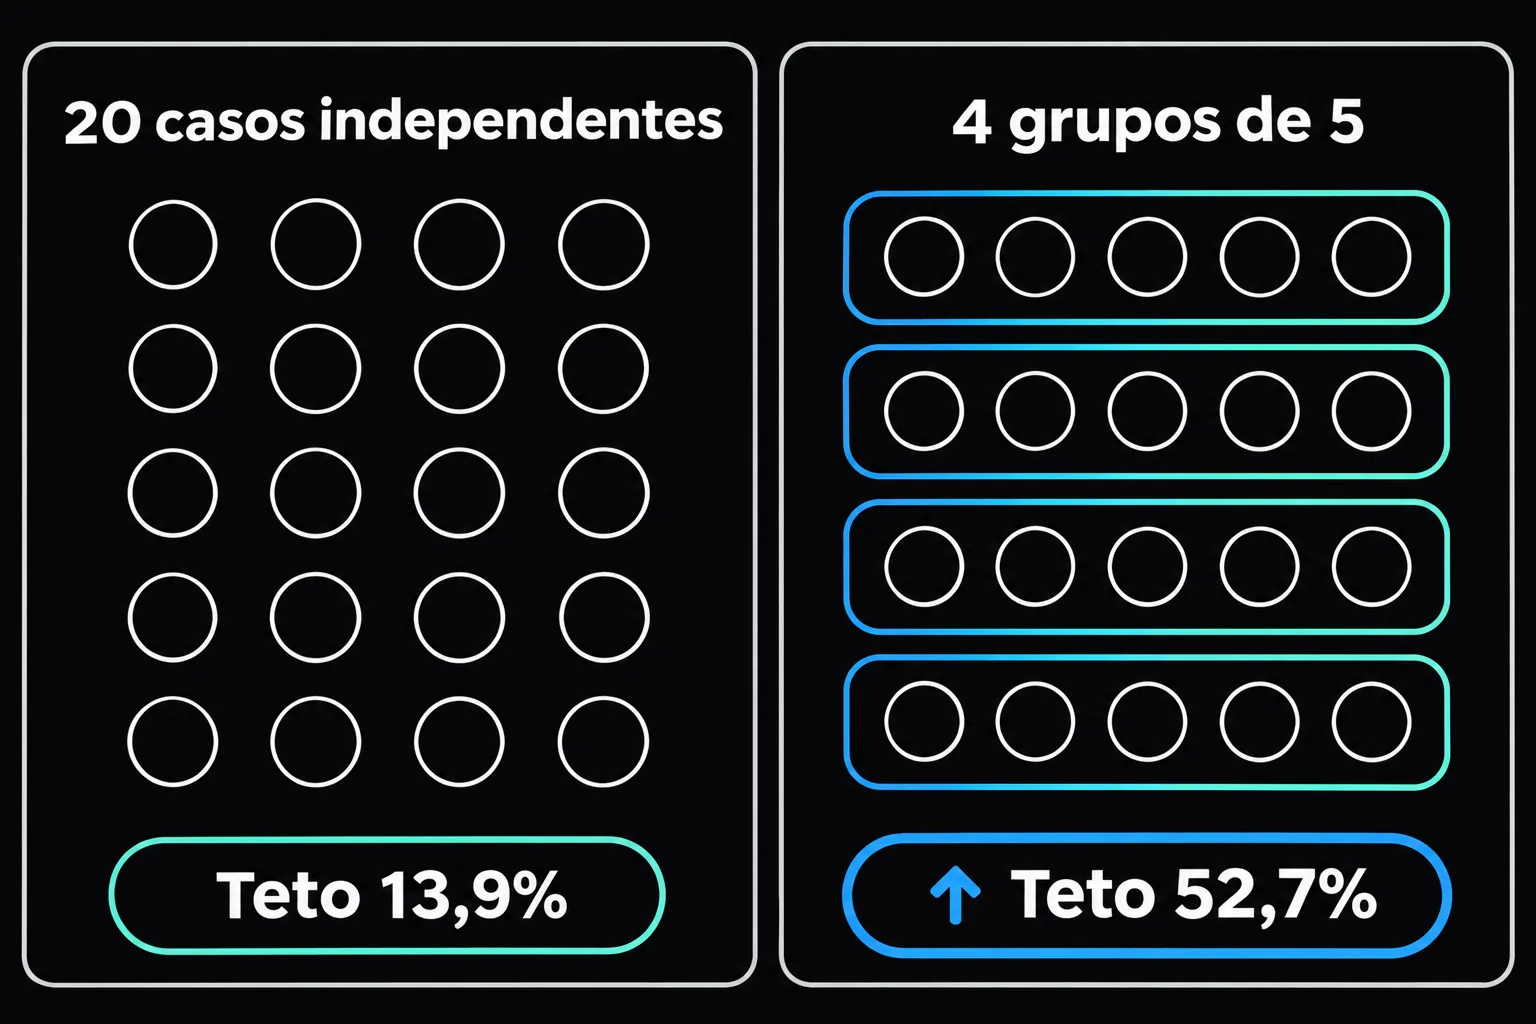
Um exemplo hipotético mostra o tamanho do efeito. Suponha 20 casos que, na prática, são 4 grupos de 5 variações do mesmo caso, e que cada grupo passa ou falha como um bloco. O tamanho efetivo da amostra é 4, não 20, e limiteZeroFalhas(4) dá 52,7%. O mesmo "20 de 20" passa a ser compatível com um sistema que falha em mais da metade das vezes.
Na prática de avaliação de agentes, isso aparece de formas conhecidas:
- casos gerados por template ou por LLM a partir de poucos exemplos tendem a ser variações do mesmo cenário;
- mais de um caso extraído do mesmo documento ou da mesma conversa compartilha a causa de falha;
- se o mesmo conjunto foi usado para ajustar prompts e depois para medir, ele deixou de ser amostra independente. A mesma página trata isso como regra: um holdout reutilizado para escolher outro limiar vira dado de desenvolvimento.
Existe ainda o erro de leitura oposto, que é tratar o teto como a taxa do sistema. A melhor estimativa pontual continua sendo 0%, e a taxa real provavelmente fica abaixo do teto. O que a conta impede é transformar "não vimos falha" em "a taxa é desprezível".
Como usar isso em avaliações de IA?
Quando um relatório de avaliação diz que um guardrail bloqueou 20 de 20 ataques, ou que um agente concluiu 20 de 20 tarefas, reescreva a frase com o limite: "0 falhas em 20 casos independentes; taxa de falha de até 13,9% é compatível com esse resultado, com 95% de confiança".
Para decidir o tamanho do conjunto antes de rodar, escolha a taxa de erro que você tolera e use amostraNecessaria. Se o orçamento só permite 20 casos, o que o resultado entrega é esse teto, e lançar vira uma escolha explícita de quanto risco aceitar. Para sistemas não determinísticos, combine isso com a medição por vários trials do mesmo caso, como no post sobre pass@k e pass^k, e confira se o seu conjunto de casos tem validade de tarefa e de resultado, porque independência e representatividade são condições do cálculo. Se a nota vier de um juiz LLM, o erro do juiz entra por cima desse intervalo, tema do post sobre escolher o grader.
Esses temas de avaliação, medição e confiabilidade de sistemas com IA são parte do que a Formação em Inteligência Artificial da Branas trabalha.
Referências
- Hanley, J. A. e Lippman-Hand, A. "If Nothing Goes Wrong, Is Everything All Right? Interpreting Zero Numerators". JAMA, v. 249, n. 13, 1983. Texto e resumo no JAMA Network.
- Jovanovic, B. D. e Levy, P. S. "A Look at the Rule of Three". The American Statistician, v. 51, n. 2, 1997. JSTOR.
- Wiki "Evaluation and Calibrated Judges", seção "What a small clean sample can establish", base de pesquisa verified-generation (sem URL pública).
Formação em Inteligência Artificial
Aprenda tudo, desde a criação de um processo de desenvolvimento, passando pela construção de aplicações até a automação de processos, tudo com inteligência artificial, do início ao fim.
Continue lendo.
- Inteligência Artificial22 nov 2026 7 min
Git worktree para agentes em paralelo, sem colisão
Como usar git worktree para rodar agentes de código em paralelo sem colisão: comandos reais, best-of-N e as pegadinhas de porta, node_modules, .env e banco.
- Inteligência Artificial21 nov 2026 8 min
Accessibility tree ou screenshot para agentes de IA
Accessibility tree ou screenshot? Veja as quatro formas de um agente de IA observar uma interface, onde cada uma falha e como combiná-las com um roteador.
- Inteligência Artificial21 nov 2026 7 min
Autocorreção de LLM: o verificador deve ser externo
Autocorreção de LLM em raciocínio piora a resposta sem feedback externo. Veja o que os papers mediram e como montar um loop gerar-verificar em TypeScript.

